在线AI教程 / AI工具
[OpenRouter] 我们如何重建 provider 路由,以获得更好、更快的推理
我们如何重建 provider 路由,以获得更好、更快的推理 Scott Morse ·10/28/2026 今天,我们宣布对 provider 路由算法的一次最大改进,这是 Op
我们如何重建 provider 路由,以获得更好、更快的推理
Scott Morse ·10/28/2026
今天,我们宣布对 provider 路由算法的一次最大改进,这是 OpenRouter 成立以来最大的一次。
过去,我们的默认路由器基本只奖励一件事:低价。新路由器奖励的,是对你来说真正最好的推理:既便宜,又快、高吞吐、可靠。提供更多价值的 provider 会自动赢得更多流量,于是每个 provider 都有理由继续改进。这意味着你通过 OpenRouter 得到的推理会越来越快、越来越可靠、越来越划算,而你不需要改动一行代码。
它已经在起作用了。新算法带来了显著改善:TTFT(16.9%)、throughput(16.3%)以及容量错误(降幅惊人的 67%!),代价只是成本小幅上升(6.0%)。而这还是在 provider 尚未有任何时间针对新算法做优化的情况下。更多细节请看我们的完整实验结果。
它是如何运作的:
它衡量你实际得到的东西。对每个模型,它跟踪各个 endpoint 的实际价格、latency、throughput 和错误率,并为每个请求挑选成本与性能的最佳组合。 它实时反应。当某个 endpoint 出问题时,流量会避开它,直到它恢复。 它奖励更好的推理。持续创新的 provider 会自动获得更多流量作为回报。
路由仍然是感知缓存的,所以一旦把你送到某个 provider,只要缓存还是热的,你的会话就会留在那里。
只想要按价格路由?你依然可以这样做。有关固定 provider 和为 provider 排序的说明,请看哪些东西保持不变。
我们从哪儿出发:只按价格路由的局限
OpenRouter 上的大部分流量(约占请求的 77%)流向那些由不止一个 provider 提供的模型。当一个请求没有指定排序方式或 provider 列表时,我们需要挑一个 provider 来处理。直到现在,我们几乎完全依据输入 token 价格来做这个选择。provider 越便宜,它分到的流量比例就越高;任何失败的请求都会被重新路由到下一个最便宜的选项。
这种只按价格的方式让用户拿到了生态里最低的价格,但也带来了一些非预期的后果:
即使很差,便宜也能赢。fallback 能兜住失败,但用户得先等着这些失败,而速度上的改进得不到任何回报。 静态排名。算法对实时性能波动视而不见,所以一个 provider 必须劣化到被彻底降级,才会体现在流量分配上。 利润空间不断消失。provider 赢得流量的唯一办法就是降价,这让它们有动力削减对那些恰恰保障可靠性与质量的基础设施的投入。 定价花招。我们用来排序的价格几乎只是 prompt 的输入价格,于是 provider 完全可以靠一些奇怪的定价组合保住流量份额,比如把输入价格标成人为的低价,再靠被抬高的缓存 token 或补全 token 价格把差额赚回来。
我们希望打造一个这样的市场:相互竞争的 provider 靠提供更好的推理、而不只是更便宜的推理来赢得流量。
新算法:为「一个好答案值多少」做优化
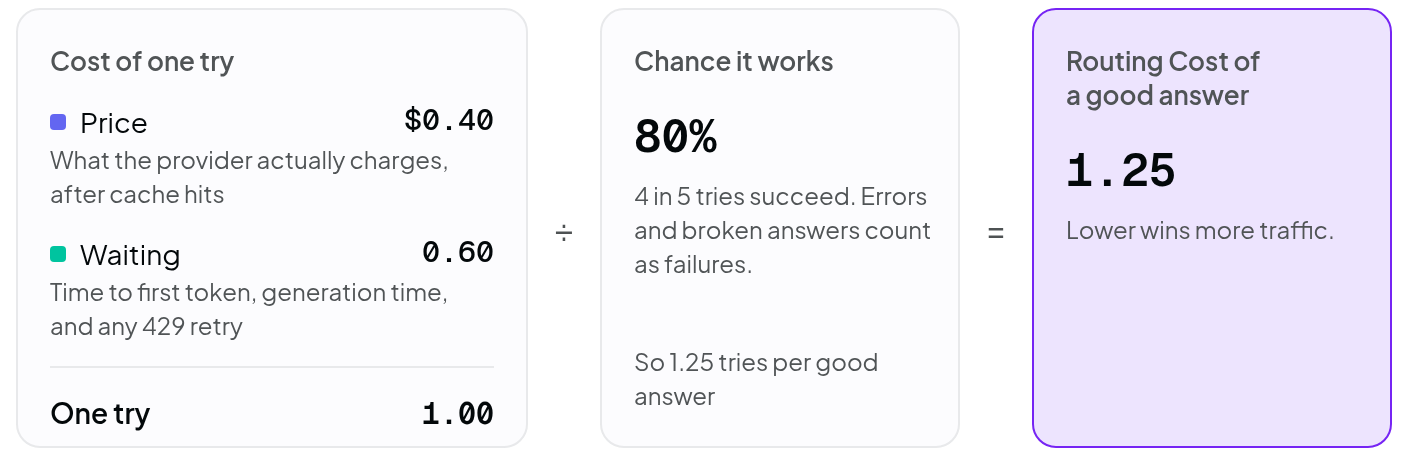
新的路由算法持续监控每个 provider 的表现,算出一个实时的 Routing Cost,用来刻画用户为「一个好答案」付出的代价。Routing Cost 包含:以实际美元和美分计价的价格、等待响应所花的时间成本,以及当 provider 失败或给出无法使用的响应时重试的成本。
简单地说:试一次要花多少钱,以及它有多大概率能成?
试一次的成本:价格加上等待
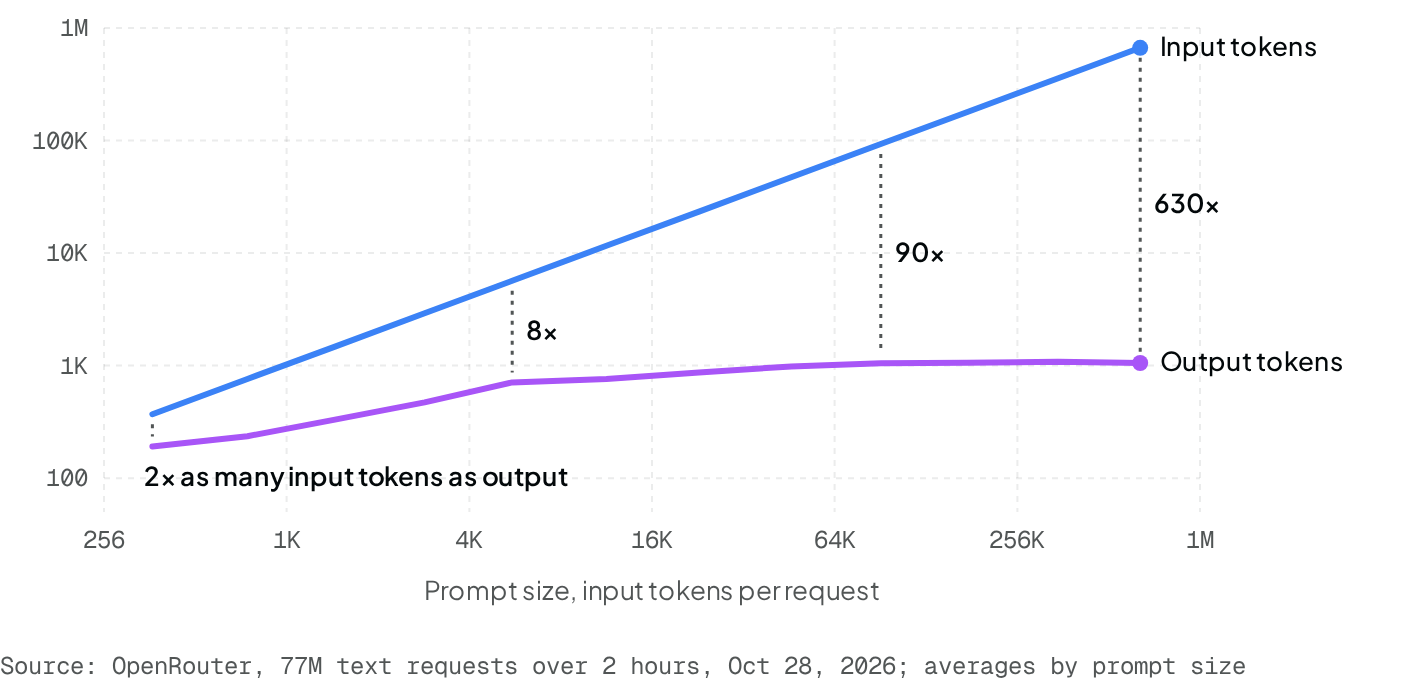
对每个请求,路由器会根据该模型最近的流量估算它会消耗多少输入和输出 tokens。这一项估算同时决定了「试一次」的两部分:你需要付的价格,以及你需要等的时间。
实际价格
实际价格是 provider 真正会向你收取的价格,由最近实测的流量算出。它反映了 provider 真实的缓存命中率,以及该模型输入与输出 tokens 的平均配比,因此可能与挂牌价相差很大。这确保了 provider 无法靠把昂贵的缓存 token 或输出 token 藏在低输入价格后面来赢流量。
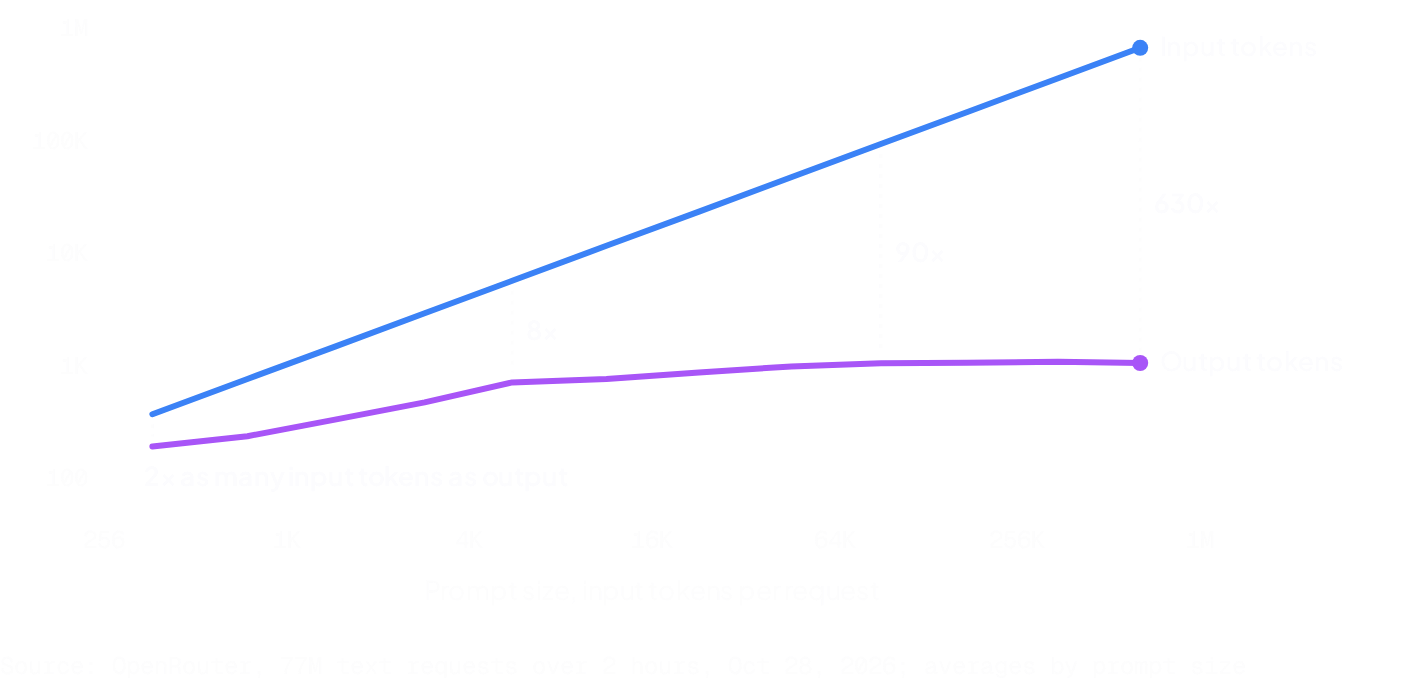
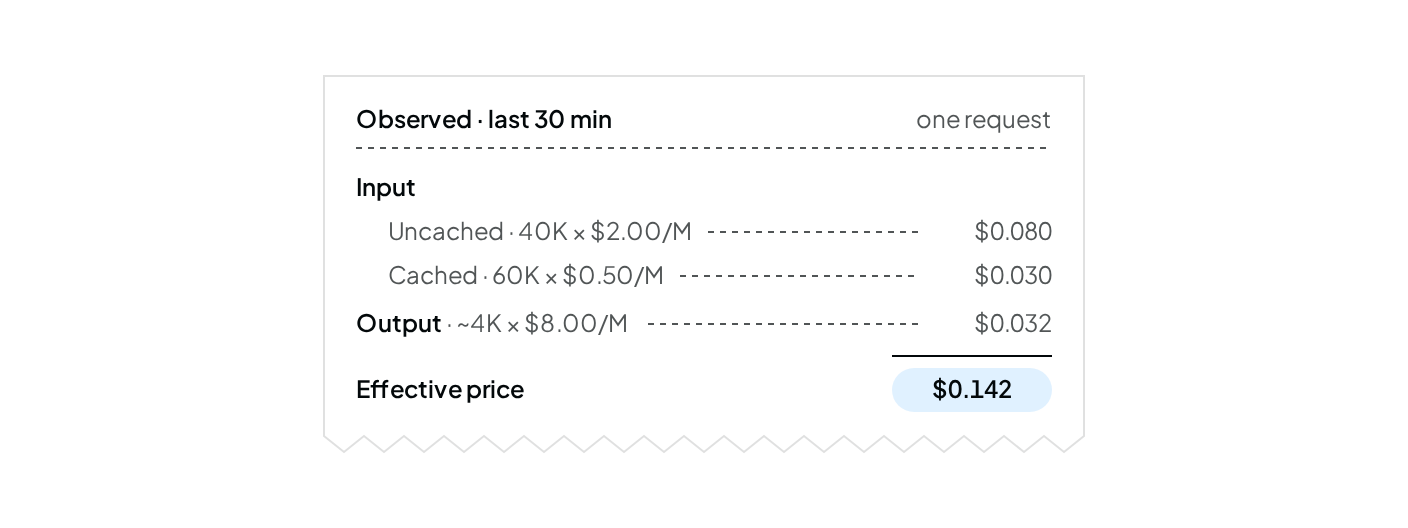
路由器按每个 provider 的实际价格为你的请求定价,并优先选择最便宜的选项。
Throughput
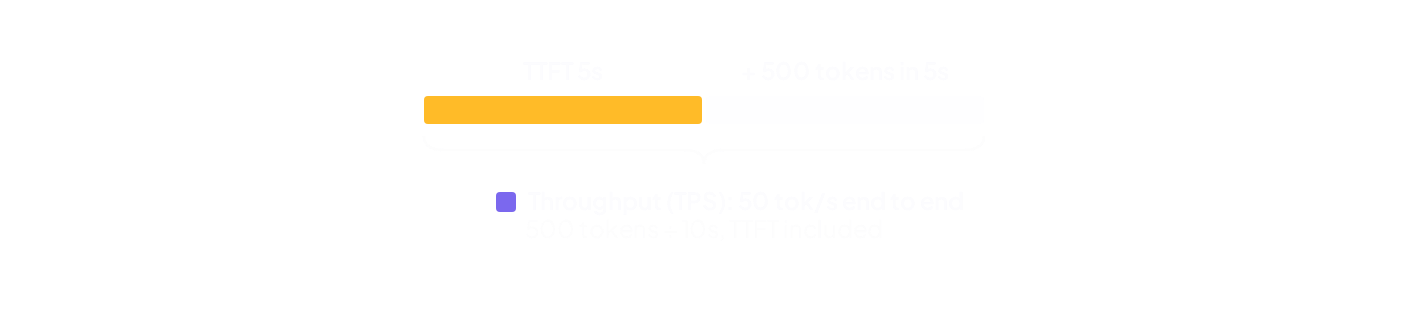
throughput 是与价格此消彼长的那个指标:更快的 provider 可以收更多钱,照样赢下你的请求。它以端到端的每秒输出 tokens 来衡量,因此既包含首 token 时间,也包含 provider 把整段输出响应流式传输完的时间。路由器按每个模型设定的换算系数,把这段等待时间加进 Routing Cost;该系数依据这些 provider 平常的收费和速度确定。
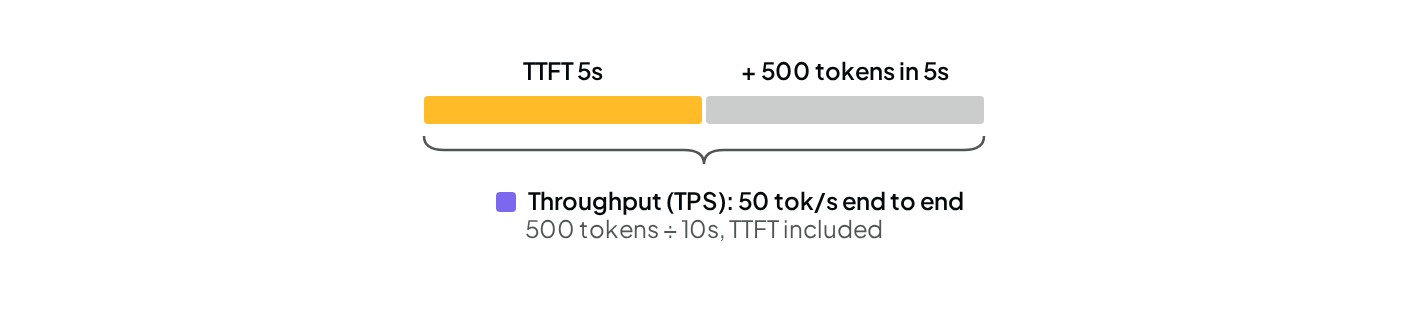
首 token 时间
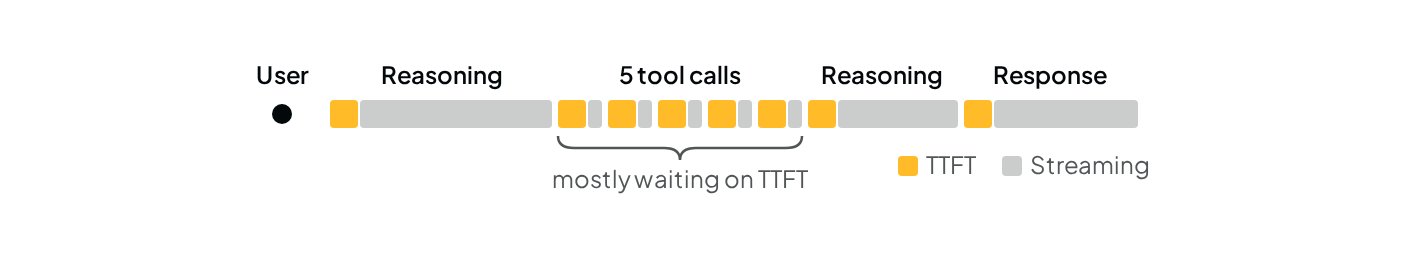
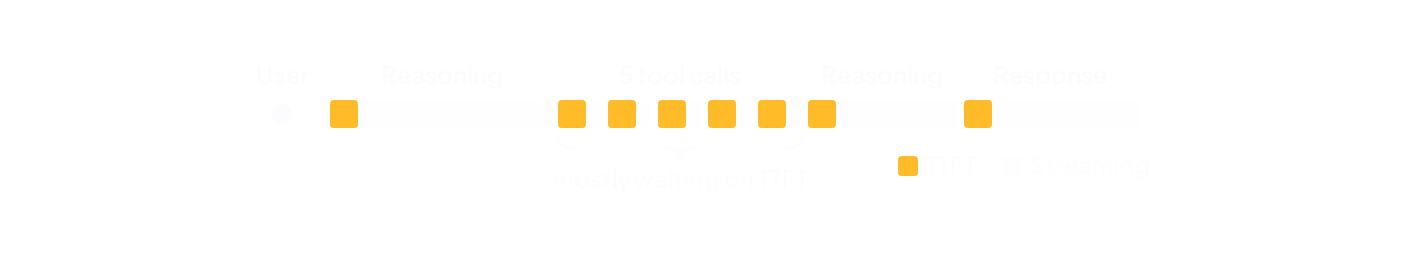
首 token 时间(TTFT)是你在响应开始流式输出前要等多久。它会单独计入 Routing Cost,虽然它本来就已算在 throughput 里,因为交互式使用最依赖它。在一个 agent 会话中,模型可能连续发起多次 tool calling,每一次都要等首个 token。
速率限制
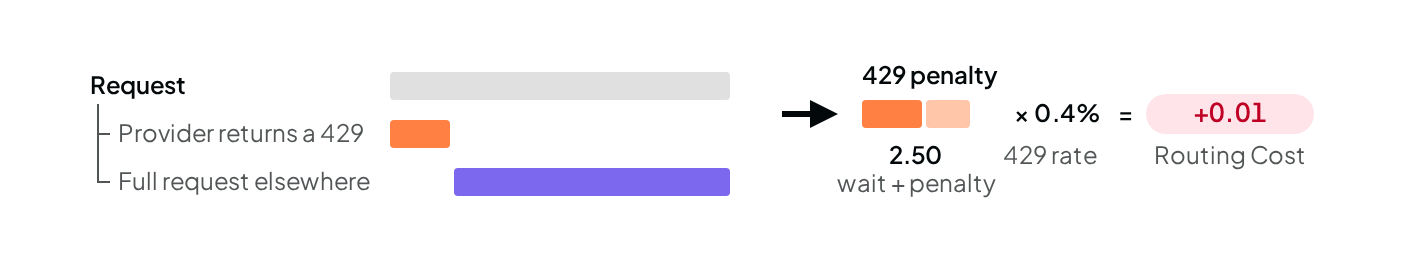
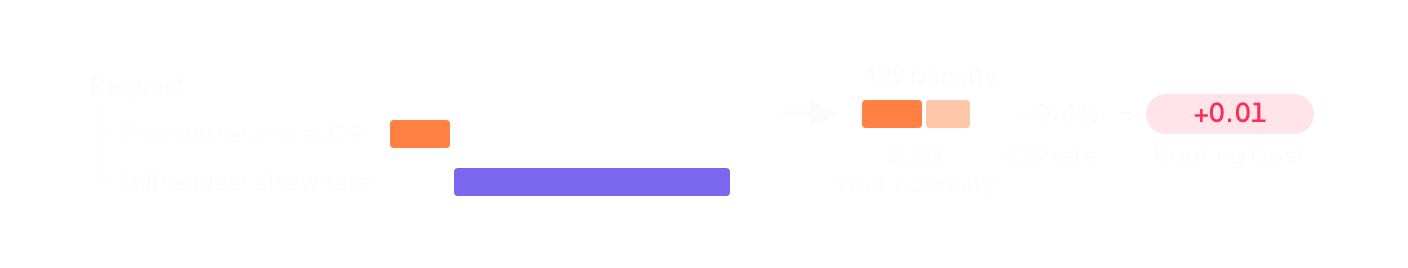
速率限制(HTTP 429)意味着 provider 容量已满,把你的请求拒了。你得先等着被拒绝,然后整个请求再转给另一个 provider。路由器会把这段等待时间加上一个罚分计入该 provider 的 Routing Cost,权重取决于它触发速率限制的频率,因此通常影响很小。反复出现的速率限制,更多是通过下面讲到的流量上限和 backoff 起作用的。
它有多大概率能成:可靠性与质量
失败的那次尝试同样要付钱、同样要花时间,所以 Routing Cost 计算的是「一直重试到成功」这件事的期望成本。如果 5 次里有 1 次失败,那么每个好答案要付 1.25 次尝试的钱。
可靠性
可靠性错误指的是因为 provider 而失败的请求。你会损失这次尝试、必须重试,所以每个错误在 Routing Cost 里都带着很重的罚分。
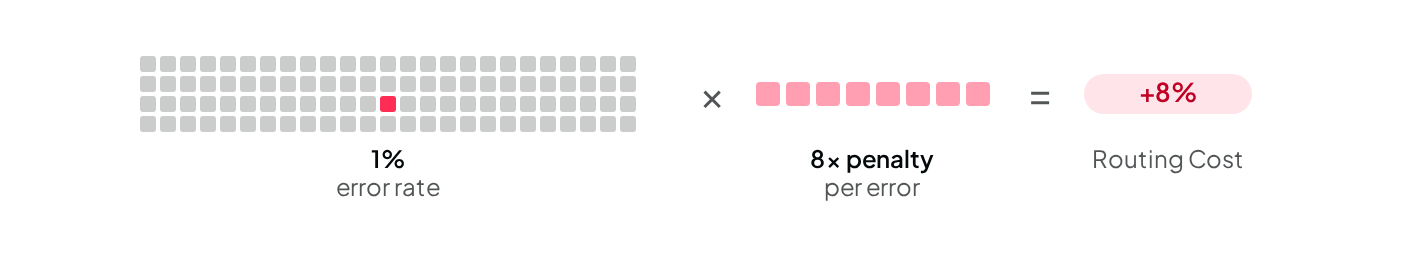
如果某个 provider 在同一模型上的错误率远高于其他 provider,路由器就会停止向它发送请求,直到它恢复。
质量
质量衡量的是 provider 的响应能不能用。目前主要的检查是 tool calling 回来是否格式完整,我们还在增加更多检查。每一次坏响应都会抬高该 provider 的 Routing Cost,因为一个便宜但错误的答案其实很贵。
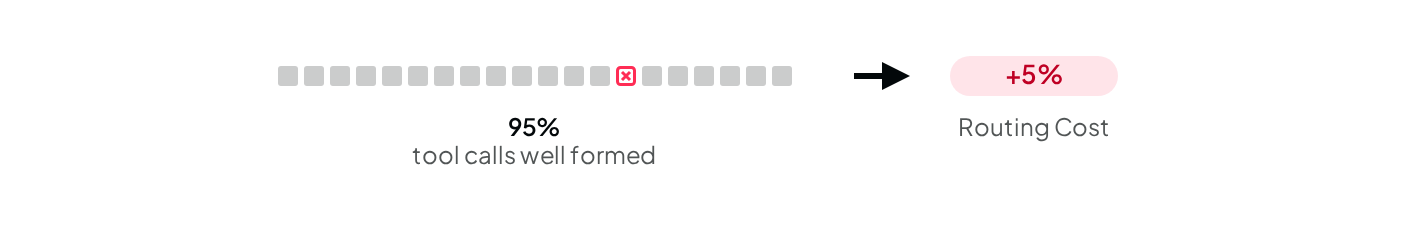
被标记为 tool calling 损坏、或 benchmark 准确率远低于该模型应有水平的 provider,会被远远甩在后面,在标记解除之前只能拿到少量测试流量。
接近者更接近:流量如何分配
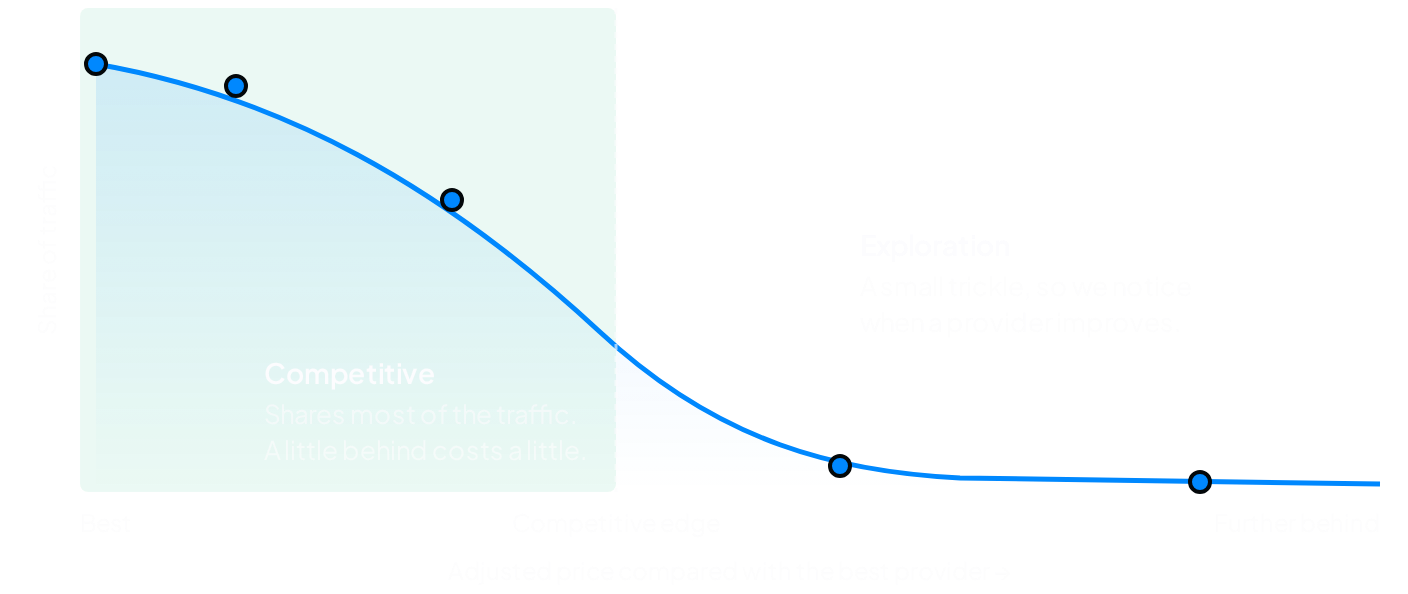
把每个请求都发给唯一最好的 provider 会把它压垮,所以流量是要分的。更快的 provider 能承受更高的 Routing Cost 而保持竞争力。竞争边界以内的所有 provider 分到大部分流量,略微落后于最优者也只是代价略高一点;越过这条边界,流量份额就会迅速下滑。
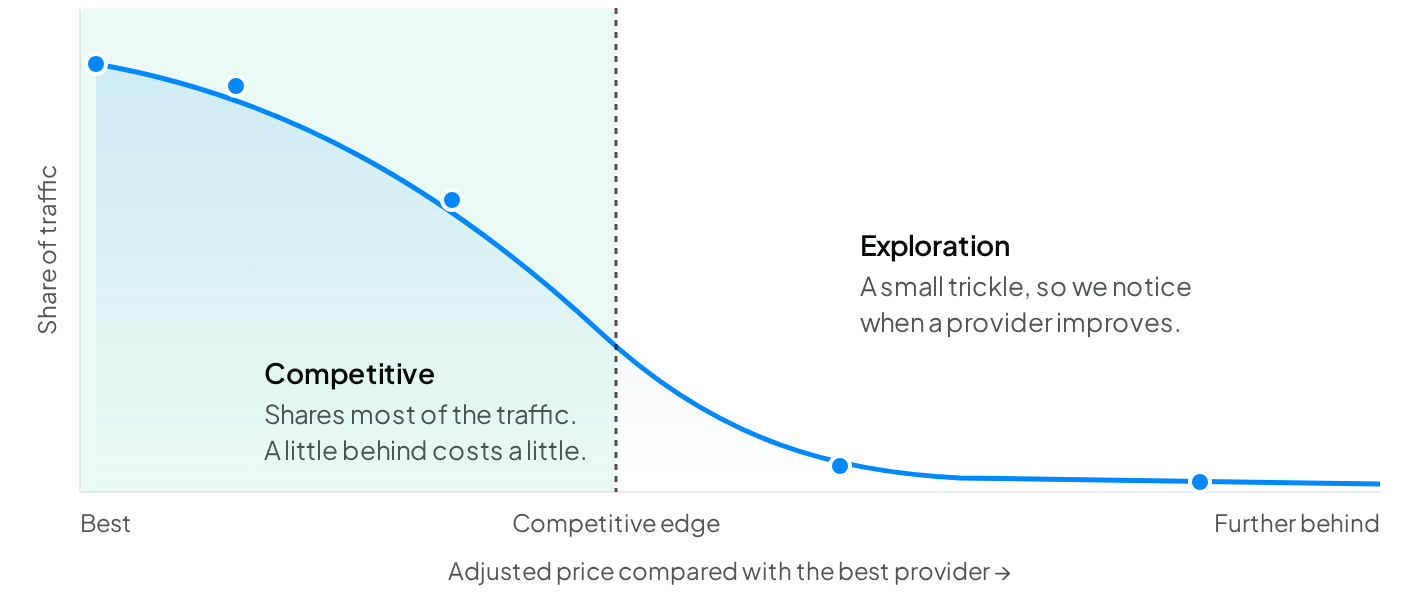
在这之上还有三道护栏:
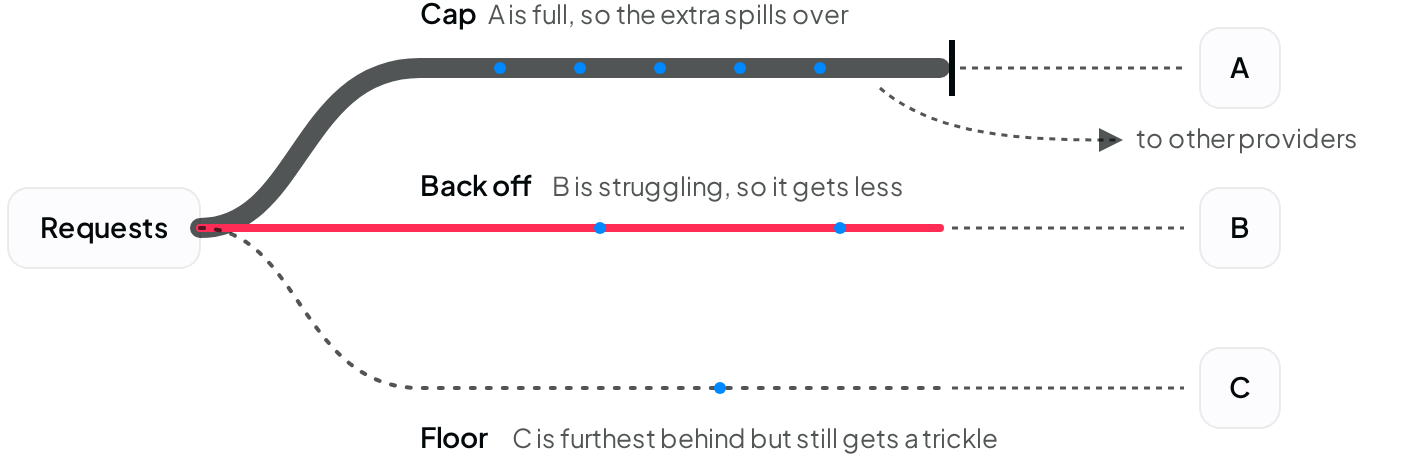
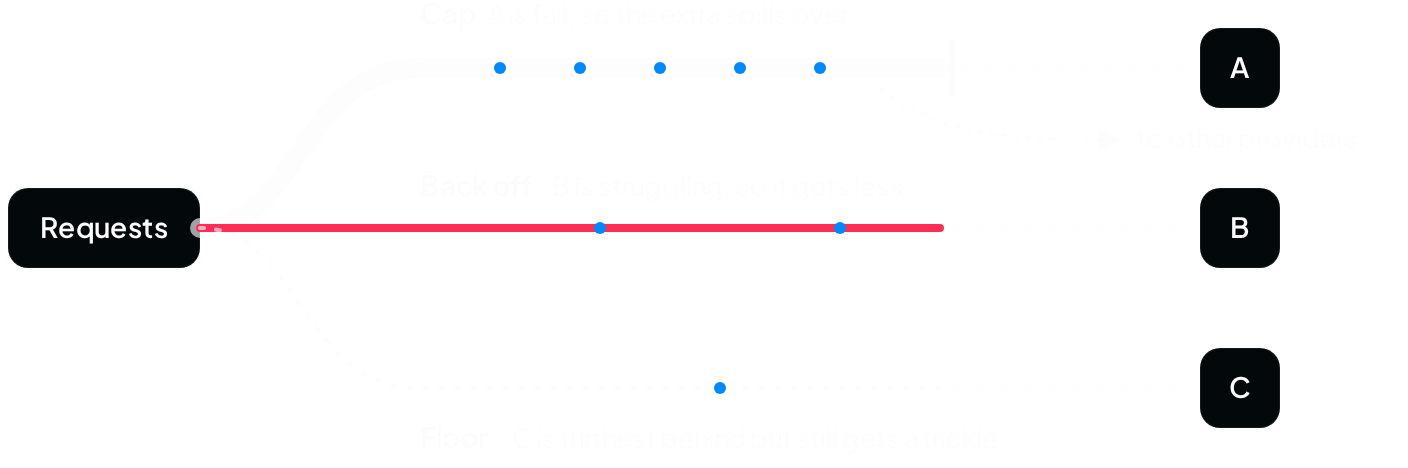
保底:每个 provider 都会保留一小股流量,这样我们才能发现那些吃力的 endpoint 什么时候开始好转。新 endpoint 从该模型的典型数值起步,所以不需要有流量历史。 退避:开始失败或触发速率限制的 provider,分到的流量会减少,直到它恢复。 上限:路由器会学到每个 provider 在返回 429 之前能承接多少负载,多出来的部分溢给其他 provider。容量增加后,这个上限会自行提高。
哪些东西保持不变
设置了 provider.order 的请求会绕过新的路由逻辑,provider 按指定顺序排列(默认仍按价格)。设置 provider.only 或 provider.ignore 时,如果剩下的 provider 不止一个,就由新算法在其中挑选。 显式指定的 provider.sort(price、throughput 或 latency)会使用该排序,而不启用新算法。 只有一次对话中的第一个请求会由算法挑选 provider。进行中的对话会固定在原来的 provider 上,好让 prompt cache 保持温热。如果该 provider 变得不可用,对话会自动回退到另一个 provider。 如果某次尝试失败,请求会改用排名下一位的 provider 重试。
我们是怎么测量的
为了衡量新路由算法的影响,我们必须跳出标准的 A/B 测试,因为路由行为的变化很难与对照组隔离。举例来说,如果新算法更善于把流量从某个吃力的 provider 上引开,那么旧算法发给该 provider 的请求就会遇到更多可用容量、变得更快,从而让结果产生偏差。更让难度雪上加霜的,是请求形态和流量模式的巨大波动。单个大客户(whale user)如果对某个 provider 自动化地发起一连串高 effort 的请求,无论我们用哪种算法为它路由,都可能人为地抬高该 provider 的各项指标。
所以我们做了一次 switchback 实验:把每天切成 3 小时一段,在每一对相匹配的时段之间在新旧路由器之间切换,每次切换时用一个小时的 burn-in 期丢弃数据,并在整整一周的时间里,针对一组有代表性的 open source 模型测量逐模型的影响。
结果
在实验进行的一周里,我们把超过 2,400 万个请求、1,030 亿输入 tokens 平均分配到新旧两套路由算法上,测量它们对关键性能指标的影响。
指标旧版新算法新版对比旧版95% 区间 TTFT p501,007 ms837 ms降低 16.9%降低 13.9% 到 19.8% TTFT p954,601 ms3,733 ms降低 18.9%降低 15.7% 到 21.9% Throughput p5062.4 tok/s72.6 tok/s提升 16.3%提升 13.8% 到 18.9% 每千次请求成本$1.25$1.32上升 6.0%上升 5.1% 到 7.0% 每百万 tokens 成本$0.301$0.324上升 7.3%上升 4.9% 到 9.6% 调用方 TTFT p501,130 ms941 ms降低 16.7%降低 13.8% 到 19.7% 调用方 TTFT p956,032 ms4,504 ms降低 25.3%降低 21.6% 到 29.0% 整次请求 p50(到最后一个 token)4.00 s3.24 s降低 19.0%降低 14.2% 到 23.6% 整次请求 p9541.5 s34.9 s降低 16.0%降低 12.2% 到 19.7% 至少命中一次 4297.1%3.8%−3.4 pt 减少 67%−4.2 到 −2.5 pt 减少 62% 到 72% 需要重试10.4%6.9%−3.5 pt 减少 47%−4.4 到 −2.6 pt 减少 41% 到 52% 每次请求在失败尝试上花的时间349 ms242 ms−106 ms 减少 55%−181 到 −35 ms 减少 48% 到 60%
开始使用
如果你用的是默认路由,那就什么都不用改。每个请求由哪个 provider 服务,会写在响应里,也会出现在你的 Activity 页面上。
想保留旧的只按价格路由,把 provider.sort 设为 "price",在模型 slug 后追加 :floor,或者在账号设置里把默认排序设为价格。想自己挑 provider,就用 provider.order 或 provider.only。参见provider 路由指南。
常见问题
用上新的路由,我需要改代码吗?
不需要。没有指定 provider sort、也没有 provider order、only 或 ignore 列表的请求,在已启用的模型上会自动使用新路由器。你的 API key、请求体和模型 ID 都不变。
怎么才能继续只按价格路由?
在请求体里把 provider.sort 设为 price,在模型 slug 后追加 :floor,或者在账号设置里把默认的 provider sort 设为 price。任何显式的排序都会绕过新路由器。
新路由会覆盖我的 provider order 或 only 列表吗?
provider.order 会绕过新路由器,并按你指定的顺序路由。provider.only 和 provider.ignore 仍然会过滤候选集合,但由新算法在剩下的 provider 中挑选。
新路由会不会比只按价格路由更贵?
可能会,因为它有时会选择更快或更可靠的 provider,而不是最便宜的那个。在我们的线上实验中,每次请求成本上升 6.0%,同时 TTFT 改善 16.9%、throughput 改善 16.3%,429 错误率下降 67%。
在新路由下,provider 怎么才能拿到更多流量?
改进路由器用来打分的那些信号:实际价格、首 token 时间、throughput、错误率与速率限制触发率,以及输出质量。