在线AI教程 / AI工具
[Amazon Bedrock] AI 代理的土拨鼠日:在 Amazon Bedrock 上使用 OpenAI 模型的提示缓存模式
人工智能 AI 代理的土拨鼠日:在 Amazon Bedrock 上使用 OpenAI 模型的提示缓存模式 每次您剥离代理时,它都必须在执行操作之前重新阅读其整个生命故事。以下是如
人工智能
AI 代理的土拨鼠日:在 Amazon Bedrock 上使用 OpenAI 模型的提示缓存模式
每次您剥离代理时,它都必须在执行操作之前重新阅读其整个生命故事。以下是如何让它记住,而不必再次向它提供相同的上下文。
在电影《土拨鼠之日》中,比尔·默里饰演的角色每天都在重复同样的 2 月 2 日。他在同一个旅馆、同一个小镇上,在收音机里播放的同一首歌中醒来,一遍又一遍地重复着,一些影迷估计已经有 34 年了。
除非他从头开始重新解决,否则他前一天完成的任何事情都不会延续。人工智能代理生活在土拨鼠之日的一个版本中。每当代理采取步骤(调用工具、读取结果、决定下一步做什么)时,它都必须向模型发送迄今为止的整个故事,以保持连续性:工具定义、指令、之前的每个工具调用和每个结果。该模型仅根据您提供的输入预测下一个标记。它在请求之间没有内部存储器,因此必须再次读取所有内容。到编码会话的第 20 轮时,模型会重新读取第 1-19 轮,并且您需要一次又一次地为每一个代币付费。
提示缓存打破了循环。该服务存储您的输入提示(说明、工具和内容),并在下一个请求时重复使用它,而费用只是输入价格的一小部分。
在这篇文章中,我将带您了解代理的生命周期,从第一次转向到获得新工具并产生助手。在此过程中,我将向您展示即时缓存如何降低成本并保持代理的响应能力和一致性。
代理发送给其 LLM 的内容
在讨论缓存之前,了解一下典型代理对大语言模型 (LLM) 的首次调用包含哪些内容会有所帮助:
工具列表 – 代理可以调用的每个函数的定义。当您发布新版本时会发生更改。 说明 – 开发人员提示:规则、角色、策略、示例。每个版本也会发生变化。 历史 – 到目前为止在本次会话中发生的所有事情:任务、模型的工具调用和工具结果(每轮都会增长)。 新转 – 最新的工具结果或用户消息(每次可能不同)。
如果您不设置缓存,代理将逐轮发送到模型的内容:
!五个不断增长的代理请求,其中工具、说明和早期历史记录以红色标记,每个新轮次以黄色标记。
图 1:代理每轮向模型发送的内容
提示缓存在幕后是如何工作的
当模型读取提示时,它首先执行名为 prefill 的写入操作。在预填充期间,它处理每个输入令牌并构建其键和值向量(也称为键值或 KV),从而形成模型的工作状态。这发生在模型写入第一个标记之前。
提示缓存保存该状态,其中包含系统提示、工具、内容、历史记录等。当稍后的请求以相同的输入标记(即相同的文本)开始时,提示缓存服务将加载保存的状态,而不是再次计算它。然后,它仅处理模型的下一个有效负载中的新内容。提示缓存可以是隐式的,其中 Amazon Bedrock 选择可重用前缀结束的位置;也可以是显式的,其中您的代码使用“prompt_cache_breakpoint”标记该终端节点。您可以同时使用这两种方法,我们建议您这样做。
第 1 弯与第 2 弯相比
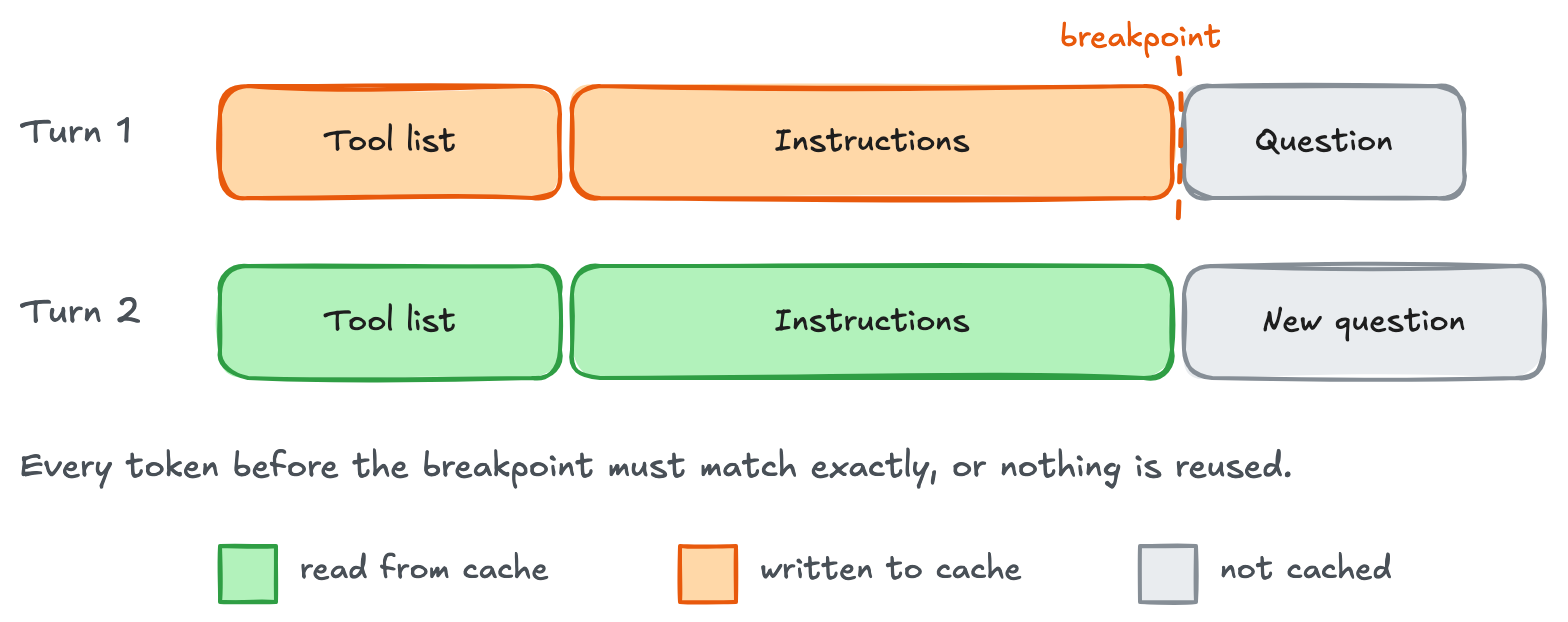
图 2:第 1 回合将提示前缀保存到断点,第 2 回合重用它并仅为新问题支付全价
隐式或显式,为什么我们需要两者?
对于代理工作负载,隐式缓存可让 Bedrock 选择随着对话的增长而缓存的内容。通过显式缓存,您可以标记共享内容(例如工具和说明),以便在会话之间以及启动帮助代理时重复使用。您并不总是需要这两种形式的缓存,但将它们结合起来可以为您提供一个可重用的起点,同时 Bedrock 可以自动管理不断增长的会话。
新会话还可以重用该共享起点,而每个对话都建立在其自己的缓存历史记录之上。在这篇文章中,我们从第一轮开始,然后展示如何通过后续轮次、新工具以及跨子代理来传输缓存内容。
你好缓存世界
第一个胜利是缓存提示的静态部分:在请求之间保持相同的工具和指令。这些示例使用您现有的 Amazon Bedrock 客户端、“TOOLS”和“task”。将缩短的“INSTRUCTIONS”字符串替换为您的真实政策和示例。可重用前缀必须达到 1,024 个令牌才有资格。
缓存静态内容时,使用显式模式:选择保存的前缀结束位置。
KEY = "support-agent:v7:gpt-6-astra" INSTRUCTIONS = "Your full support policies and examples..."
Rendered context: [provider context][TOOLS][INSTRUCTIONS] | [task]
Cache starts at the beginning; the marker below chooses its end.
resp = client.responses.create( model="us.openai.gpt-6-astra", store=False, # Response storage; prompt caching still works. include=["reasoning.encrypted_content"], prompt_cache_key=KEY, prompt_cache_options={"mode": "explicit", "ttl": "30m"}, tools=TOOLS, # Rendered before instructions; keep order stable. input=[ { "role": "developer", "content": [{ "type": "input_text", "text": INSTRUCTIONS,
Save through this whole block, including TOOLS.
"prompt_cache_breakpoint": {"mode": "explicit"}, }], },
User message is processed but not cached.
{"role": "user", "content": task}, ], )
prompt_cache_key 告诉服务哪些请求要共享缓存。当我们在新会话中读取缓存时,我们会回到如何使用它。在我们使用显式缓存的一个测试中,大约 4,000 个令牌的工具和指令前缀在第一个请求中写入 4,120 个令牌,并在后续请求中读取这 4,120 个令牌。 “任务”(或用户请求)出现在缓存边界之后,因此这不会触发对缓存的写入。
请记住,只有当您传递完全相同的文本时,提示缓存才会起作用。确保代理的说明和工具列表每次都以相同的方式序列化。模型上下文协议 (MCP) 服务器和其他形式的工具交付需要建立索引,以确保它们保持一致。在缓存的指令之后保留任何变化的内容,例如日期、用户名或请求 ID。
随着内容的增长和变化(不同的工具和内容),使用隐式模式让服务跟随对话。这里,第一个请求没有显式标记。其最新的合格消息是用户的任务,因此自动断点位于该任务之后,并涵盖工具、指令和任务。为了清楚起见,以下示例中显式显示了该模式,尽管隐式是默认模式。设置“store=False”会将对话历史记录保留在您的应用程序中。它不会禁用缓存。
def ask_with_implicit_cache(history): return client.responses.create( model="us.openai.gpt-6-astra", store=False, include=["reasoning.encrypted_content"], prompt_cache_key=KEY, prompt_cache_options={"mode": "implicit", "ttl": "30m"}, tools=TOOLS, input=history, # Everything gets cached )
history = [ {"role": "developer", "content": INSTRUCTIONS}, {"role": "user", "content": task}, ]
Automatic endpoint: the end of the user message.
resp = ask_with_implicit_cache(history)
当下一轮继续执行相同的任务时,这非常有用。不同的任务与旧任务的前缀不匹配,并且隐式写入不一定仅为工具和指令创建单独的条目。当您需要在任务之间重用较短的共享前缀时,请使用显式标记。
当代理需要共享起点和成长历史时,请使用两者。从以下代码示例中标记的开发人员块开始,并调用函数“ask_with_implicit_cache”。请求级模式保持隐式。块级标记在指令之后添加显式保存点。该服务还可以通过最新的符合条件的消息进行保存。这使得共享前缀在会话增长时保持可用。
history = [ { "role": "developer", "content": [{ "type": "input_text", "text": INSTRUCTIONS, "prompt_cache_breakpoint": {"mode": "explicit"}, }], }, {"role": "user", "content": task}, ]
Still implicit mode, now with an explicit startup save point in the history.
resp = ask_with_implicit_cache(history)
缓存对话历史记录和工具结果
该模型按名称请求工具并提供它们的参数。您的应用程序必须执行它们。 execute_function 是您构建的一个帮助器,用于将这些请求路由到匹配的 Python 函数并返回其结果。以下循环使用此帮助程序来运行每个请求的工具。它将模型的输出和所有工具结果附加到“历史记录”列表中,然后再次发送该列表,直到模型返回最终答案。在隐式模式下,Amazon Bedrock 可以重用未更改的前缀,并通过最后的工具结果缓存添加的内容。保持早期消息和初始“TOOLS”不变。
import json
Map tool names to their Python implementations.
TOOL_HANDLERS = { "get_owner": get_owner,
Register your other initial tools here.
}
def execute_function(name, arguments): """Run the requested tool and return its result.""" handler = TOOL_HANDLERS.get(name) if handler is None: return {"error": f"Unknown tool: {name}"} return handler(**arguments)
while True:
Preserve all output items, including encrypted reasoning.
history.extend(resp.output) calls = [x for x in resp.output if x.type == "function_call"] if not calls: break for call in calls: result = execute_function(call.name, json.loads(call.arguments)) history.append({ "type": "function_call_output", "call_id": call.call_id, "output": json.dumps(result), })
The last result in this group supplies the automatic endpoint.
resp = ask_with_implicit_cache(history)
对于后续操作,请附加新的用户消息并再次调用帮助程序。保持较早的消息不变,以便其缓存的端点仍然可用。
滚动断点:每一回合都会读取之前的所有内容
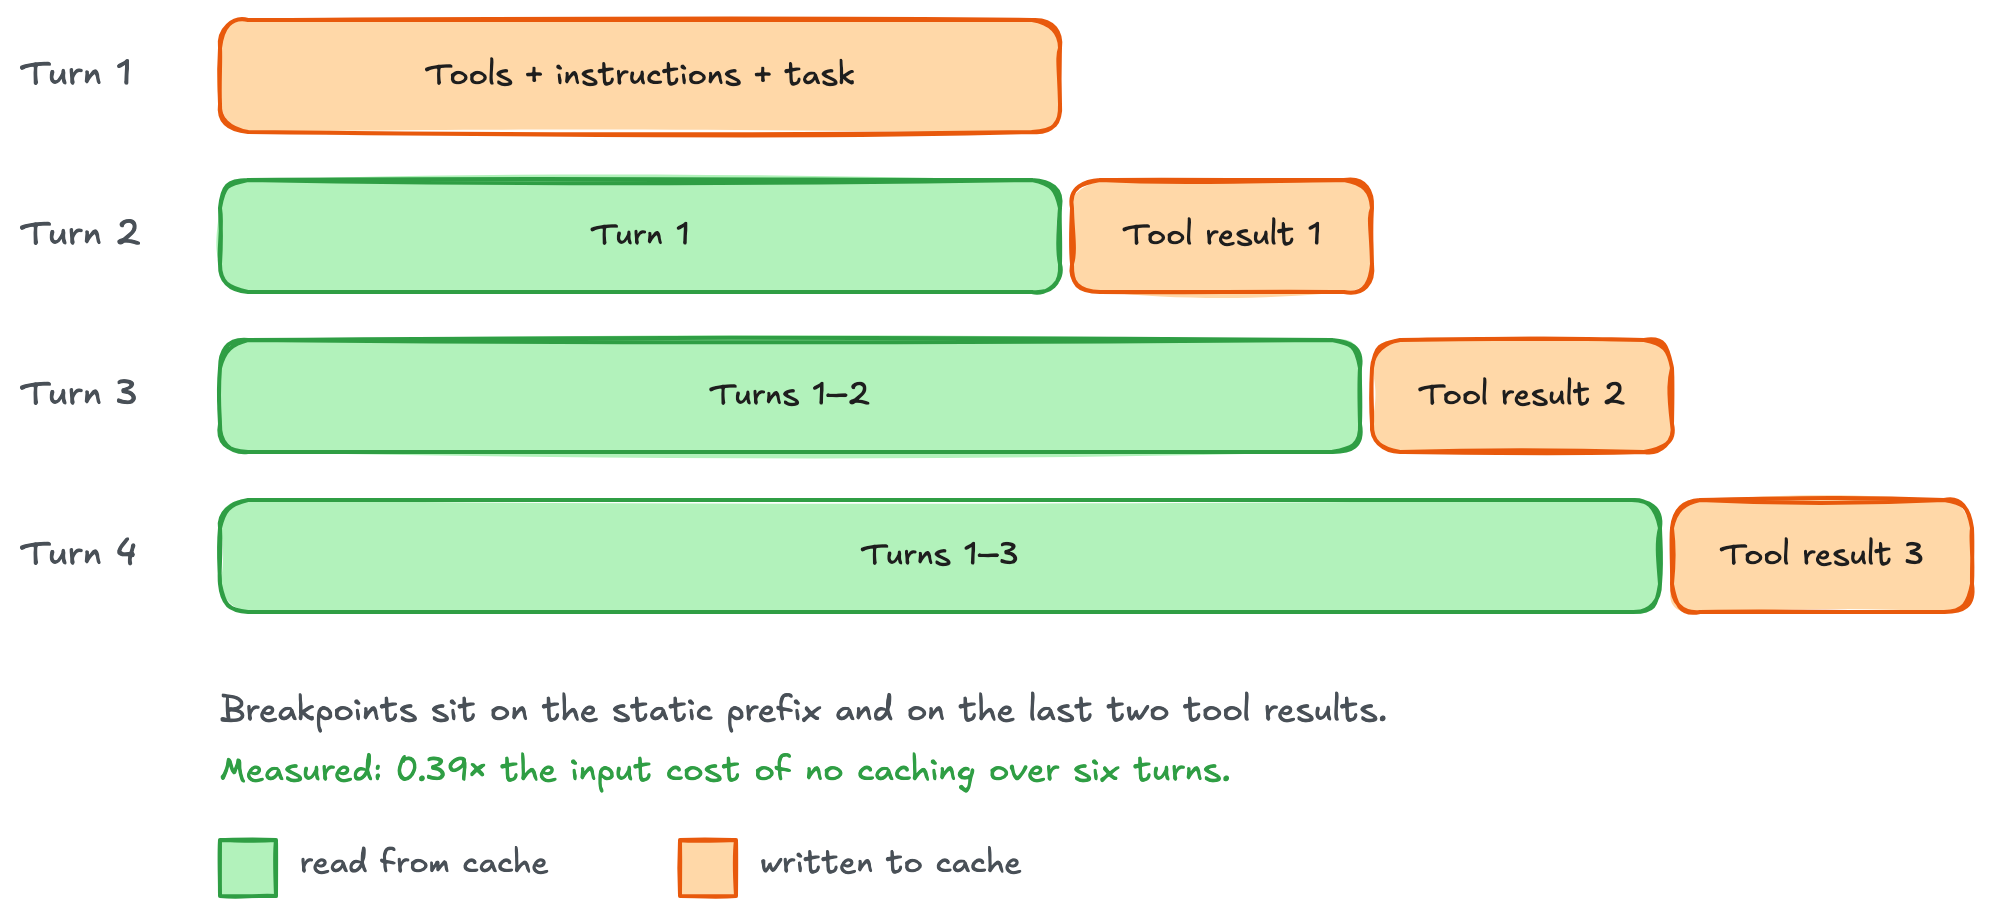
图 3:滚动断点,每个回合都会读取之前的所有内容并仅写入自己的工具结果
对于单独的仅显式运行,请从组合的 Hello 缓存世界示例中重新创建两条消息历史记录。此循环将工具结果包装在“input_text”块中,并标记每个批次中的最终结果。早期的标记留在“历史”中。有关长时间对话,请参阅当前查找规则。
import json
while True: resp = client.responses.create( model="us.openai.gpt-6-astra", store=False, include=["reasoning.encrypted_content"], tools=TOOLS, prompt_cache_key=KEY, input=history, prompt_cache_options={"mode": "explicit", "ttl": "30m"}, ) d = resp.usage.input_tokens_details print("read", d.cached_tokens, "write", d.cache_write_tokens) history.extend(resp.output) # Includes encrypted reasoning. calls = [x for x in resp.output if x.type == "function_call"] if not calls: break batch = [] for call in calls: result = execute_function(call.name, json.loads(call.arguments)) batch.append({ "type": "function_call_output", "call_id": call.call_id, "output": [{"type": "input_text", "text": json.dumps(result)}], })
Add the newest boundary; retain every earlier marker.
batch[-1]["output"][-1]["prompt_cache_breakpoint"] = {"mode": "explicit"} history.extend(batch)
GPT-6 Astra 在这个六轮工作负载中获得了最佳隐式结果:比没有缓存的运行输入成本低约 62%。在同一模型上,显式滚动断点可节省约 61% 的成本。随着对话的深入,双方都重用了更多的历史记录。这些是工作量结果。衡量你自己的代理人的节省。
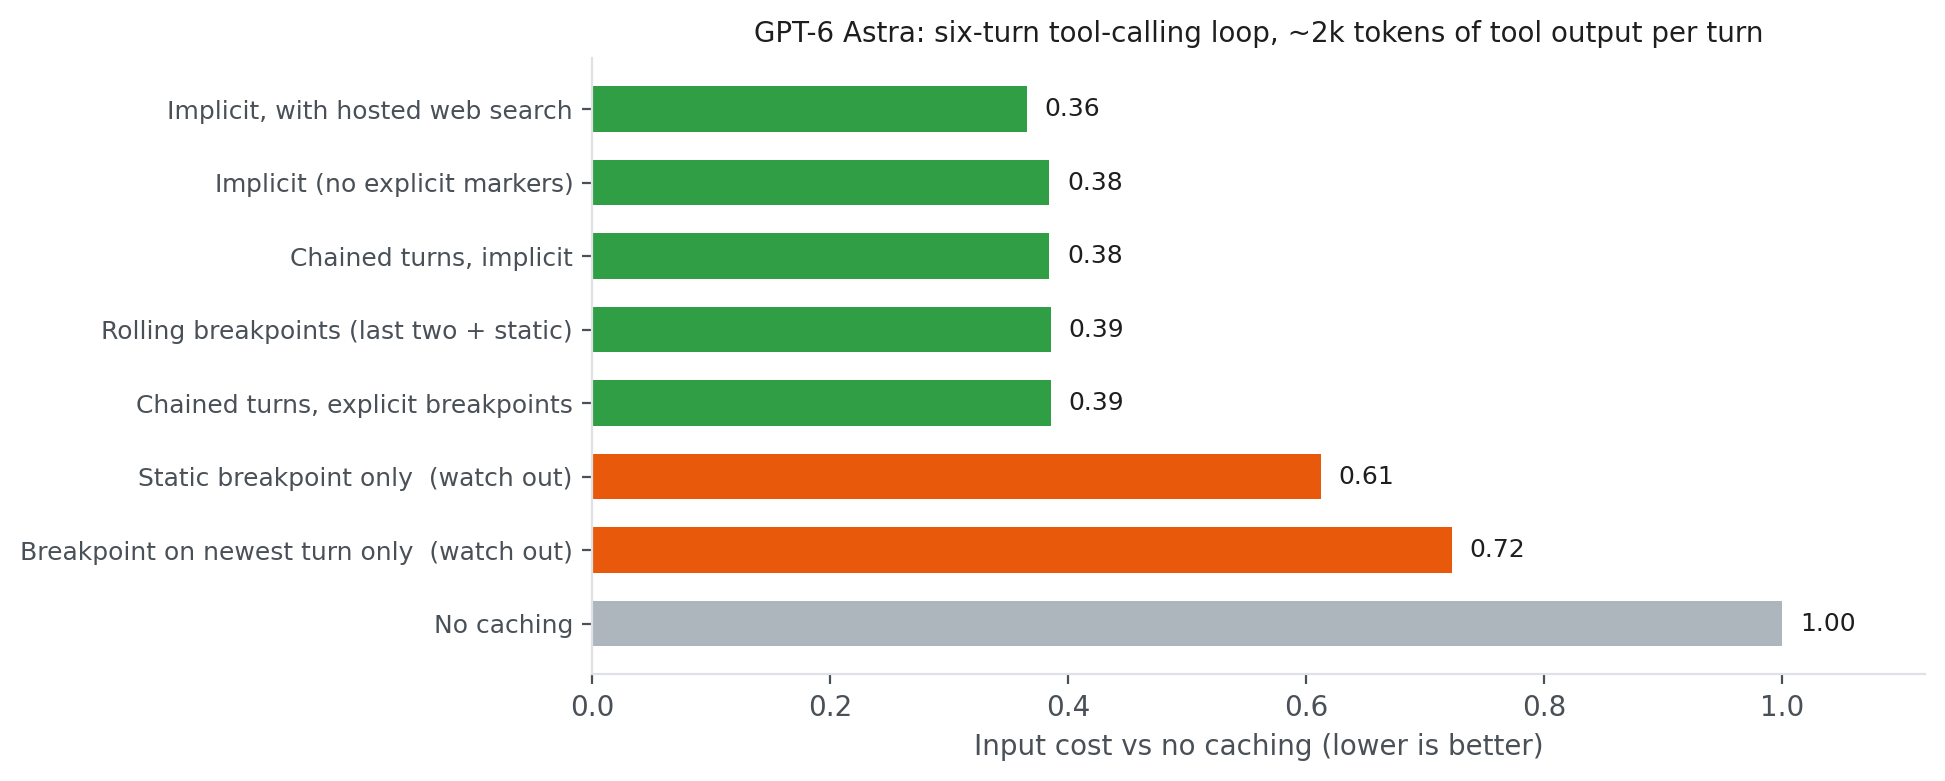
图 4:GPT-6 Astra 上每个缓存设置的输入成本(相对于无缓存)
注意:
仅显式模式下的静态断点 – 工具和指令被缓存,但每回合都会再次处理增长的历史记录 (0.61)。此限制不适用于组合示例,该示例也可以通过符合条件的对话结尾进行保存。 移动单个断点可以防止缓存重用并导致在仅显式模式下重复写入。也保留上一回合的断点。 仅通过更改任务进行隐式写入 – 新任务可能共享工具和指令,但不共享先前保存的端点。如果不同的任务需要重用该较短的前缀,则在共享指令后添加显式标记。
当工具改变时
有时,代理的工具列表会发生变化,或者添加新工具。保持初始列表稳定:添加、删除或重新排序定义可能会使缓存的前缀无效。选择适合工具可用方式的方法。
当在代理流程的不同步骤中调用已知工具时: 发送相同排序的“TOOLS”并使用“allowed_tools”来限制模型可以调用的内容。对于 allowed_tools,"mode": "auto" 让模型决定是否调用允许的工具,而 "mode": "required" 需要至少一个允许的工具调用。将其作为“tool_choice”传递。该限制不会更改缓存的目录:
tool_choice={"type": "allowed_tools", "mode": "auto", "tools": [{"type": "function", "name": "get_owner"}]}
会话期间的新工具。 Amazon Bedrock Runtime 和 Amazon Bedrock Mantle 终端节点都接受名为“additional_tools”的输入项类型,适用于 GPT-6 Astra、GPT-6.1 Sol 和 GPT-5.6 Luna。有关 AWS 区域的模型可用性,请参阅 Amazon Bedrock 中 AWS 区域支持的模型。在辅助函数“execute_function”中注册新工具“get_due_date”,然后将其架构附加到代理循环的已完成历史记录中。保持初始的“TOOLS”不变:
TOOL_HANDLERS["get_due_date"] = get_due_date NEW_TOOL = { "type": "function", "name": "get_due_date", "description": "Return the due date for a support case.", "strict": True, "parameters": { "type": "object", "properties": {"case_id": {"type": "string"}}, "required": ["case_id"], "additionalProperties": False, }, } history.append({ "type": "additional_tools", "role": "developer", "tools": [NEW_TOOL], }) history.append({ "role": "user", "content": "Find the due date for case C-123.", })
Implicit mode saves through this new user message, including NEW_TOOL.
resp = ask_with_implicit_cache(history) d = resp.usage.input_tokens_details print("old prefix read", d.cached_tokens, "new write", d.cache_write_tokens)
Example output:
old prefix read 2048 new write 256
会议中期推出新工具
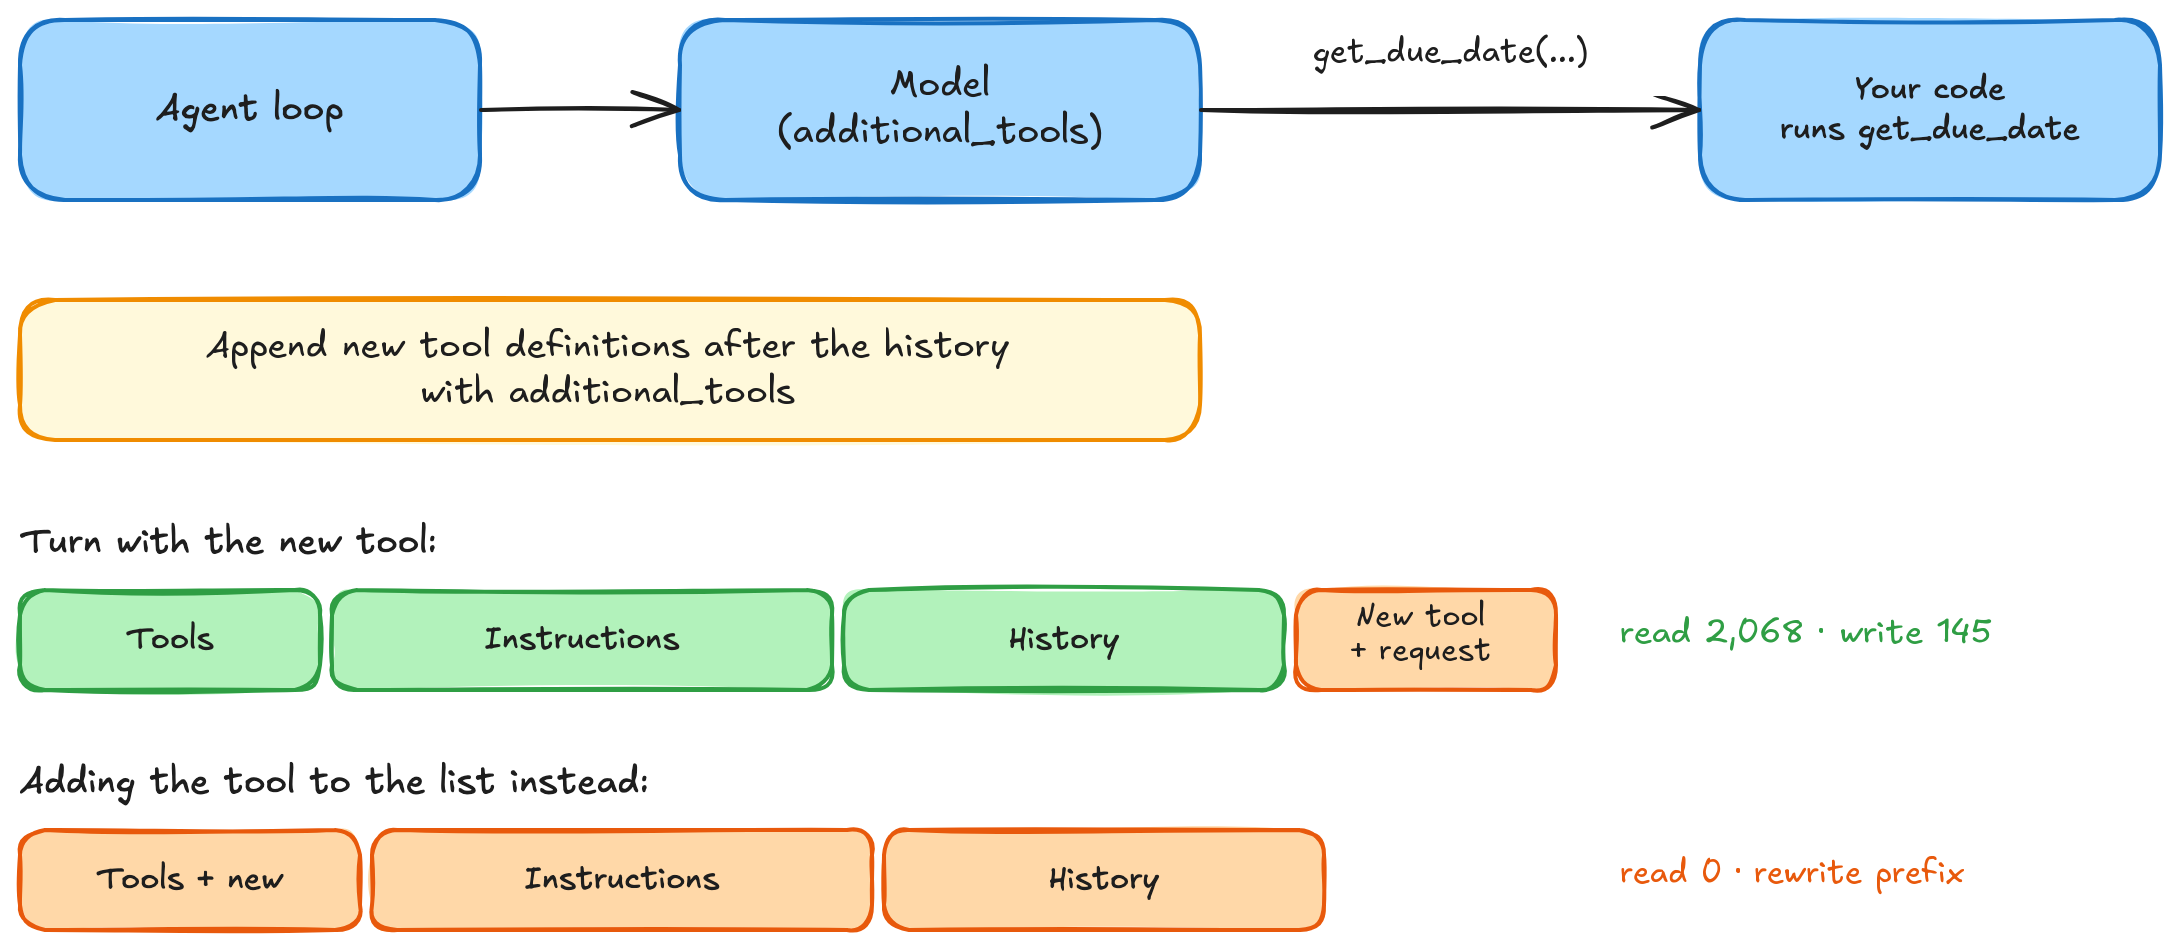
图 5:附加工具使早期前缀可重复使用,示例计数来自 Amazon Bedrock Runtime 上的 GPT-6 Astra
使用新响应继续工具执行循环。该循环将模型的输出添加到“history”中,运行任何请求的工具,并附加其结果。在以后的请求中保留“additional_tools”项,以便新工具仍然可用。在隐式模式下,Amazon Bedrock 可以缓存新用户消息,包括其前面的工具定义。在仅显式模式下,保留较早的断点并将其添加到该用户消息中的“input_text”块中。 additional_tools 项本身不能保存断点。
不同的角色,不同的目录。 当不同的代理角色需要不同的工具时,请在每个会话开始时选择稳定的工具配置文件,例如支持或计费。每个配置文件都有自己的缓存前缀。标记共享指令,以便以后使用该配置文件的任务可以重用它们,然后随着对话的发展使用任一模式。
缓存工具配置文件
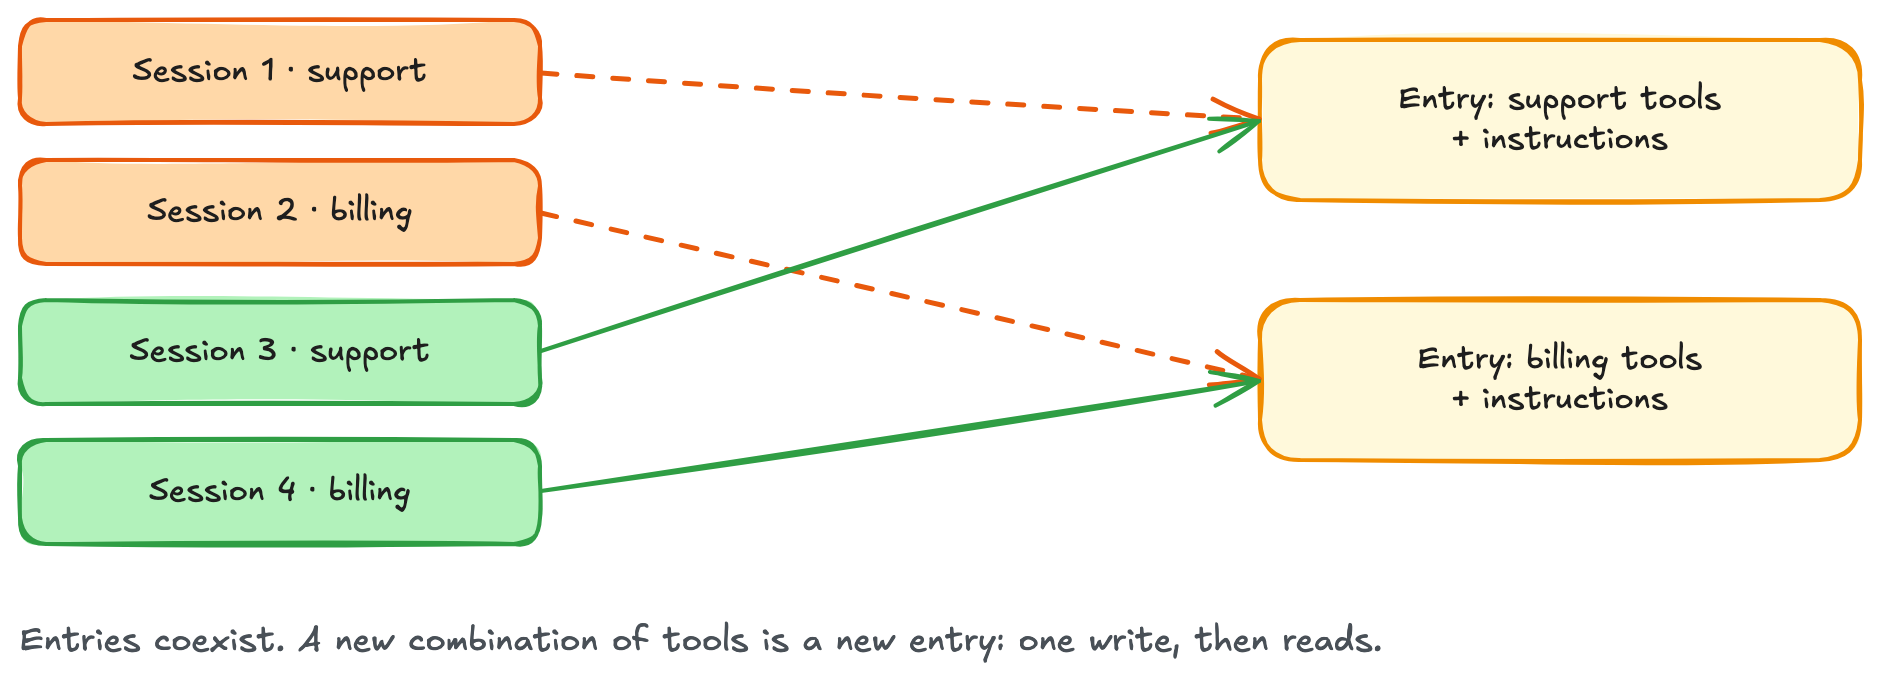
图 6:每个工具配置文件都有自己的缓存前缀,可通过匹配会话重用
子代理和侧面调用
委派不应该让每个助手重新阅读相同的背景。共享前缀,然后在末尾添加每个助手的任务。请注意,当您将缓存与 AI 代理一起使用时,工具和系统提示可能会被泄露或利用。建立负责任的人工智能实践,其中包括作为治理的一部分的快速缓存实施。
预热一次,然后扇出。 首先发送一个普通请求并等待其完成,然后再启动帮助程序。在每个请求中显式标记共享上下文,即使模式是隐式的:
shared = {"role": "developer", "content": [{ "type": "input_text", "text": INSTRUCTIONS, "prompt_cache_breakpoint": {"mode": "explicit"}, }]} warm = client.responses.create( model="us.openai.gpt-6-astra", store=False, tools=TOOLS, prompt_cache_key=KEY, prompt_cache_options={"mode": "implicit", "ttl": "30m"}, max_output_tokens=16, input=[shared, {"role": "user", "content": "Reply READY."}], ) d = warm.usage.input_tokens_details if not (d.cache_write_tokens or d.cached_tokens): raise RuntimeError("Shared prefix was not cached.") from concurrent.futures import ThreadPoolExecutor
helper_tasks contains the task text for each helper.
helper_inputs = [ [shared, {"role": "user", "content": task}] for task in helper_tasks ] with ThreadPoolExecutor(max_workers=4) as pool: helpers = list(pool.map(ask_with_implicit_cache, helper_inputs))
助手使用与热身相同的“TOOLS”、模型和“KEY”。在输出上限结束的预热仍然可以填充缓存。使用情况检查会在帮助程序启动之前确认缓存活动。
子代理:加热共享前缀一次,然后扇出
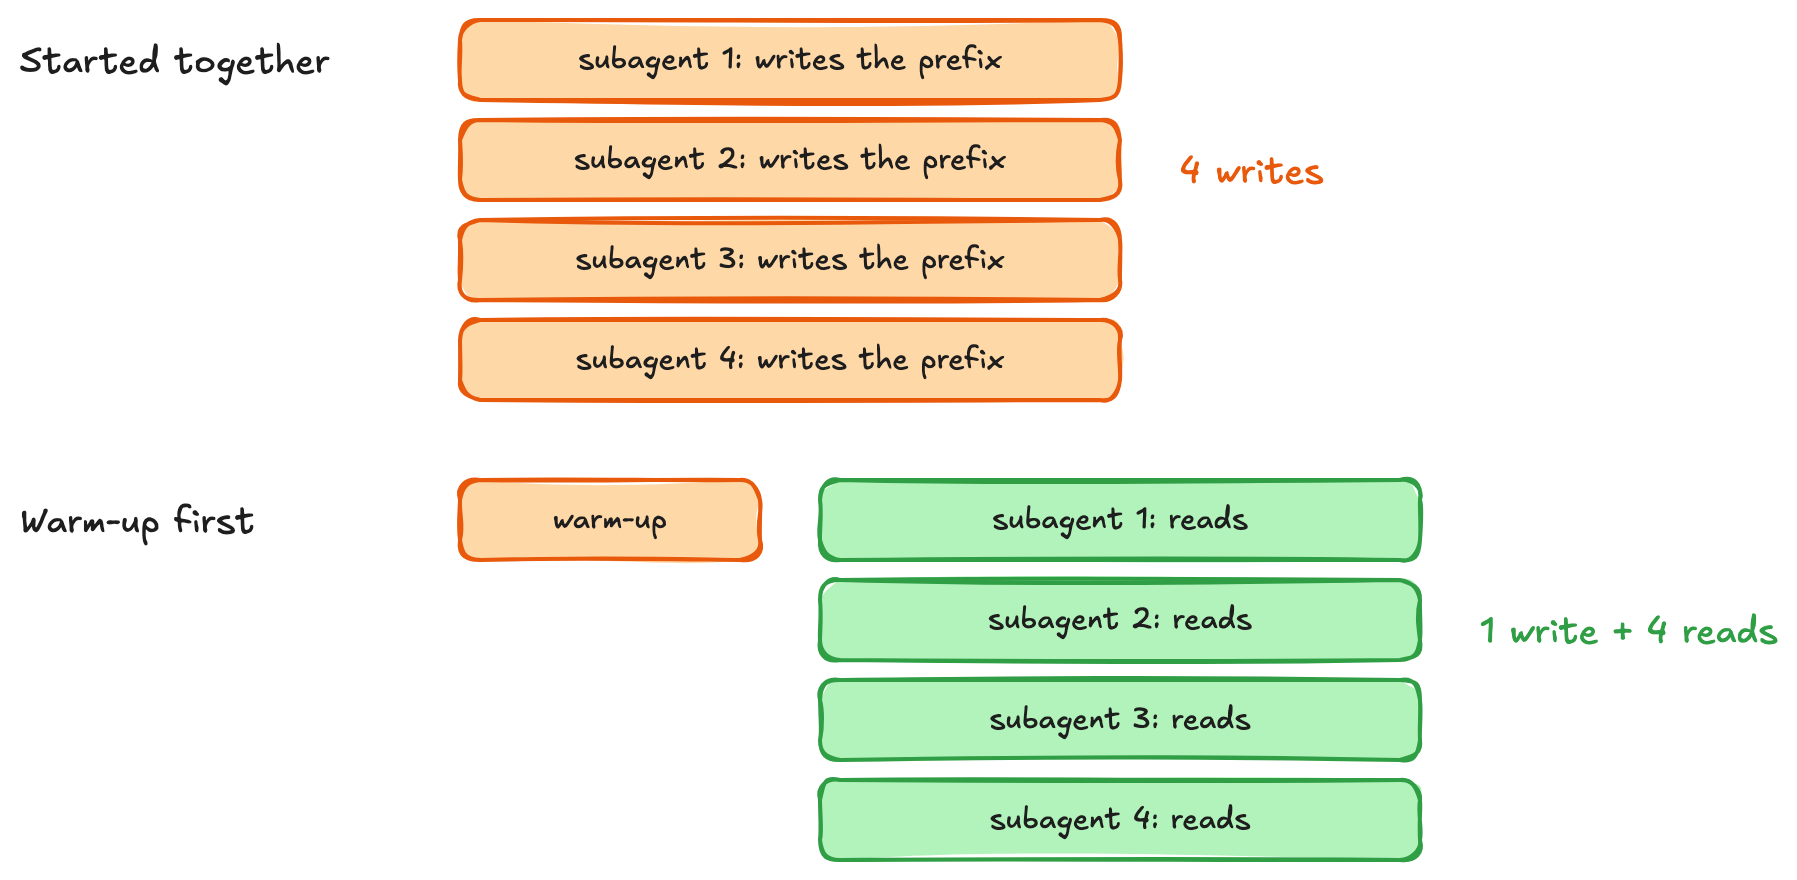
图 7:在启动助手之前预热共享前缀,然后每个助手添加自己的任务
给侧面调用相同的开始。代理循环通过附加每个“resp.output”及其匹配的工具结果(包括加密推理)来构建“历史记录”。家长完成后,将完整的列表复制给总结者或评委。同一个助手保持工具、模型和密钥不变:
from copy import deepcopy
history is the completed history built by the agent loop above.
Copy it so the helper can add instructions without changing the parent.
helper_history = deepcopy(history) helper_history.append({ "role": "developer", "content": "Summarize this conversation in one sentence. Do not call tools.", }) summary = ask_with_implicit_cache(helper_history) d = summary.usage.input_tokens_details print("history read", d.cached_tokens, "write", d.cache_write_tokens) print(summary.output_text)
Example output (assumed values and conversation):
history read 4096 write 32
Case C-123 is due on October 31, 2026.
帮助器可以重用“history”的缓存部分,但附加的开发人员消息不会自动扩展缓存以包含摘要指令。如果以后的请求重用相同的历史记录和指令,请将指令放置在带有“prompt_cache_breakpoint”的“input_text”块中。对于一次性摘要,不需要额外的标记。
暂停、重启和缓存键
暂停。 缓存的前缀至少有 30 分钟的生存时间 (TTL),成功重用后会刷新,并且可能会保持更长时间。如果会话很快恢复,普通的预热可以在前缀过期之前刷新前缀。将该请求的成本与让缓存过期进行比较。有关 TTL 规则,请参阅 Amazon Bedrock 文档。
新会话。 对于共享前缀的请求,保持“prompt_cache_key”稳定。即使会话的提示匹配,会话特定的密钥也会隔离会话。在以下示例中,切换到共享密钥可让会话重用前缀。
新会话仅在共享密钥时重用缓存
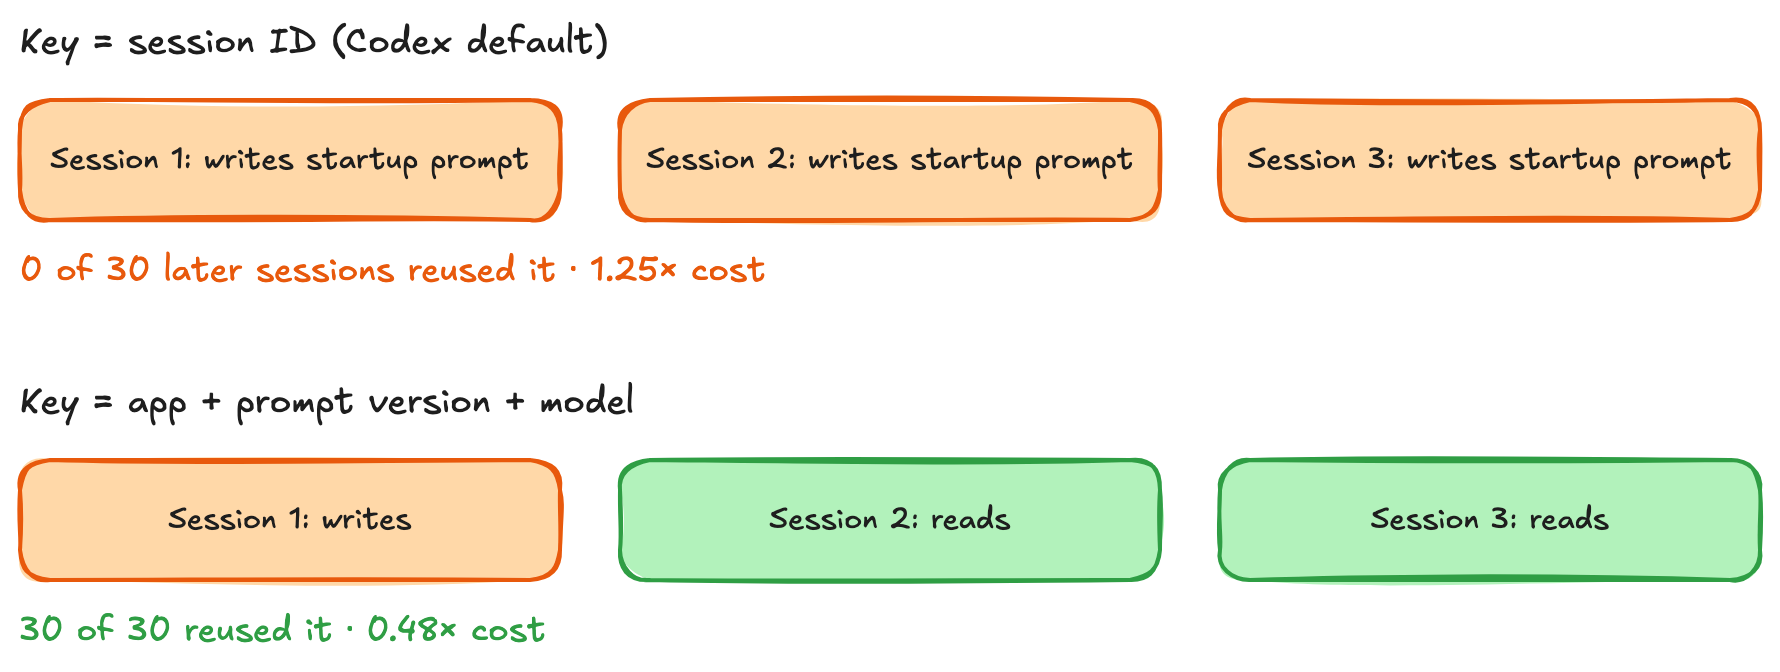
图 8:特定于会话的密钥分隔缓存条目,共享密钥允许匹配的会话重用它们
重用现有缓存内容需要相同的模型、AWS 账户和区域以及可用的匹配前缀。以下示例将显式启动标记与隐式模式相结合。每个会话都以相同的说明和自己的任务开始。两者都使用相同的计算密钥:
import hashlib
def cache_key(app, model, prompt_version, instructions): digest = hashlib.sha256(instructions.encode()).hexdigest()[:12] return f"{app}:{prompt_version}:{model}:{digest}"
KEY = cache_key("support-agent", "us.openai.gpt-6-astra", "v7", INSTRUCTIONS) prefix = {"role": "developer", "content": [{ "type": "input_text", "text": INSTRUCTIONS, "prompt_cache_breakpoint": {"mode": "explicit"}, }]} for label, question in [ ("session A", "Explain the refund policy without calling tools."), ("session B", "Explain the escalation policy without calling tools."), ]:
A fresh conversation for each session; the startup prefix matches.
session_history = [prefix, {"role": "user", "content": question}] result = ask_with_implicit_cache(session_history) d = result.usage.input_tokens_details print(label, "read", d.cached_tokens, "write", d.cache_write_tokens)
冷启动时,会话 1 写入共享前缀。会话 2 可以读取它,尽管它的任务可能不同。每个任务也可以隐式缓存。检查使用计数器:匹配的键和标记使重用成为可能,但缓存条目仍然必须可用。
提示缓存提供什么
成本。 对于具有 8,000 个令牌启动前缀和六轮每次添加 2,000 个令牌的 GPT-6 Astra 驱动的代理,一次性静态缓存将成本降低至 0.50 美元,滚动断点将建模输入成本降低了 64%:从每次会话 0.87 美元降至 0.32 美元。
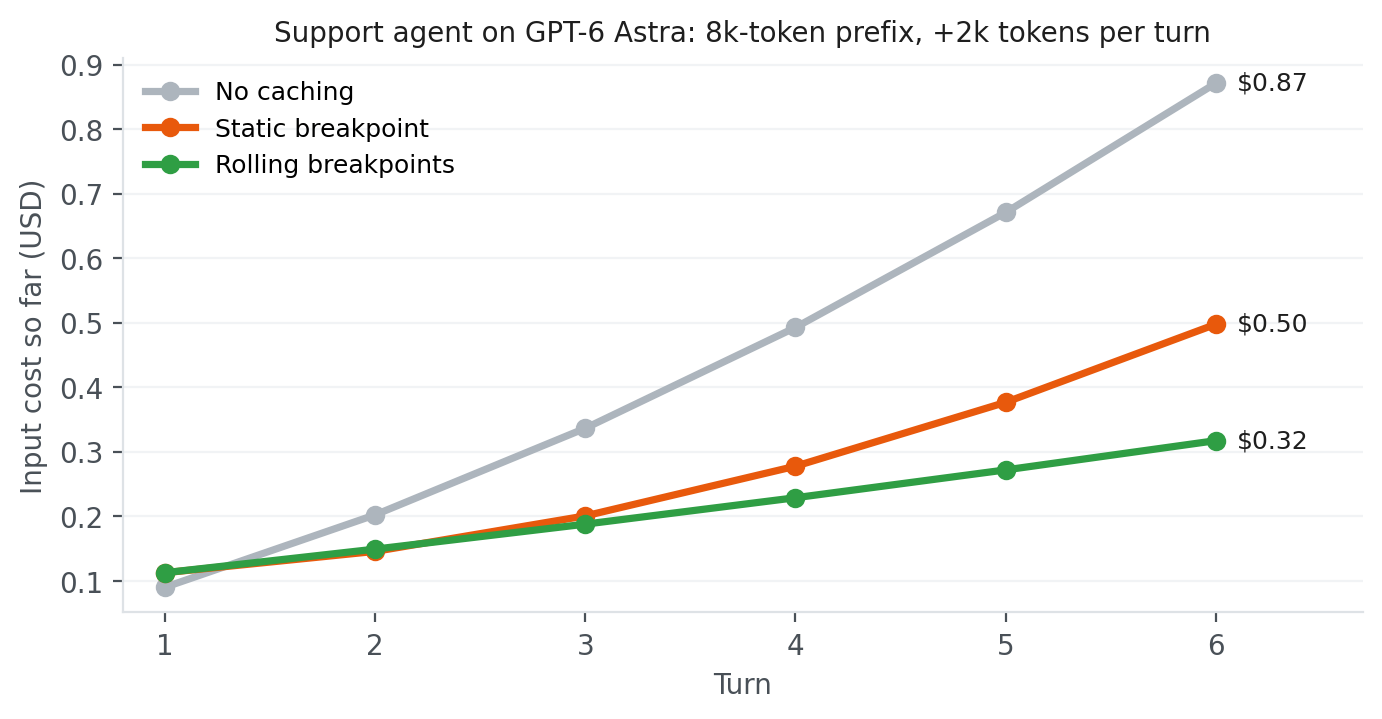
图 9:支持代理示例的每个会话的累积输入成本,使用 GPT-6 Astra 的 Amazon Bedrock 按需价格
如何判断缓存是否正常工作
从响应的使用开始。 cached_tokens 报告从缓存读取的输入,cache_write_tokens 报告写入缓存的输入。随着对话的发展,检查稍后是否会重用早期的历史记录,以及新的写入是否反映了正在添加的内容。
要对 Amazon Bedrock Runtime 终端节点进行生产监控,请使用 Amazon CloudWatch 中的“CacheReadInputTokenCount”和“CacheWriteInputTokenCount”指标。当您需要单独的请求记录时,启用模型调用日志记录,然后使用 Amazon CloudWatch Logs Insights 查询它们。对于 Amazon Bedrock Mantle 终端节点,在应用程序日志中记录响应使用字段。其 Amazon CloudWatch 命名空间目前没有单独的缓存计数器。
要检查成本,请将 AWS Cost Explorer 筛选到 Amazon Bedrock 并按 使用类型 进行分组。缓存读取、缓存写入和未缓存输入显示为每个模型的单独条目。在计算输入成本份额时排除输出令牌条目。
一个简短的清单
保持可重用前缀稳定。 首先放置共享工具和说明,然后附加对话历史记录和新回合。更改时间戳、消息或工具定义可防止在更改之外重复使用。如果较短的前缀有自己保存的端点,则仍然可以重复使用。 选择要重用的内容周围的边界。 使用隐式缓存来增长历史记录,使用显式标记来共享前缀,或两者兼而有之。仅显式模式避免编写一次性后缀。扩展仅显式对话时,请保留较早的标记,以便以后的请求可以找到保存的前缀。 保持初始工具目录不变。 使用 allowed_tools 来限制哪些工具是可调用的。使用“additional_tools”附加已知定义,或通过命名空间客户端“tool_search”发现它们。当不同的代理角色需要不同的目录时,选择稳定的工具配置文件。 检查前缀大小和生命周期。 可缓存前缀必须包含至少 1,024 个令牌。缓存的前缀在最近一次写入或成功重用后至少 30 分钟内仍然可以重用。 在启动帮助程序之前预热共享内容。 在预热和帮助程序请求中标记共享前缀,包括使用隐式模式时。在开始并行调用之前完成预热请求。 使缓存密钥在每个共享组内保持稳定。 打算重用前缀的请求必须使用相同的密钥。单独的密钥可以使客户或用户之间的缓存核算保持不同。 测量整个工作流程中的节省。 缓存写入成本是正常输入速率的 1.25 倍。请阅读价格取决于型号。使用开发期间的响应使用情况以及生产中的监控和计费数据来跟踪写入成本和读取节省。
2 月 3 日醒来
比尔·默里只有在不再重复同样的错误并开始将这一天所学到的知识运用到第二天时,才能逃脱土拨鼠之日。代理以类似但不那么浪漫的方式到达那里:通过保持提示字节的开始逐字节稳定,并随着历史记录的增长使用自动或显式缓存边界。
在这篇文章中,我们介绍了如何缓存共享工具和指令,在代理轮流中增加缓存,以及在添加工具、启动帮助程序或启动新会话时保持重用。保持共享前缀稳定并随着工作流程的进展附加新信息。使用隐式缓存来增加对话,使用显式断点来共享内容。当您需要两者时将它们组合起来,或者当更改的后缀不太可能被重用时选择仅显式模式。比较缓存读取、写入、总输入成本和延迟,找到最适合您的代理的方案。要应用这些模式,请遵循 OpenAI 模型的 Amazon Bedrock 提示缓存文档 并检查 按 AWS 区域和终端节点划分的模型可用性。从一个工作流程开始,随着对话的发展衡量节省的费用。
关于作者