在线AI教程 / AI工具
[Amazon Bedrock] Fleet-wide computer vision lifecycle at the edge with SageMa…
人工智能 使用 SageMaker SDK v3 实现边缘的整个舰队计算机视觉生命周期 当质量检查概念验证成功时,整个车队的计算机视觉模型生命周期管理就会出现问题。一台相机和一台模
人工智能
使用 SageMaker SDK v3 实现边缘的整个舰队计算机视觉生命周期
当质量检查概念验证成功时,整个车队的计算机视觉模型生命周期管理就会出现问题。一台相机和一台模型工作正常。然后,工厂要求 40 条生产线获得相同的结果,每条生产线都有多个摄像机,每个摄像机看到的世界都不同。每个都有不同的角度,同一不锈钢表面的不同眩光,以及不同的环境光,具体取决于打开的隔间门。在我们进行的生产部署中,在池化镜头上训练的单个模型的性能低于足够多的单个摄像机,以至于每个摄像机最终都有自己的微调模型。现在真正的问题不再是训练好一个模型。它可以对数千个产品进行培训、评估、版本控制和交付,而每个产品都无需人工参与。
本文更新了 2023 系列中针对当前 Amazon SageMaker Python SDK 构建端到端 MLOps 管道以在边缘进行视觉质量检查的模式v3。它使用 Amazon SageMaker Neo 取代了已弃用的 Amazon SageMaker Edge Manager,以实现边缘优化。我浏览了一个双分支 Amazon SageMaker Pipeline,该管道为每个摄像头训练一个异常检测器和一个缺陷分类器,并通过质量门来阻止表现不佳的模型。管道内的 SageMaker Neo 编译步骤可确保每个注册的模型都附带设备优化的工件,并且 AWS Step Functions 编排层负责队列训练。您可以使用 AWS 云开发套件 (AWS CDK) 部署所有内容,并且在合成数据上运行的完整管道的计算成本约为 0.07 美元。
完整的示例可在 aws-samples GitHub 存储库 中获取。
解决方案概述
下图显示了示例的整个车队范围的模型生命周期。编排层对重新训练请求进行排队并限制并发工作。每个摄像头的训练管道准备数据、训练和评估异常检测器和分类器,并为边缘设备生成版本化的模型工件。
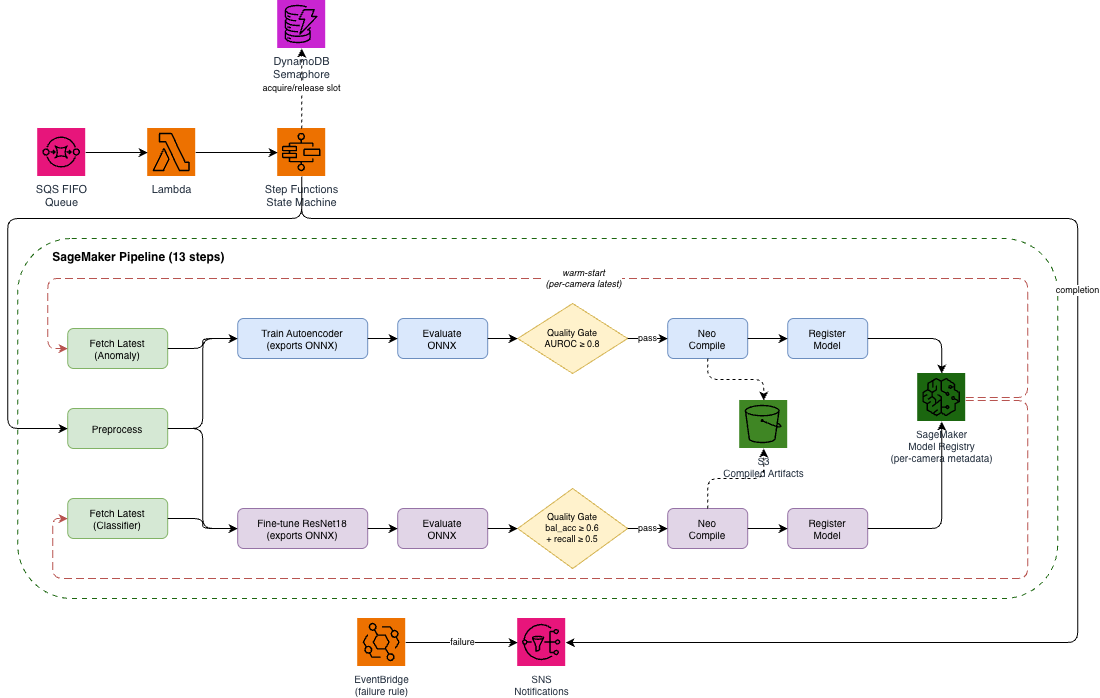
图 1:解决方案架构
训练部分是单个 SageMaker Pipeline,由摄像头参数化,每次执行运行 13 个步骤。三个输入步骤并行运行:预处理、获取最新异常和获取最新分类器。管道预处理相机的图像并为每个分支获取相机最新批准的模型,然后训练两个模型。第一个是一个小型卷积自动编码器,它了解正常产品的样子并通过重建错误标记异常。第二个是经过微调以确认缺陷的 ResNet18 分类器。每个分支将其模型导出到 ONNX,根据保留的数据评估导出的工件,并通过质量门。经过大门后,模型将使用 SageMaker Neo 为配置的边缘目标进行编译,然后才在 SageMaker 模型注册表中注册。因此,每个批准的软件包都有一个设备就绪的编译工件。包携带相机 ID 作为元数据,并且每个分支的热启动获取过滤器,因此重新训练始终从该相机自己的历史记录中恢复。
编排使舰队速度减半。重新训练请求到达 Amazon Simple Queue Service (Amazon SQS) FIFO 队列,AWS Lambda 函数针对每个请求启动 Step Functions 执行。每次执行在启动其管道之前都会通过 DynamoDB 信号量获取一个槽,因此突发请求会以稳定的速率耗尽,而不是一次性全部启动。完成会发布到 Amazon Simple Notification Service (Amazon SNS),操作失败会通过 Amazon EventBridge 规则到达同一主题,并保留原始错误。
系统的输出是版本化的、质量门控的、每个相机的模型工件。模型注册表保存可移植的 ONNX,S3 保存该模型的 Neo 编译版本,它是由 DLR 运行时而不是 ONNX 加载的设备优化共享库。两者都已准备好适用于您的工厂使用的任何输送机制。
先决条件
要部署示例,您需要以下内容:
有权创建 AWS Identity and Access Management (IAM) 角色的 AWS 账户。 Amazon Simple Storage Service (Amazon S3) 存储桶。 Amazon Elastic Container Registry (Amazon ECR) 存储库。 堆栈中的 SageMaker AI、AWS Step Functions、AWS Lambda、Amazon Simple Queue Service (Amazon SQS)、Amazon Simple notification Service (Amazon SNS)、Amazon EventBridge 和 Amazon DynamoDB 资源。 Python 3.10、3.11 或 3.12、Docker。 AWS CDK CLI 版本 2.1131.0 或更高版本。
以前的 CLI 版本因云程序集架构与最新版本的“aws-cdk-lib”不匹配而失败。无需增加服务配额。默认情况下,编排层一次最多允许执行 5 个管道,这将并发 SageMaker 训练作业保持在标准帐户配额内。
如果您部署到 CLI 默认值以外的 AWS 区域,请在部署命令本身而不是在 shell 配置文件中设置“AWS_REGION”、“AWS_DEFAULT_REGION”和“CDK_DEFAULT_REGION”这三个区域,例如,“AWS_REGION=us-east-2 AWS_DEFAULT_REGION=us-east-2 CDK_DEFAULT_REGION=us-east-2 cdk deploy” --全部`。 CDK CLI、Boto3 和 AWS 命令行界面 (AWS CLI) 通过重叠但不相同的变量集解析区域,不匹配会导致部分部署混乱。为命令添加前缀仅设置该调用的所有三个区域,因此您自己的默认区域保持不变。
使用 SDK v3 定义训练管道
本节中的代码摘自存储库中的 CDK 应用程序,而不是独立脚本,并且它在 cdk 部署期间运行,此时堆栈综合了管道定义。环境设置和部署命令稍后在部署和运行示例下进行。 SDK v3 将 SageMaker Python SDK 重新组织为模块化包,导入显示了库的新形态:
from sagemaker.train import ModelTrainer from sagemaker.train.configs import InputData, Compute, OutputDataConfig from sagemaker.core.training.configs import MetricDefinition from sagemaker.serve.model_builder import ModelBuilder from sagemaker.mlops.workflow.pipeline import Pipeline from sagemaker.mlops.workflow.steps import ProcessingStep, TrainingStep from sagemaker.mlops.workflow.model_step import ModelStep from sagemaker.mlops.workflow.condition_step import ConditionStep from sagemaker.core.workflow.conditions import ConditionGreaterThanOrEqualTo from sagemaker.core.workflow.functions import JsonGet
安装 sagemaker>=3.0.0,<4 会将 sagemaker-core、sagemaker-train、sagemaker-serve 和 sagemaker-mlops 作为单独的软件包引入。 v2 跨“Estimator”构造函数参数传播的训练配置现在位于传递给“ModelTrainer”的类型化配置对象中。这是异常分支的训练器,来自样本的逐字记录:
anomalib_trainer = ModelTrainer( training_image=custom_training_image_uri, compute=Compute( instance_type=training_instance_type.to_string(), instance_count=1, ), base_job_name="cv-pipeline-anomalib-train", sagemaker_session=pipeline_session, role=role_arn, hyperparameters={ "program": "train_anomalib.py", "model_name": "autoencoder", "image_size": "256", "num_epochs": "3", "batch_size": "16", "learning_rate": "0.001", }, input_data_config=anomalib_input_data, output_data_config=OutputDataConfig( s3_output_path=run_prefix("anomalib-training") ), ).with_metric_definitions( [ MetricDefinition( name="image_auroc", regex=r"validation:image_auroc=([0-9]*\.?[0-9]+)", ), ] )
“anomalib_input_data”从上游步骤属性连接四个通道(“train”、“validation”、“test”、“pretrained_model”),而“run_prefix”将每个 S3 路径范围限定到管道执行 ID,因此并发队列运行绝不会发生冲突。两者都在存储库中。
当管道位于 CDK 应用程序内部时,两个 v3 行为很重要,并且两者都不会作为重大更改出现在变更日志中。首先,SDK v3 在构建管道定义时根据实时 IAM 验证管道的执行角色。此验证发生在综合时而不是执行时。 CDK 应用程序无法在一次部署中创建角色和管道,因为当 SDK 验证角色时该角色还不存在。这与 cdk bootstrap 是分开的,后者为每个账户和区域配置一次 CDK 工具包资源,并且可能已经在您的账户中完成。该示例自己的两阶段部署是由恰好共享该名称的上下文标志驱动的。使用“-c bootstrap=true”的初始传递创建角色、存储桶和 ECR 存储库,第二传递根据现有角色合成管道。管道定义中嵌入的角色 Amazon 资源名称 (ARN) 也必须是具体字符串,而不是未解析的 CDK 令牌。
其次,v3 角色验证器在没有资源 ARN 的情况下模拟 ECR 拉取权限,因此作用域为单个 ECR 存储库的执行角色无法验证,即使它可以在运行时运行。因此,样本的角色获得了更广泛的 ECR 资助。
最后,示例使用的一个 v3 习惯:使用 PipelineSession(default_bucket=your_bucket) 构建管道,将 SDK 管理的上传(例如步骤代码)路由到管道自己的存储桶中,因此每个工件都位于一个位置,并且执行角色的权限覆盖单个存储桶。 (授予角色对 SDK 默认存储桶的访问权限也可以。这种方法更简洁。)
与缺陷数据行为方式相匹配的质量门
每个经过训练的模型在注册之前都会进行评估,并且评估针对导出的 ONNX 工件而不是内存中的 PyTorch 模型运行。这种区别很重要:您门控的工件就是您交付的工件,因此导出问题永远不会让损坏的模型失去看起来健康的训练运行。
AUROC 上的异常分支门至少为 0.8。分类器分支同时对两个指标进行门控,指标的选择由缺陷数据的定义属性决定:严重的类别不平衡。在此示例中,大约 90% 的图像效果良好,这对于生产线来说是现实的。相对于这种分布,简单的准确率是没有意义的,因为预测每张图像“良好”的模型得分约为 0.9,同时发现零缺陷。平衡准确度(每类召回的平均值)可以纠正这一点,但它有自己的盲点。对于良好部件具有完美召回率而对于缺陷部件仅有 20% 召回率的模型仍然得分 (1.0 + 0.2) / 2 = 0.6。因此,门要求至少 0.6 的平衡准确度和至少 0.5 的缺陷召回率:
step_check_classifier = ConditionStep( name="CheckClassifierQuality", conditions=[ ConditionGreaterThanOrEqualTo( left=JsonGet( step_name=step_eval_classifier.name, property_file="evaluation", json_path="balanced_accuracy", ), right=min_accuracy, ), ConditionGreaterThanOrEqualTo( left=JsonGet( step_name=step_eval_classifier.name, property_file="evaluation", json_path="defect_recall", ), right=min_defect_recall, ), ], if_steps=[step_compile_classifier, step_register_classifier], else_steps=[step_fail_classifier], depends_on=[step_eval_classifier], )
“ConditionStep”对其条件进行 AND 运算,因此两者都必须通过。阈值是管道参数,每次执行时均可调整,无需重新部署。如果门失败,“FailStep”标记执行失败,并且该分支的模型永远不会到达注册表(两个分支独立门,因此另一个分支的模型仍然可以注册)。该机队继续为该相机之前批准的型号提供服务。
训练代码从另一方面解决了同样的不平衡问题。该分类器是一个经过微调的“resnet18”,具有 ImageNet 权重和两类头。对于每个相机的数据集大小,微调预训练权重可以防止模型崩溃到多数类别。训练代码使用逆类频率通过“WeightedRandomSampler”平衡训练批次,而损失保持未加权。将加权损失与加权采样相结合会过度校正少数群体。
在管道内使用 SageMaker Neo 进行边缘编译
请注意前面代码中门的“if_steps”:经过门,编译首先运行,注册取决于它。两个训练脚本都导出带有动态批处理轴的 ONNX。质量门对 ONNX 运行时下导出的工件进行评分,然后“CompileAnomalibNeo”或“CompileClassifierNeo”步骤将门控工件交给 SageMaker Neo。不变量是门,然后编译,然后注册。仅当模型也针对队列的边缘目标进行编译时,它才会成为已批准的包,因此注册表绝不会公布设备无法运行的模型。
编译步骤封装了三个容易出错的细节。 Neo 要求输入 tarball 仅包含模型文件,但训练作业会与 ONNX 模型一起发出带有检查点和指标的“model.tar.gz”。该步骤首先重新打包仅限 ONNX 的 tarball。 Neo 还需要具体的输入形状,同时导出声明动态批处理轴,因此批处理大小 1 固定在编译请求中。由于管道步骤可以重试,因此编译作业名称确定性地从执行 ID 派生,因此重试会继续轮询已启动的作业,而不是孤立它。
target 是一个管道参数: NeoTargetDevice 选择一个命名设备,例如 jetson_xavier 或 rasp4b,其默认编译为 NeoTargetOs/NeoTargetArch 平台,默认为 LINUX/X86_64。编译后的包包含优化的“compiled.so”以及用于加载它的DLR运行时。默认输出在任何 x86_64 Linux 主机上运行,因此您可以在提交到特定于设备的目标之前对其进行验证。编译本身不收取任何费用。您需要为驱动它的处理实例以及输出的 S3 存储付费。为了稍后为其他设备类型编译已注册的模型,无需重新训练,存储库包含一个针对模型注册表运行相同流程的临时脚本。
模型注册表中的每个相机模型
每个分支注册到自己的模型包组中,每个包都携带相机ID及其评估指标。从示例中,省略了指标接线:
classifier_model_builder = ModelBuilder( s3_model_data_url=classifier_model_data, image_uri=custom_training_image_uri, sagemaker_session=pipeline_session, role_arn=role_arn, ) step_register_classifier = ModelStep( name="RegisterClassifierModel", depends_on=[step_compile_classifier], step_args=classifier_model_builder.register( model_package_group_name="sm1k-classifier-model-group", approval_status="Approved", model_metrics=classifier_metrics, customer_metadata_properties={"CameraId": camera_id}, ), )
“customer_metadata_properties”中的相机标识将两个共享包组转变为一个队列目录。来自所有摄像机的包位于同一组中,并且通过过滤元数据来恢复每个摄像机的历史记录。每个分支都有一个获取步骤,该步骤会按最新的顺序对批准的包进行分页,直到找到请求相机的最新型号,因为“ListModelPackages”无法在客户元数据服务器端进行过滤。在相机第一次运行时,获取什么也找不到,训练又回到冷启动初始化(分类器的 ImageNet 权重、自动编码器的随机初始化)。以后的每次运行都会从该摄像机自己的先前模型恢复,这使得在整个机群中进行频繁、廉价、增量的重新训练变得可行。
请注意这些注册表项是什么和不是:它们对版本化、质量门控的工件进行分类,但它们的容器引用是训练图像,它不提供任何推理端点。它们存在于队列工作流中,其中下游系统提取工件并将其运送到设备,而不是“CreateEndpoint”。
协调舰队训练请求
每个 AWS 账户都有并发 SageMaker 训练作业的服务配额,并且这里的每个管道执行都会启动多个作业,因此队列重新训练需要调整节奏。必须采取某种措施来阻止 500 个请求的爆发变成 500 个同时管道启动。该示例使用信号量,即可用插槽的计数器,其工作方式类似于具有五个车位的停车场。在 Step Functions 状态机启动管道之前,它会通过原子递增 DynamoDB 中的计数器来占用一个槽,条件是一旦达到上限就拒绝递增:
acquire_semaphore = tasks.DynamoUpdateItem( self, "AcquireSemaphore", table=semaphore_table, key={"LockName": tasks.DynamoAttributeValue.from_string("pipeline-concurrency")}, update_expression="SET ActiveCount = if_not_exists(ActiveCount, :zero) + :one", condition_expression="attribute_not_exists(ActiveCount) OR ActiveCount < :limit", )
如果所有槽都被占用,则执行将等待并重试。当其管道完成时,它会递减计数器以释放插槽。有一个细节值得纳入您自己的设计中。 DynamoDB 条件表达式在单个原子操作中强制执行上限,而不是由状态机读取计数器并做出决定,这会在读取和写入之间留下竞争窗口。该存储库实施其余的操作强化,包括释放每个故障路径上的槽以及通过 Amazon EventBridge 将失败的执行转发到 Amazon SNS。它的自述文件涵盖了等待范围的大小。
上限为 5 是一个堆栈参数,设置较低,以便示例可以在任何标准帐户中部署和运行,而无需请求增加配额。将其调整为您帐户的培训作业配额支持的任何内容。超过单个账户的配额后,扩大车队培训规模就是一个单独的主题。标准杠杆是提高服务配额、跨实例类型或区域分散培训以及跨多个账户分配队列。您还可以在 SQS 中保留积压工作,仅在产能释放时才允许工作。这些选择取决于您的舰队的规模和形状。该示例为您提供了可扩展的工作框架。
部署并运行示例
存储库 README 中的演练是权威版本。以下简短形式从干净的签出开始,并在第一次部署之前设置环境:
git clone cd sample-sagemaker-fleet-cv-pipeline && python3 -m venv .venv && source .venv/bin/activate pip install -r requirements.txt cdk bootstrap # once per account/region cdk deploy SageMakerCVPipelineStack -c bootstrap=true # roles, bucket, ECR cdk deploy --all # pipeline + orchestration ./scripts/push_ecr_image.sh # build and push training image
默认情况下,管道生成合成生产线图像,因此您可以端到端验证整个系统,无需数据集和数据批准。完整运行会在大约 15 分钟内执行所有 13 个步骤,包括 Neo 编译,并且在“ml.m5.xlarge”计费时间中花费大约 0.07 美元(美国东部(俄亥俄)区域 (us-east-2),2026 年 7 月,按需)。以样本规模计算,编排资源每月的总成本远低于 0.10 美元。
为了在真实图像上练习管道,存储库包含一个 BCCD 数据集 的下载器。该数据集是 364 个带注释的血涂片显微镜图像的集合,最初在 GitHub 上开源,并在 MIT 许可下重新组织为 Pascal VOC 格式。相同的数据集也由 Roboflow 作为公共域进行分发。该脚本将血小板的存在映射到缺陷类别,可选择分割每个摄像机的图像以模拟机群,并将训练 tarball 上传到管道桶。随附的笔记本对真实数据运行完整的管道,并对正常和异常样本进行并行 ONNX 推理。将血小板视为缺陷是制造缺陷分布的说明性替代,而不是临床声明。
清理
模型包是在管道运行时创建的,因此 AWS CloudFormation 无法删除它们。首先使用 AWS CLI 删除它们,然后使用“cdk destroy --all -c bootstrap=true --force”销毁堆栈。 自述文件列出了确切的命令。
结论
在这篇文章中,我展示了适用于车队规模计算机视觉生命周期的有效 SageMaker SDK v3 参考架构。该架构包括一个双分支训练管道,其中每个模型都在其导出的 ONNX 工件上进行质量控制,使用 SageMaker Neo 进行编译,然后才进行注册。模型注册表布局使用相机元数据将共享包组转换为每个相机的可热启动历史记录,并且 Step Functions 编排层在帐户配额内调整队列训练。对于通过 Amazon Lookout for Vision 等托管选项满足其需求的团队来说,这是更简单的路径。此模式针对的是托管选项未涵盖的每个摄像机、机群规模的限制。设计规则超越了计算机视觉:平衡准确性加上少数类召回而不是准确性,评估和编译您交付的工件,并通知操作故障而不是静默终止。
该示例在几分钟内即可部署,完整的验证运行成本约为 7 美分的计算成本,因此低成本的下一步是克隆 存储库 并运行它。从那里,将 BCCD 下载器指向真实的存储桶,为您的硬件设置“NeoTargetDevice”,或根据您的队列调整编排范围的大小。对于 SDK v3 迁移本身,SageMaker Python SDK 文档 和宣布新 SDK 的两部分系列是我始终保持开放的参考资料。
如果您需要帮助将此模式适应您的生产环境,请联系您的 AWS 客户团队。
关于作者