在线AI教程 / 免费资源
[OpenRouter] 如何用 LLM 从 PDF 中提取表格
如何用 LLM 从 PDF 中提取表格 OpenRouter ·10/29/2026 要用 LLM 从 PDF 中提取表格,把 PDF 发给能读取文件的模型,同时配上一份严格 JS
如何用 LLM 从 PDF 中提取表格
OpenRouter ·10/29/2026
要用 LLM 从 PDF 中提取表格,把 PDF 发给能读取文件的模型,同时配上一份严格 JSON schema,用来描述表格中的一行。模型返回的是带类型的行。数量会以整数返回,写成 (3,878) 的亏损会变成 -3878,跨两页的表格会作为一个列表返回。
我们在五个 PDF 上测试了这套做法,其中两个是扫描件。每个直接读取 PDF 的模型都把 644 个单元格全部答对。我们测试中的失败来自 PDF 抵达模型所走的路径,其中两次还返回了看起来正常、却没有任何报错的响应。
摘要
为一行设定的严格 JSON schema 能把 PDF 表格变成带类型的行,字段描述则负责清理括号表示的负数、脚注标记之类的问题。 在我们的测试中,能读 PDF 的模型对数字文件和扫描件都能处理。读不了 PDF 的模型需要用 mistral-ocr 解析器处理扫描件。 扫描件走免费的 cloudflare-ai 解析器会返回零行且不报错,所以要拒绝空结果。 长表格可能撞上输出 token 上限而中断,所以任何 finish_reason 为“length”的响应都要拒绝。
开始之前
运行下面的示例需要准备以下内容。
一个有额度的 OpenRouter 账户,以及一个存放在 OPENROUTER_API_KEY 环境变量里的 API key。本指南用到的模型都是付费的。 Python 3.10 或更高版本,以及 requests 包(pip install requests)。 Node.js 18 或更高版本,但只在接近末尾的 TypeScript 版本里用得上。 一份包含表格的 PDF,可以是数字导出件,也可以是扫描件。
如果你之前没调用过 API,快速入门会演示第一个请求。
这套代码对数字 PDF 和扫描件都适用,但结果取决于 PDF 有没有文本层、扫描质量、解析器路径和模型。示例用的是我们用已知数据生成的五个测试 PDF,这样每个单元格都能对照原始数据核对。它们分别是一张发票、一份季度报告、一份有 58 行、延伸到第二页的出货记录、一份扫描版采购订单,以及一份刻意做得很粗糙、带合并单元格的扫描件。
第 1 步:怎么发送 PDF 并拿回行?
把下面代码保存为 extract_tables.py。它按我们 PDF inputs 页面上的说明,把 PDF 作为文件内容部分发送,并通过 Structured outputs 要求返回符合你的 schema 的 JSON。把 strict 设为 true 后,支持严格模式的 provider 会让输出严格贴合 schema,于是每一行都带着全部字段且类型正确。各 provider 的支持程度不同,Structured outputs 页面说明了如何只路由到支持的 provider。
import base64 import json import os
import requests
API = "https://openrouter.ai/api/v1/chat/completions" HEADERS = {"Authorization": f"Bearer {os.environ['OPENROUTER_API_KEY']}"}
def rows_schema(fields): """Wrap the fields of one row in a strict schema for {"rows": [...]}.""" return { "type": "object", "properties": {"rows": {"type": "array", "items": { "type": "object", "properties": fields, "required": list(fields), "additionalProperties": False}}}, "required": ["rows"], "additionalProperties": False, }
def extract_table(pdf_path, schema, model="anthropic/claude-haiku-5.5", engine=None, max_tokens=8000): with open(pdf_path, "rb") as f: data_url = "data:application/pdf;base64," + base64.b64encode(f.read()).decode() body = { "model": model, "max_tokens": max_tokens, "messages": [{"role": "user", "content": [ {"type": "text", "text": "Extract every row of the table in this PDF. " "Include rows from every page. " "Return only rows that are in the document."}, {"type": "file", "file": {"filename": os.path.basename(pdf_path), "file_data": data_url}}, ]}], "response_format": {"type": "json_schema", "json_schema": {"name": "table", "strict": True, "schema": schema}}, } if engine: body["plugins"] = [{"id": "file-parser", "pdf": {"engine": engine}}]
response = requests.post(API, headers=HEADERS, json=body, timeout=300) response.raise_for_status() data = response.json() choice = data["choices"][0] if choice["finish_reason"] == "length": raise ValueError(f"Output stopped at max_tokens={max_tokens}. " "Raise it or split the PDF.") rows = json.loads(choice["message"]["content"])["rows"] if not rows: raise ValueError("No rows came back. If this PDF is a scan, use a model " "that reads PDFs or engine='mistral-ocr'.") return rows, data["usage"]["cost"]
LINE_ITEMS = rows_schema({ "sku": {"type": "string"}, "description": {"type": "string"}, "qty": {"type": "integer"}, "unit_price": {"type": "number", "description": "USD, no currency symbol or thousands separator"}, "amount": {"type": "number", "description": "USD, no currency symbol or thousands separator"}, })
return 之前的两个检查能捕获第 3 步和第 4 步讲到的那些失败,所以请把它们保留下来。费用来自 usage.cost,用量计费在每个响应里都会给出这个值。
在发票上跑一下这个函数。
from extract_tables import extract_table, LINE_ITEMS
rows, cost = extract_table("invoice.pdf", LINE_ITEMS) for row in rows[:3]: print(row) print(f"{len(rows)} rows, ${cost:.5f}")
{'sku': 'NW-4100', 'description': 'Hex bolt M8x40', 'qty': 100, 'unit_price': 60.67, 'amount': 6067.0} {'sku': 'NW-4107', 'description': 'Flange nut M8', 'qty': 2, 'unit_price': 41.72, 'amount': 83.44} {'sku': 'NW-4114', 'description': 'Bearing 6204-2RS', 'qty': 10, 'unit_price': 52.59, 'amount': 525.9} 10 rows, $0.00067
这次调用大约花了六秒。PDF 上写的是 6,067.00,而这一行里存的是 6067.0,这是一个不用先清洗就能直接相加的数。千位分隔符是被字段描述去掉的。
第 2 步:怎么处理合并单元格、括号和脚注?
PDF 表格需要的清理,大部分都能放进 schema 的字段描述里。我们的季度报告有一个横跨四个季度列的 “Fiscal 2026” 表头,有用括号写出的亏损,还有两个分部名称(Enterprise 和 Hardware resale)上的脚注标记。括号和脚注标记由字段描述处理。横跨的表头不需要描述,因为字段名已经说明了每个值属于哪个季度。
from extract_tables import extract_table, rows_schema
THOUSANDS = {"type": "integer", "description": "Thousands of USD. A value in parentheses, like (1,204), is negative: -1204."} QUARTERLY = rows_schema({ "segment": {"type": "string", "description": "Segment name without footnote markers"}, "q1": THOUSANDS, "q2": THOUSANDS, "q3": THOUSANDS, "q4": THOUSANDS, "fy_total": THOUSANDS, })
rows, cost = extract_table("quarterly.pdf", QUARTERLY) for row in rows: print(row)
{'segment': 'Inference API', 'q1': 1813, 'q2': 7299, 'q3': 1612, 'q4': 4422, 'fy_total': 15146} {'segment': 'Enterprise', 'q1': 1563, 'q2': 2981, 'q3': 5544, 'q4': 7667, 'fy_total': 17755} {'segment': 'Data products', 'q1': 3163, 'q2': 9658, 'q3': 2729, 'q4': 5854, 'fy_total': 21404} {'segment': 'Hardware resale', 'q1': 3761, 'q2': -3878, 'q3': -9774, 'q4': -1776, 'fy_total': -11667} {'segment': 'Professional services', 'q1': 8933, 'q2': 9511, 'q3': 7805, 'q4': 5946, 'fy_total': 32195} {'segment': 'Total operating income', 'q1': 19233, 'q2': 25571, 'q3': 7916, 'q4': 22113, 'fy_total': 74833}
在 Hardware resale 这一行里,(3,878) 返回成了 -3878,两个分部名称上的脚注标记也都不见了。
沿着一列向下延伸的合并单元格,处理方式是一样的。在我们那份粗糙扫描件里,每个 Category 单元格横跨六到九行。我们把这个字段描述成:“第一列中的类别。它是合并单元格,所以它覆盖的每一行都要重复填上。”在测试中,这让三个能读 PDF 的模型都在全部 30 行上填出了类别。
第 3 步:该用哪条解析器路径?
如果模型能读文件,我们直接把 PDF 交给它。如果不能,我们先解析 PDF,再把解析结果发给模型。file-parser 插件的 engine 设置决定用哪个解析器。当你在读不了文件的模型上不设置它时,我们会用 mistral-ocr,正如 PDF inputs 页面所说。按你的 PDF 长什么样来选路径。
能读 PDF 的模型。 不要设置 engine。Claude Haiku 5.5、GPT-6 Luna 和 Gemini 3.8 Flash 都能读文件,三个模型处理我们那两份扫描件都没问题。PDF 按输入 token 计费。 读不了 PDF 的模型,配 OCR。 用 engine="mistral-ocr",或者不设置。它先对每一页做光学字符识别(OCR),费用是每 1,000 页 $2,另外还要付模型的 token 费用。 读不了 PDF 的模型,配免费解析器。 只有当每个 PDF 都有文本层时才用 engine="cloudflare-ai"。导出的发票和报告有文本层,扫描件没有。
下面是把那份扫描版采购订单分别交给各个解析器、再发给 deepseek/deepseek-v4.1-flash 的代码。那个模型接受图片但不接受文件,所以 PDF 必须先经过解析器。
from extract_tables import extract_table, LINE_ITEMS
A model that can't read PDFs, with OCR in front of it
rows, cost = extract_table("scanned.pdf", LINE_ITEMS, model="deepseek/deepseek-v4.1-flash", engine="mistral-ocr") print(f"mistral-ocr: {len(rows)} rows, ${cost:.5f}")
The same model with the free text parser
rows, cost = extract_table("scanned.pdf", LINE_ITEMS, model="deepseek/deepseek-v4.1-flash", engine="cloudflare-ai")
mistral-ocr: 6 rows, $0.00211 ValueError: No rows came back. If this PDF is a scan, use a model that reads PDFs or engine='mistral-ocr'.
这个 ValueError 来自第 1 步里的空行检查。如果没有这个检查,第二次调用会返回 200 OK,finish_reason 为 "stop",内容是 {"rows": []}。解析器在扫描件上没找到任何文本,模型如实报告了空表。没有任何东西抛错,所以没有这个检查的流水线会存下零行,然后接着处理下一个文件。这是两种静默失败中的第一种。我们那份粗糙扫描件表现一样,30 行得了 0 分。
另外两种路径错误会明确报错。解析器名字拼错时会返回这个错误。
400 {"error":{"message":"plugins.0.pdf.engine: Invalid input","code":400}}
native 引擎只适用于能读文件的模型。我们还是给 DeepSeek V4.1 Flash 设了 engine="native",结果请求成功了一次,接着两次都以 provider 错误告终。
400 Provider returned error: "The request was rejected. Possible causes: input exceeds the model's maximum context length, or the request contains invalid parameters."
同一个模型不设 engine,我们两次尝试都成功了,所以别在读不了文件的模型上设 native。
第 4 步:我的长表格为什么回来时被截断了?
模型写下的每一行都要消耗输出 token,所以长表格需要较大的 max_tokens。我们那份 58 行的出货记录,视模型不同用了 2,500 到 7,700 个输出 token,这让最啰嗦的模型在 extract_table 默认的 8,000 之下几乎没有余量。折算下来每行 43 到 133 个 token。遇到长表格,可以按预计行数每个大约 150 个 token 起步。然后测量你自己的行数,并保留 finish_reason 检查,因为每行的开销随模型和 schema 而变。上限设得太低时会发生什么呢。
from extract_tables import extract_table, rows_schema
SHIPMENTS = rows_schema({ "date": {"type": "string", "description": "YYYY-MM-DD"}, "shipment_id": {"type": "string"}, "origin": {"type": "string"}, "destination": {"type": "string"}, "weight_kg": {"type": "number", "description": "No thousands separator"}, "status": {"type": "string"}, })
rows, cost = extract_table("shipments.pdf", SHIPMENTS, max_tokens=600)
ValueError: Output stopped at max_tokens=600. Raise it or split the PDF.
没有 finish_reason 检查的话,这个请求会以两种方式之一失败。直接解析 JSON 会在被截断的数组上抛错。
JSONDecodeError: Unterminated string starting at: line 1 column 627 (char 626)
第二种方式就是另一种静默失败。打开 Response Healing 插件后,JSON 能解析了,58 行里只拿到 5 行,却没有抛出任何异常。Healing 修复的是输出的语法,它的文档也提醒说无法恢复被 max_tokens 截断的输出,所以补不回模型压根没写的那些行。finish_reason 检查能同时抓住这两种情况。
第 5 步:怎么把这些行写成 CSV?
每一行都带着 schema 中定义的键,所以 csv.DictWriter 可以直接从 schema 取列名,并把行原样写出去。Excel 可以直接打开结果。
import csv
from extract_tables import extract_table
Define SHIPMENTS here, copied from step 4
rows, cost = extract_table("shipments.pdf", SHIPMENTS, model="openai/gpt-6-luna") with open("shipments.csv", "w", newline="") as f: fieldnames = list(SHIPMENTS["properties"]["rows"]["items"]["properties"]) writer = csv.DictWriter(f, fieldnames=fieldnames) writer.writeheader() writer.writerows(rows) print(f"Wrote {len(rows)} rows to shipments.csv (${cost:.5f})")
Wrote 58 rows to shipments.csv ($0.00130)
date,shipment_id,origin,destination,weight_kg,status 2026-09-01,SHP-88200,Savannah,Valencia,8754.6,In transit 2026-09-01,SHP-88213,Busan,Los Angeles,2074.7,Customs hold
表格延伸到了第二页,表头在那里也重复了一次。CSV 里只有一个表头和全部 58 行。
该用哪个模型?
我们把每条路径都在五个 PDF 上跑了一遍,共六页、644 个单元格,逐个单元格与生成这些 PDF 的原始数据比对。每次运行都用的是上面的 extract_table 函数和提示词,并采用我们默认的 provider 路由。每 1,000 页的成本是这六页的 usage.cost 总额再按比例放大。模型和价格取自我们 2026 年 10 月 8 日的模型目录。这些结果描述的是这组测试数据,不代表模型的普遍表现。
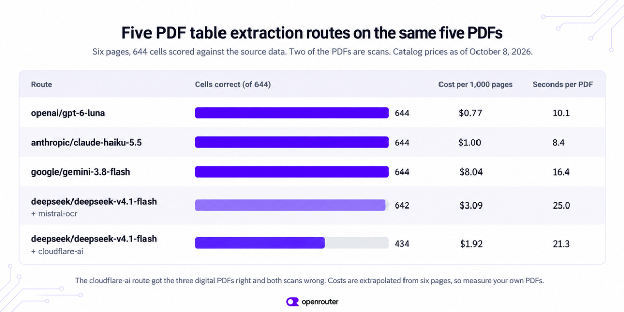
在这组测试数据上,GPT-6 Luna 和 Claude Haiku 5.5 是既能把每个单元格都答对、又最便宜的两条路径,在那份粗糙扫描件上也是如此,而且两者的标价都是每百万输入 token $0.10。这让它们适合先在你自己的 PDF 上试一轮。Gemini 3.8 Flash 准确率完全一样,但在同样这些文件上每页成本要高八到十倍。它的标价是每百万输入 token $1.50,2026 年 10 月 21 日起优惠到 $0.75。
OCR 路径的实际花费比 DeepSeek 那个看起来很低的 token 价格暗示的要高,因为 OCR 的每 1,000 页 $2 会加到每一次请求上,你能在 usage.cost 里看到。它错的两处是 Enterprise 和 Hardware resale 上的脚注标记,尽管 schema 要求去掉,它还是保留了。免费解析器把三个数字 PDF 全做对了,两个扫描件则完全做错。
成本这一列是从每条路径的六页外推出来的。用它来比较各条路径,然后在选定之前,用一套黄金 eval 集在你自己的 PDF 样本上测准确率、耗时和成本,因为内容更密的页面更贵,其他版式也可能表现不同。
什么时候用 PDF 库就够了?
如果你的 PDF 全是数字件,而且每张表格都只有一行表头,那么像 pdfplumber 这样的免费库就能把表格找出来。我们在同样的文件上跑过它。它在三个数字 PDF 里找出了每一张表,并把每个单元格都返回成字符串,比如 ‘6,067.00’ 或 ‘(3,878)’。季度报告的两级表头被返回成两行,合并单元格里是 None;出货记录则被返回成两张独立的表,每页一张。它在两份扫描件里什么都没找到,因为扫描件没有文本层可读。
所以,当你的表格简单、PDF 是数字件时,用库就够了。一旦你开始为合并表头、分页和数字格式写清理代码,第 2 步里的 schema 反而更省事。
同样的请求,用 TypeScript 写
请求体在任何语言里都一样。把下面代码保存为 extract.mjs,在 Node.js 18 或更高版本上用 node extract.mjs invoice.pdf 运行。
import { readFileSync } from "node:fs"; import { basename } from "node:path";
const path = process.argv[2]; const fileData = data:application/pdf;base64,${readFileSync(path).toString("base64")};
const money = { type: "number", description: "USD, no currency symbol or thousands separator" }; const schema = { type: "object", properties: { rows: { type: "array", items: { type: "object", properties: { sku: { type: "string" }, description: { type: "string" }, qty: { type: "integer" }, unit_price: money, amount: money }, required: ["sku", "description", "qty", "unit_price", "amount"], additionalProperties: false } } }, required: ["rows"], additionalProperties: false, };
const res = await fetch("https://openrouter.ai/api/v1/chat/completions", { method: "POST", headers: { Authorization: Bearer ${process.env.OPENROUTER_API_KEY}, "Content-Type": "application/json" }, body: JSON.stringify({ model: "openai/gpt-6-luna", messages: [{ role: "user", content: [ { type: "text", text: "Extract every row of the table in this PDF. Include rows from every page. Return only rows that are in the document." }, { type: "file", file: { filename: basename(path), file_data: fileData } }, ] }], response_format: { type: "json_schema", json_schema: { name: "table", strict: true, schema } }, }), }); if (!res.ok) throw new Error(HTTP ${res.status}: ${await res.text()}); const data = await res.json(); const choice = data.choices[0]; if (choice.finish_reason !== "stop") throw new Error(Unexpected finish_reason: ${choice.finish_reason}); const { rows } = JSON.parse(choice.message.content); if (rows.length === 0) throw new Error("No rows came back."); console.log(rows.length + " rows, finish_reason=" + choice.finish_reason + ", $" + data.usage.cost);
10 rows, finish_reason=stop, $0.00020275
脚本先检查 HTTP 状态码,再做和 Python 版同样的两个检查。除非 finish_reason 为 “stop” 且 rows 至少有一行,否则它就停下。
结论
用 LLM 从 PDF 中提取表格只需要一次请求:把 PDF 作为文件部分发过去,再给一份描述单行的严格 schema。在我们的测试中,准确性来自模型直接读取 PDF,风险则来自 PDF 所走的路径。扫描件上的文本解析器和长表格上的 token 上限,返回的响应看起来都很正常。extract_table 里的两个检查能抓住这两种情况,所以无论你跑的是代码的哪个版本,都请保留它们。在确定一条路径之前,先拿你自己 PDF 的一批样本跑一遍,比较行数、耗时和 usage.cost。
常见问题
LLM 能读扫描版 PDF 吗?
能,前提是模型直接读取 PDF,或者你把 PDF 交给 mistral-ocr 解析器。三个能读 PDF 的模型都把我们那两份扫描件做对了,DeepSeek V4.1 Flash 配 mistral-ocr 也一样。像 cloudflare-ai 这样的文本解析器对扫描件会返回空结果且不报错,因为扫描件没有文本层。
从 1,000 页 PDF 中提取表格要花多少钱?
在我们那六个测试页上,按 2026 年 10 月的价格折算,GPT-6 Luna 大约是每 1,000 页 $0.77,Claude Haiku 5.5 是 $1.00。走 mistral-ocr 的模型还要额外加上 OCR 的每 1,000 页 $2。请查一下当前价格,并从自己的前几次请求里读 usage.cost,因为内容密的表格更贵。
模型会编造 PDF 里没有的行吗?
在我们对五个测试 PDF 的 25 次抽取中没见到编造出来的行,但这并不能保证其他文档上也不会。更大的风险是漏行,原因是输出在 token 上限处被截断,或者解析器什么都没找到。请把行数或某个小计与文档对照一下。
从 PDF 提取表格,最好的 Python 库是哪个?
对于表头简单的数字 PDF,pdfplumber 是免费的,而且在我们的数字测试文件里找到了每一张表。它把每个单元格返回成文本,把多级表头拆成独立的行,而在扫描件里什么都没找到。Camelot 和 Tabula 也是免费选项,但本指南没有测试它们。
下一步
PDF inputs 介绍了用 URL 而不是 base64 发送 PDF、各解析器引擎及其价格,以及文件标注——标注可以让你把解析结果带回去,从而不必为同一份 PDF 付两次解析费用。 Structured outputs 解释了严格 JSON schema,以及如何只路由到支持它们的 provider。 Presets 把模型、system prompt 和 provider 设置存放在同一个名字下。把抽取指令放进 preset 的 system prompt,并让每个服务都调用 /your-name,这样它们都用同一份配置。schema 仍然要每次请求都放在 response_format 里发送,因为 presets 文档并没有把它列进 preset 会保存的设置。我们的 presets 指南 里有完整的搭建步骤。 如果手头积压了一批 PDF,Batch API 会异步执行同样的请求,通常在 24 小时内完成。anthropic/claude-haiku-5.5:batch 和 openai/gpt-6-luna:batch 的标价是标准每 token 价格的一半。Batch 请求接受的是公开 URL 形式的 PDF,而不是 base64,所以得先把文件托管起来。文件 URL 只在列出了文件输入的模型上有效,因此第 3 步里那条 DeepSeek 配 mistral-ocr 的路径在 batch 中不可用;在 OpenAI 模型上,文件 URL 也只能通过 Responses API 使用。本指南没有测量 batch 运行的表现。 如果你在 LangChain 里做这个,ChatOpenRouter 能直接透传 PDF 输入,并支持用 with_structured_output 使用严格 JSON schema。 如果你的源文档是图片而不是 PDF,How to send an image to an LLM 介绍了图片内容部分。