在线AI教程 / AI部署
[Anyscale] How Lila Sciences and Anyscale Scaled GLM-5.3-Flash Training…
主页博客博客详细信息 Lila Sciences 和 Anyscale 如何将 GLM 5.3 Flash 训练扩展到 100 万个代币 作者:SkyRL 团队 和 Lila Sc
主页博客博客详细信息
Lila Sciences 和 Anyscale 如何将 GLM-5.3-Flash 训练扩展到 100 万个代币
作者:SkyRL 团队 和 Lila Sciences 人工智能研究团队 | 2026 年 11 月 5 日
Lila Sciences 和 Anyscale 使用 64 个 B200 GPU 对每个序列 100 万个令牌进行开放模型 GLM-5.3-Flash 的训练。这比我们开始时训练堆栈可以处理的时间长 64 倍,并且每个更改都是 SkyRL 中的开源代码。 Anyscale 的 SkyRL 团队与 Lila Science 研究人员在开源堆栈上的基础设施上密切合作,探索增加此特定模型的上下文长度的研究路径。
科学数据本质上是很长的。基因组、相关蛋白质或 RNA 序列家族,或者持续数天的实验记录,在被切割成几千个标记时,就会失去重要的结构。与自主实验室一起在闭环中运行科学的人工智能也有同样的需求:经过几轮假设、协议和仪器读数,其上下文增长到数十万个令牌。
许多开放模型现在支持 1M-token 上下文,但对于大上下文值下的目标任务,它们可能不具有开箱即用的性能。缩小这一差距意味着对任务本身的数据进行完整的训练,而无需削减或严重压缩上下文。这项工作旨在通过开放模型和开放训练堆栈来实现这一目标。
结果一目了然:
每个序列 1M 个令牌 每个 GPU 适合 144.5 GiB,低于 B200 的 178 GiB。 在 64 个 B200 上,1M 时 13.7k 令牌/秒,256k 时峰值 24.9k 令牌/秒。 该模型使用上下文: 在人类基因组上进行了微调,其损失在令牌上得到了最大程度的改善,在它们之前有数十万个上下文令牌。 开源: 配方位于 SkyRL,并且一些修复正在向上游传送到 Megatron-LM。
Link我们如何在 GLM 5.3 Flash 上达到 1M 代币上下文?
GLM-5.3-Flash是一个混合模型:其45层中有34层使用线性注意力(Kimi Delta Attention),11层使用DeepSeek Sparse Attention(DSA)。它还使用比平常宽 4 倍的残差流和专家混合 (MoE) 层。其中每一个都需要自己的工作。记忆随着每一层中的序列长度而增长,而在注意力中,它随着长度的平方而增长,因此每次优化只会将限制推向极限,直到达到下一个优化为止。我们做了一些优化,所有这些都在原始帖子中通过他们自己的实验和 PR 进行了详细介绍。
!【每一次优化都是承载的】(https://images.ctfassets.net/xjan103pcp94/1QDUX3BpCgXskRSHurQaFd/79f63912a43155992842ebff49660b07/image2.png)
每一次优化都是承重的
我们遇到的大部分问题并不特定于 GLM,并且可以应用于共享相同类型组件的模型:
检查每一层是否运行您认为的内核: GLM 的稀疏注意力层默默地回落到密集注意力,因为融合内核只接受 DeepSeek 的精确张量形状。没有发生任何错误;运行在 16k 时每个 GPU 仅使用 114 GiB,在 32k 时内存不足。填充张量以适应稀疏内核,使内存减半。 稀疏注意力会导致二次成本;它不会删除它。 DSA 每个查询仅处理 2,048 个标记,但选择这些标记意味着根据整个序列对每个查询进行评分。一次计算数百个查询的评分矩阵可使其大小低于 2 GiB,并且将评分分散到多个 GPU,而不是在每个 GPU 上重复评分,使得整个训练步骤在 256k 速度下速度提高了 2.1 倍。 每次内存修复都会消耗吞吐量,因此仅使用所需的长度。 完全重新计算、CPU 卸载和上下文并行性都会购买更多上下文以获得一定的速度。例如,卸载可将 256k 的峰值内存从 142 GiB 削减至 98 GiB,但步骤时间增加 21%。我们只在训练时不使用它时才打开它们。 随机令牌的基准低估了 MoE 模型的内存。 专家之间的真实文本分布路线不均匀:在真实的长上下文数据集上,最繁忙的 GPU 收到的令牌数量约为平均数量的 4 倍,并且 512k 耗尽了内存,而随机令牌运行很容易适应。对序列上的 MoE 层进行分块处理修复了这个问题。在调整集群大小之前测试实际数据的内存。 规划主机内存,而不仅仅是 GPU 内存。 在 1M 令牌下,在上下文并行之前,卸载到 CPU 的层输入约为每个 GPU 180 GB,每个 8-GPU 节点超过 1 TB,并且它们与优化器状态共享主机 RAM。使用固定内存进行副本(它们比可分页内存快 22%)并在每一步释放它。 将正确性与速度分开验证。 速度和内存数字可以来自随机权重,但正确性不能。在使用实际权重的 RL 运行中,训练器的对数概率将 vLLM 与 128k 到 1M 令牌的匹配范围在 0.04 - 0.07(平均绝对差)内,并且过拟合测试在 20 个步骤中将损失从 1.65 驱动到 0.17。
通过结合这些想法,我们能够在不同的上下文长度上保持良好的吞吐量
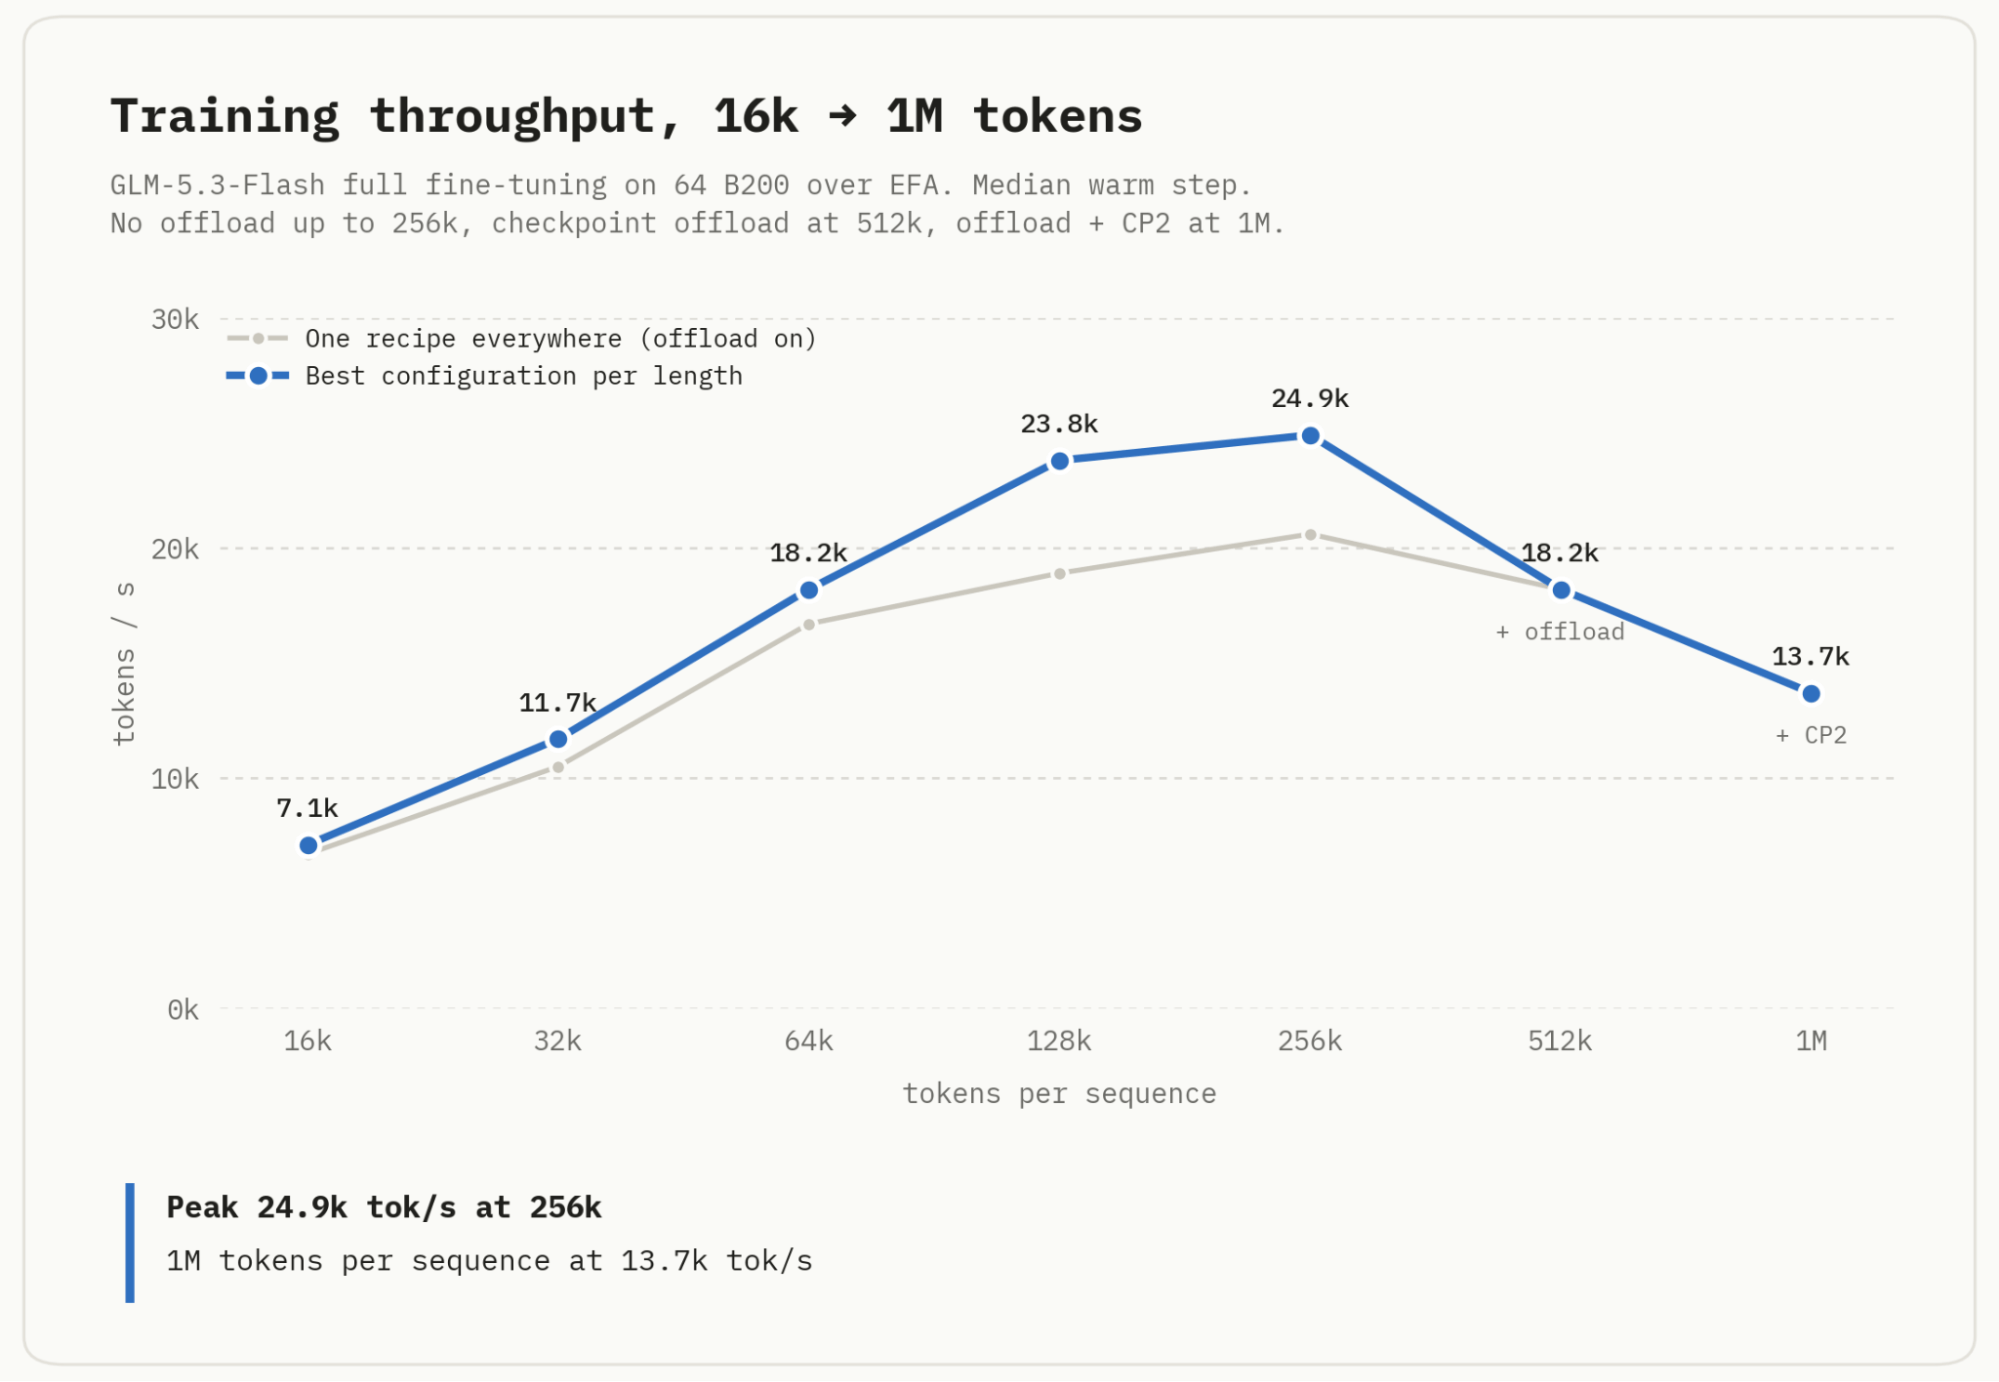
训练吞吐量,16k -> 1M 代币
LinkTraining 结果
我们以每个序列 512k 个标记对人类基因组进行后训练,模型的保留损失在 80 个步骤中下降了 4.8%,并且在其之前上下文最多的标记上增益最大。最后一部分是它学会使用长上下文而不仅仅是局部模式的证据。
我们对人类参考基因组 (hg38) 的 1 号和 2 号染色体进行了训练,并对模型从未见过的 22 号染色体进行了评估。 DNA 是一种很好的测试,因为它具有各种尺度的结构,从短的图案到跨越很长一段距离的图案。
为了将远程学习与本地学习分开,我们将保留的损失按令牌位置划分在 32k 个令牌桶中,并在微调之前和之后进行比较:
早期的标记在它们之前几乎没有背景,因此任何改进都来自局部模式,例如短主题和基本组成。 迟到的标记 在它们之前最多有 500k 个上下文标记。 本地学习对每个职位都有同等的帮助,因此后期职位的更大进步必须来自只有他们拥有的长期背景。
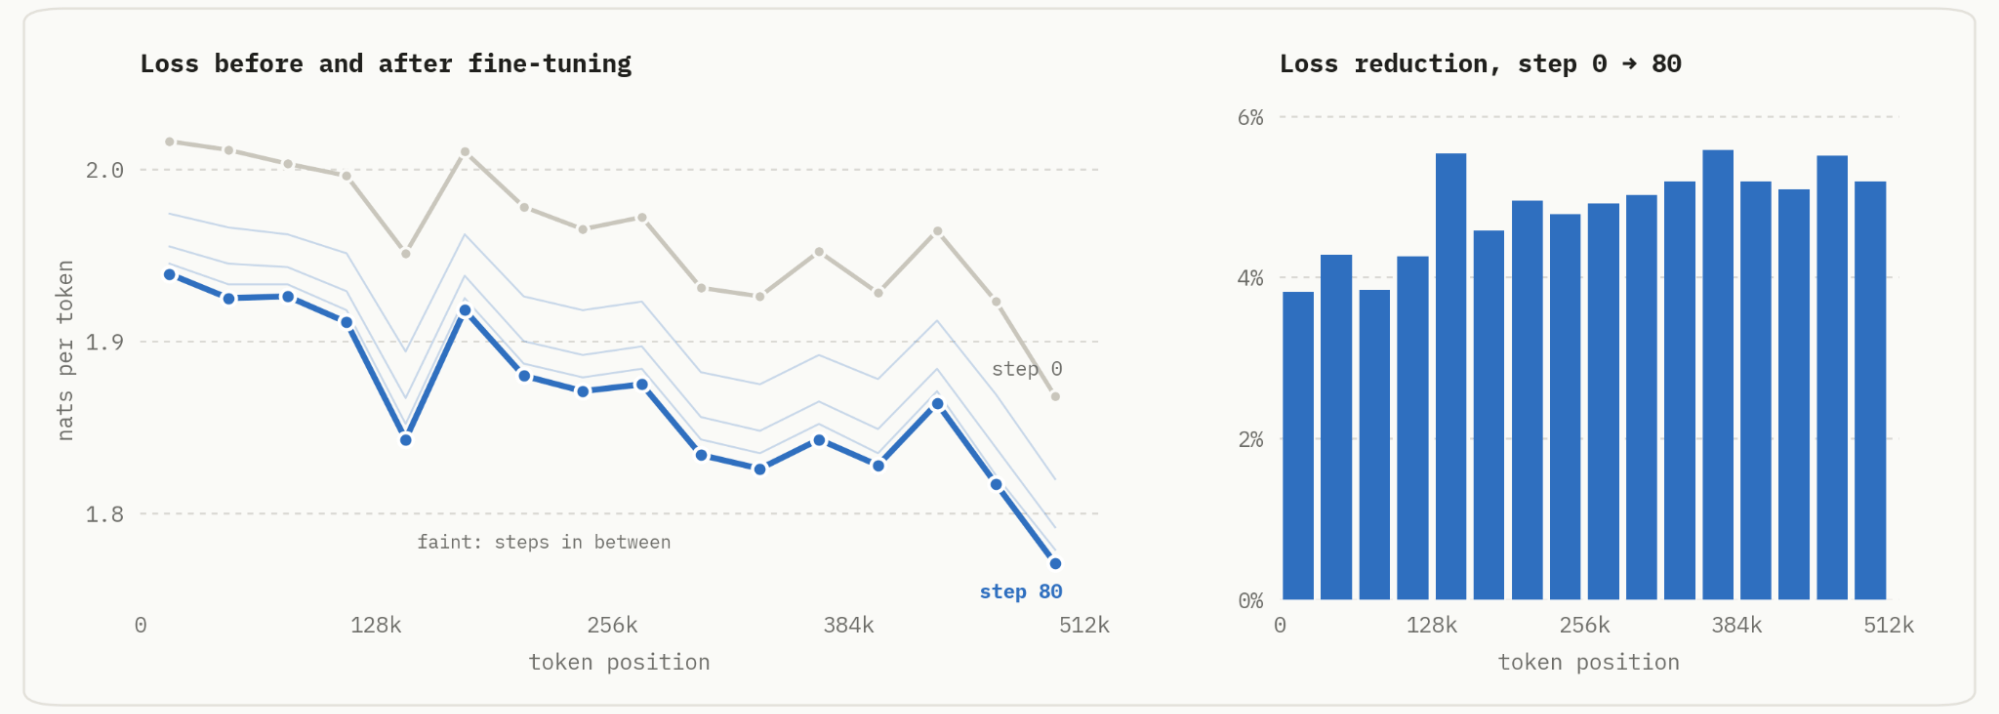
微调前后的损失
Link在任何规模上运行
本文中的每个实验都在由 Anyscale 平台管理的 Ray 上运行,位于 Lila 云中的 64-GPU B200 集群上。 SkyRL 使用 Ray 来放置和协调其训练和推理工作人员,因此相同的设置对随机令牌运行内存基准测试,对真实数据进行微调,并根据 vLLM 检查训练器的 RL 运行。
要更深入地了解用于支持长上下文的具体技术,请参阅此详细博客文章。
目录
我们如何在 GLM 5.3 Flash 上达到 1M 代币上下文? 训练结果 在 Anyscale 上运行
####分享
####标签
注册产品更新
####推荐内容

生产中的 KubeRay:现场最佳实践
宣布 Ray 在 Google TPU 上支持 PyTorch
使用 KubeRay 在 Kubernetes 上大规模运行 Ray
立即探索 Anyscale
使用专为生产 AI 构建的多云平台,在 Ray 上构建、运行和扩展任何 AI 工作负载。
免费开始与专家交谈