在线AI教程 / AI部署
[Amazon Bedrock] 使用 CDK 在托管 Amazon Bedrock 知识库上构建代理检索
人工智能 使用 CDK 在托管 Amazon Bedrock 知识库上构建代理检索 本文使用 AWS 云开发套件 AWS CDK 在托管 Amazon Bedrock 知识库上构建
人工智能
使用 CDK 在托管 Amazon Bedrock 知识库上构建代理检索
本文使用 AWS 云开发套件 (AWS CDK) 在托管 Amazon Bedrock 知识库上构建企业代理检索。要了解为什么值得构建它,可以从普通检索增强生成 (RAG) 崩溃的地方开始。大多数 RAG 系统都以相同的方式开始:它们嵌入问题,从一个索引中获取最近的块,将它们交给模型,然后返回答案。一次检索,一代。对于一大类问题来说,这是正确的设计,没有理由构建更复杂的东西。
它以一种可识别的方式失败了。提出一个问题,其答案跨越两个语料库,一次检索返回模型所需内容的一半,这比什么都不返回更糟糕,因为返回的答案是流畅且不完整的。提出一个问题,其中正确的来源取决于问题,并且单个索引没有可供选择的机制。在看到第一个结果后提出一个需要再次查看语料库的问题,而没有地方可以进行第二次查看。
企业代理检索通过在循环中放置推理代理来回答所有三个问题。代理在形成答案之前决定是否检索、查阅哪个知识库以及是否返回更多信息。这是 Amazon Bedrock 知识库 的发展方向。随着托管知识库的推出,检索不再是单一的嵌入和获取调用。它已成为一种代理能力:多轮规划、工具驱动的检索以及有根据的引用答案。 AgenticRetrieveStream API 将此作为一流的服务功能提供,而不是您自己组装的东西。这是可行的,但它也带来了一个真正更困难的操作问题。单次管道是一个可以通过阅读来推理的函数。循环推理和检索的智能体对每个问题都采取不同的路径。默认情况下,您既看不到它所采取的路径,也看不到它产生的答案是否良好。可观察性不再是可有可无的东西,而是成为了解系统运行情况的唯一方法。
2024 年 8 月,使用 Amazon Bedrock 和 AWS CDK 知识库构建端到端 RAG 解决方案 将单次设计部署为 CDK 应用程序:Amazon Simple Storage Service (Amazon) S3) 语料库,一个 Amazon OpenSearch Serverless 集合和索引、知识库和数据源,配置为 CDK 堆栈,其顺序由您手动排序。自发布以来,三件事发生了变化。
Amazon Bedrock 现在提供托管知识库(类型:MANAGED),它拥有摄取、存储、索引和检索本身。您不再需要使用 OpenSearch 计算单元 (OCU) 创建、扩展或支付提供配置的 OpenSearch 无服务器集合和索引。 Amazon Bedrock AgentCore 提供了代理的一半,一个将每个知识库公开为模型上下文协议 (MCP) 工具的网关、一个托管推理代理的运行时以及 AgenticRetrieveStream,后者在内部重新排序并返回综合的引用答案。代理检索仅在托管知识库上可用。 可观察性和评估故事现在是您可以提供的东西,而不是您附加的东西。该解决方案在同一部署中提供了两个 Amazon CloudWatch 仪表板,涵盖七层遥测,以及两种形式的评估(按需评估和连续评估)。
本文构建了该系统:一个跨两个知识库进行路由、通过网关进行检索并返回一个有根据的引用答案的代理,其每一层行为都经过检测,作为 Python 中的单个 AWS CDK 应用程序。一个命令即可部署所有内容,CDK 派生命令。
如果您阅读 2024 帖子,从 Amazon S3 存储桶到知识库的路径会看起来很熟悉,并且之后的一切都是新的:矢量存储消失了,检索是代理的,应用程序提供的内容大约有一半是为告诉你代理做了什么。如果你没有,这篇文章是独立的。
起作用的服务以及一个问题通过它们的路径:代理决定是否检索以及查阅哪个知识库,网关将每个知识库公开为它可以调用的工具,托管知识库搜索和引用,并且循环根据问题需要重复多次。代理在此过程中执行的所有操作都会落在 Amazon CloudWatch 中。
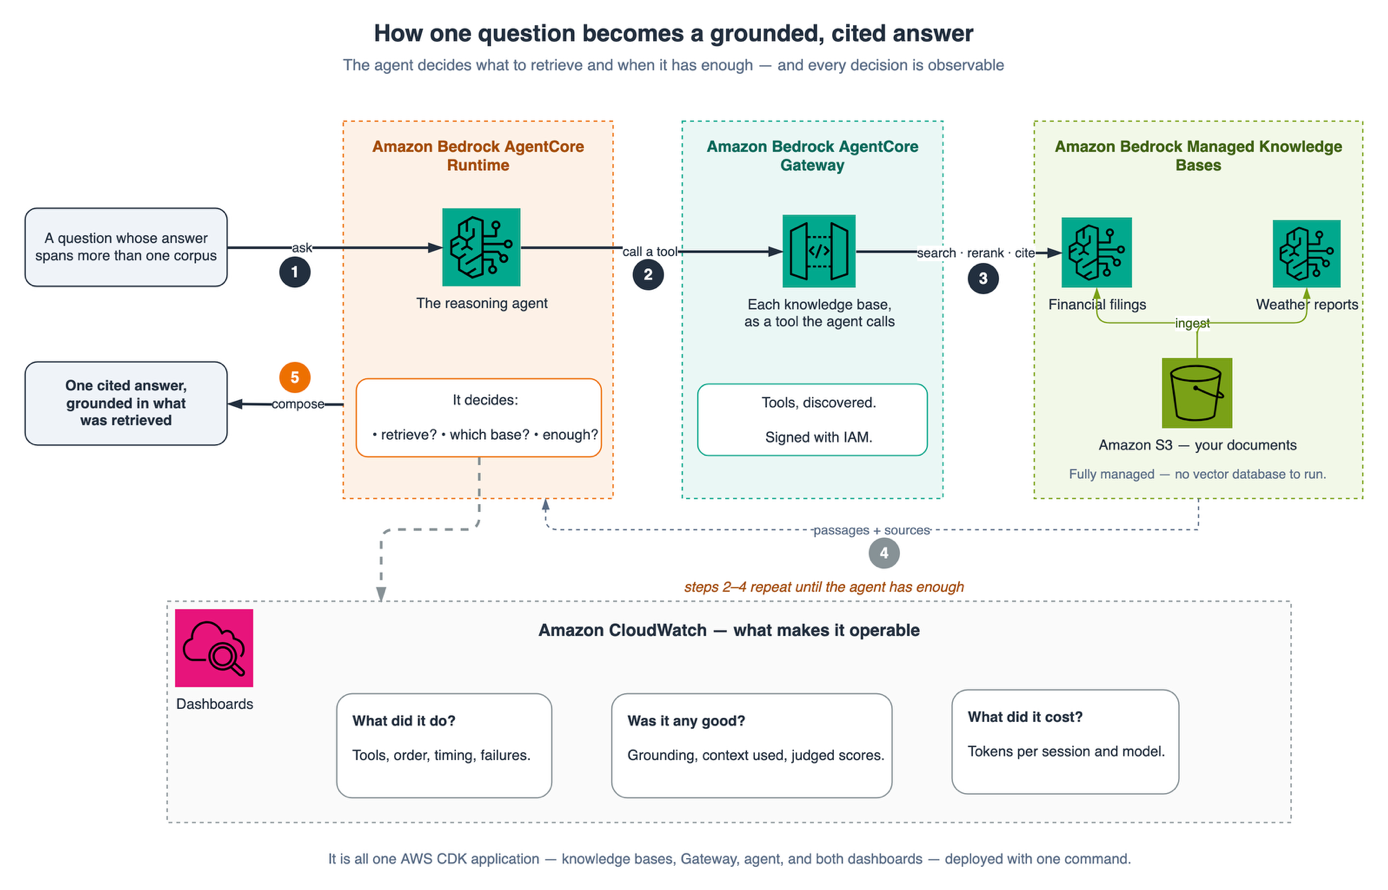
图 1:所涉及的服务以及单个问题通过这些服务所采取的路径
背景
在演练之前,它有助于确定三件事:是什么使检索具有代理性,为什么托管知识库是其正确的基础,以及为什么可观察性和评估属于设计而不是稍后附加。
从 RAG 到企业代理检索
经典检索增强生成 (RAG) 执行一次检索和一代。 企业代理检索在循环中放置一个推理代理:它决定“是否”和“检索什么”,可以检索多次进行细化,选择“哪个”知识库相关(语义路由),然后才通过引用组成一个有依据的答案。借助托管知识库,这是一流的服务功能,AgenticRetrieveStream API 执行多轮规划、执行检索并返回引用的答案,而不是通过原始矢量搜索构建和维护的编排层。这对于复杂问题产生了更好的答案,但它也产生了一个更复杂的运行系统,这正是从一开始就内置可观察性和评估的原因。
与 DIY 知识库相比,管理型知识库
Amazon Bedrock 现在提供托管知识库(类型:托管):Amazon Bedrock 为您管理摄取、存储、索引和检索,包括默认情况下使用服务托管模型的嵌入和重新排名,因此无需配置、扩展或修补。这与 客户管理 (DIY) 知识库不同,在知识库中,您自己选择和操作矢量存储(例如 Amazon OpenSearch Serverless)。
该解决方案有两个最重要的区别:
能力Amazon Bedrock托管客户管理(DIY) 代理检索(AgenticRetrieveStream)✅ 支持❌ 不支持 AgentCore 网关集成✅ 支持❌ 不支持 数据存储自动扩展,由 Amazon Bedrock 完全管理您配置、扩展和维护它 嵌入+重新排名内置托管模型,无需额外费用您配置它们 管理基础设施无矢量数据库 + 更多
由于代理检索和 AgentCore Gateway 连接器仅在托管知识库上可用,因此它是企业代理检索的自然基础。这还意味着 Amazon Bedrock 会为您管理存储和索引,因此在此设计中无需配置 OpenSearch Serverless 集合或 OCU 容量。当您想要选择和操作自己的矢量存储时(例如,重用现有的 OpenSearch Serverless 集合或满足特定的数据驻留、调整或合规性要求),客户管理的选项仍然是正确的选择。对于企业代理检索,托管知识库使该功能成为可能。
为什么可观察性和评估
“返回答案”的代理系统不足以用于生产。您需要了解它的行为方式(延迟、呼叫量、令牌使用情况)、检索和答案的效果如何,并且您持续需要这些信号。该解决方案提供两个跨越七层遥测的 CloudWatch 仪表板,以及两种形式的评估(按需和连续),所有这些都由同一 CDK 应用程序配置。基础、引用和评估层也支持负责任的使用。引用的答案可追溯到其来源段落,因此回复可审核,并且忠实性和正确性分数可让您捕获偏离来源的答案,而不是在生产中找出答案。
为什么 CDK 用于这个特定的解决方案
任何基础设施即代码工具都可以创建这些资源。 CDK 在这里赢得一席之地是因为该架构特有的原因:四个堆栈密集地交叉引用。网关需要两个知识库 ID。代理需要网关的 URL 和 ARN。仪表板需要知识库 ID、网关 ARN、和代理运行时 ID、跨越堆栈边界的七个值,每个值都是指标上的维度或连接器上的目标。
以原始模板编写,这是一组手动保持一致的堆栈导出和跨堆栈查找,加上一个以正确顺序部署并向前线程输出的脚本,并且两者都会在重命名任何内容时发生漂移。在 CDK 中,您传递构造,并且导出和依赖边缘源自传递它的这一行为。 2024 年的解决方案具有三个堆栈和一个主要是线性的依赖链。在四个堆栈中交叉有七个值时,差异就不再是风格上的了。
解决方案概述
这是单个问题通过系统端到端的路径。值得慢慢看,因为帖子的其余部分是从左到右浏览的。
下图描绘了端到端代理检索工作流程。用户的问题进入 AgentCore 运行时上的代理,该代理通过 AgentCore 网关将其路由到两个 AgenticRetrieveStream 工具之一,每个托管知识库、财务和天气工具各一个,每个工具均从 Amazon S3 提取。所选工具会返回一个有根据的、被引用的答案,并且每个步骤都会传输到 Amazon CloudWatch 和 AWS X-Ray。编号的徽章映射到以下演练。
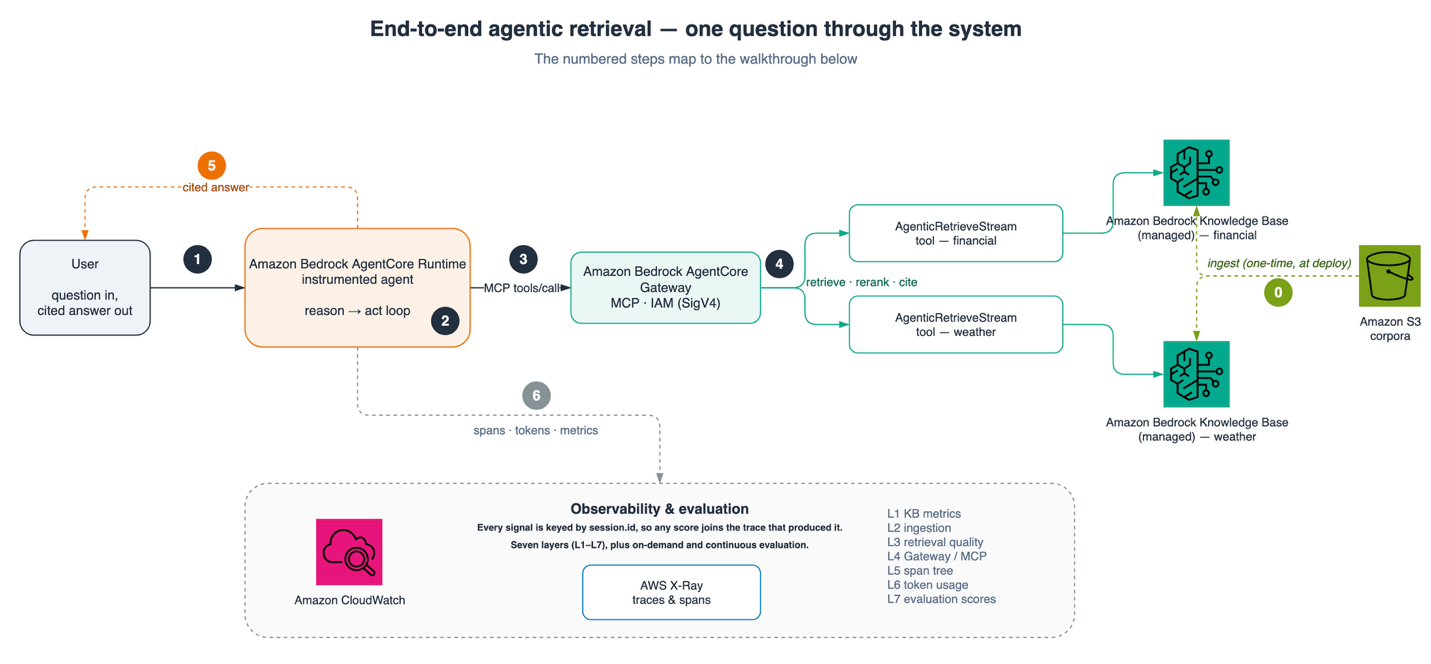
图 2:单个问题的端到端代理检索工作流程
图中的编号步骤映射到工作流程,如下所示。
第 0 步 — 部署时一次性。 在提出任何问题之前,Amazon S3 中的每个语料库都会被提取到自己的托管知识库中:Amazon Bedrock 会自动对其进行解析、分块、嵌入和索引。这种情况在堆栈部署时发生一次,它不是每个问题路径的一部分,因此它被绘制为虚线箭头并标记为步骤 0。然后每个问题都遵循步骤 1-6:
用户向托管在 Amazon Bedrock AgentCore 运行时上的代理发送问题。运行时使用 OpenTelemetry (OTEL) 跨度自动检测整个原因与行动循环,因此系统从第一次调用就可以观察到。 代理的推理模型跨知识库进行规划和路由。因为每个知识库都作为自己的检索工具公开,所以代理会选择主题与问题(金融或天气)匹配的工具,而不是搜索一个混合索引。 选定的工具调用由 AgentCore Gateway 通过 MCP 进行代理,由代理的 IAM 任务角色授权并使用 SigV4 进行签名,从而调用托管知识库上的知识库的 AgenticRetrieveStream API。 AgenticRetrieveStream 执行知识库内的工作:它将问题分解为子查询,从 Amazon Bedrock 管理的数据存储中迭代检索(从 Amazon S3 中的语料库提取),并合成通过网关流回的有根据的引用答案。 代理检查返回的上下文是否足够。如果不足够,它会再次循环、路由和检索,然后再撰写最终答案。如果是,它会将引用的答案返回给用户。 自始至终,运行时都会向 Amazon CloudWatch 和 AWS X-Ray 发出跨度、令牌计数和指标,填充七个可观测层并提供按需和连续评估分数。
在内部,该工作流程是一个 CDK 应用程序“app.py”,它声明了四个堆栈。您不选择顺序,CDK 从您传递的构造引用中派生出它:
kb_stack = KnowledgeBasesStack(app, f"{project}-kb", env=env)
gateway_stack = AgenticGatewayStack( app, f"{project}-gateway", env=env, financial_kb=kb_stack.financial_kb, # ← the reference creates the dependency weather_kb=kb_stack.weather_kb, )
agent_stack = AgentRuntimeStack( app, f"{project}-agent", env=env, gateway=gateway_stack.gateway, )
DashboardsStack( app, f"{project}-dashboards", env=env, financial_kb=kb_stack.financial_kb, weather_kb=kb_stack.weather_kb, gateway=gateway_stack.gateway, agent_runtime=agent_stack.agent_runtime, )
这就是整个接线。这四个构造函数调用取代了导出/导入簿记和部署脚本。
#堆栈它创造了什么注意 1-kbS3 存储桶,语料库上传,两种类型:托管 KB、数据源、IAM、摄取KB 达到 ACTIVE,语料库被摄取 2-网关网关 (AWS_IAM / MCP)、每 KB AgenticRetrieveStream 目标无需 Cognito 3-代理ECR、CodeBuild、运行时检测 Strands 代理、出售日志/跟踪、在线评估~8–10 分钟(图像构建) 4-仪表板代理可观察性 + kb 可观察性仪表板空,直到你推动交通
代理运行一个推理与行动循环:它思考(大型语言模型 (LLM) 调用),决定调用哪个知识库工具,读取通过网关返回的内容,并经常在撰写最终引用的答案之前再次检索。每个步骤都由运行时自动检测,因此七个可观察层由真实流量填充。
七层。 L1 KB 原生指标、L2 摄取、L3 代理检索质量、L4 网关/MCP 指标、L5 OTEL 生成树、L6 令牌使用和 L7 评估分数。第 1、4 和 5 层会自动发射。第 3、6 和 7 层由驱动程序笔记本作为自定义指标发布。
所有可调整的内容都位于一个文件“config.py”中:
设置含义默认 EnvSettings.PROJECT_NAME每个堆栈和资源的名称前缀bmkb-obs-cdk EnvSettings.ACCOUNT_REGION要部署到的 AWS 区域us-west-2(或您的个人资料) KbConfig.EMBEDDING_MODEL_TYPE“托管”(捆绑)或“自定义”(自带 ARN)管理 AgentConfig.MODEL_ID代理的推理模型,第 6 层花费Claude Haiku 4.5 EvalConfig.SAMPLING_PERCENTAGE在线评估采样率,参见免责声明100100
更改“PROJECT_NAME”将为您提供整个解决方案的独立命名副本,因此两个部署可以在一个帐户中共存。驱动程序笔记本读取相同的常量,因此它会自动遵循重命名,无需手动保持同步的堆栈名称。
描述数据集
该解决方案附带两个小型语料库,捆绑在 data/ 下的存储库中:
Financial — 合成的 Octank Financial 10-K(octank_financial_10K.pdf,~198 KB)。 天气 — 真实、公开的美国国会研究服务部关于龙卷风的报告(IF12695,tornadoes_report.pdf,~560 KB)。
⚠️ 关于数据: 金融语料库是合成的。 Octank 是一家虚构的公司,10-K 是模型生成的样本数据(CC0 许可)。这不是真实的财务数据。天气语料库是真实的、公共领域的美国政府作品,也是国会研究服务报告,可在 sgp.fas.org/crs/misc/IF12695.pdf 上公开获取(美国政府的作品不受版权保护)。要使用您自己的数据,请将文件放在 data/ 下并调整“config.py”中的前缀,无需其他更改。
这两个语料库有意不同,因此代理必须将每个问题路由到正确的知识库,即语义路由故事。由于这些是托管知识库,因此我们不会配置分块、嵌入或索引:在摄取时,Amazon Bedrock 会解析每个 PDF、对其进行分块、将其嵌入其托管模型并自动为其建立索引。
我们使用两个独立的知识库,每个知识库都通过网关作为自己的检索工具公开,而不是一个包含两个语料库的知识库,这一选择是经过深思熟虑的。为代理提供两个命名工具,使得路由成为可以观察到的明确推理行为:跨度树显示它为给定问题选择的“哪个”工具,并且第 3 层中的检索质量指标在每个知识库中保持可分离,因此财务和天气精度永远不会模糊为单个数字。跨越两个语料库的单一工具将打破这种区别,路由决策将移至一个索引的排名内部,从视野中消失,并且每个质量信号将是两个不相关领域的平均值。将语料库与其工具分开可以使代理的行为清晰可见,这也是练习的重点。
在CDK中,将语料库放入S3是一个BucketDeployment:
s3deploy.BucketDeployment( self, "FinancialCorpus", sources=[s3deploy.Source.asset(str(ROOT / "data" / "financial"))], destination_bucket=self.source_bucket, destination_key_prefix=KbConfig.FINANCIAL_PREFIX, )
BucketDeployment 值得了解,因为替代方案非常诱人:如果没有它,触发摄取的自定义资源往往会增加上传步骤,而现在一个资源拥有两个不相关的作业。在这里它只需要摄取。
托管摄取自动扫描、分块、嵌入和索引每个文档:每个知识库索引一个文档,零失败。
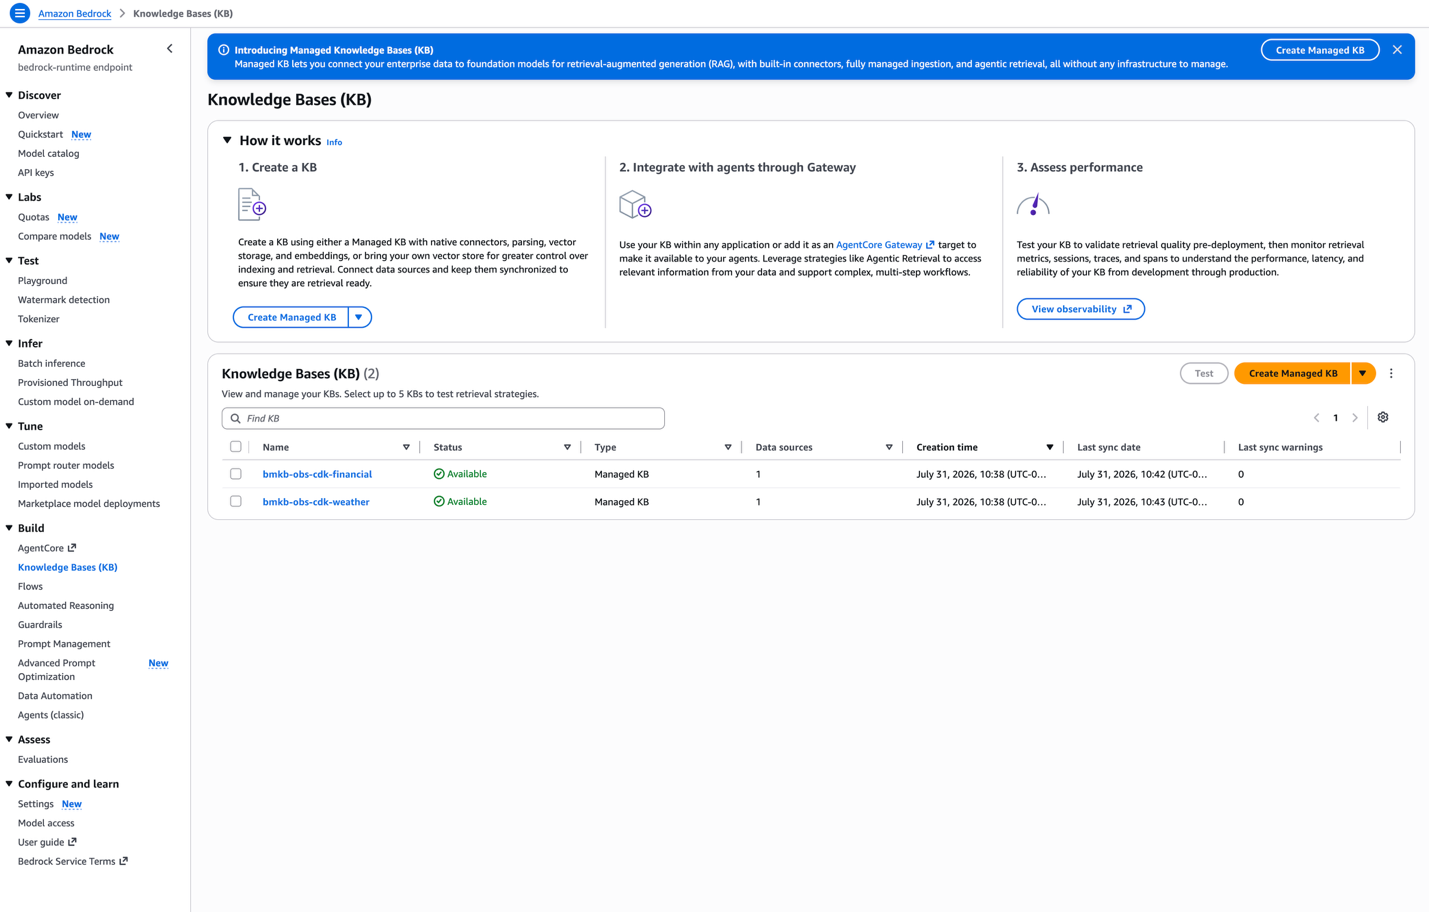
图 3:托管摄取结果,每个知识库索引一份文档,零失败
部署解决方案
本节将逐步介绍如何使用一个命令部署整个解决方案。满足先决条件后,“cdk deploy --all”按照 CDK 派生的依赖顺序配置所有四个堆栈,并自动线程化每个跨堆栈值。
先决条件
具有 Amazon Bedrock、AgentCore(运行时 + 网关)、AWS Identity and Access Management (IAM)、CloudWatch、AWS X-Ray、Amazon Elastic Container Registry (Amazon ECR)、AWS 权限的 AWS 账户CodeBuild、Amazon S3、AWS Lambda 和 AWS CloudFormation。 账户中可用的代理模型(默认 us.anthropic.claude-haiku-4-5-20251001-v1:0)。 启用了 CloudWatch Transaction Search,因此 OTEL 跨越了 aws/spans 中的第 5-7 层。 Node.js 18+ 和 CDK CLI (npm install -g aws-cdk),以及 Python 3.13+。 为 CDK (cdk bootstrap) 引导的帐户和区域,每个帐户/区域一次。 没有本地 Docker,代理映像由 CodeBuild (ARM64) 构建。
一个命令
要部署解决方案,请克隆存储库、创建虚拟环境、安装依赖项,然后运行“cdk deploy --all”。从终端运行以下命令:
git clone cd rag/managed-knowledge-bases/07-IaaC/managed-kb-observability-cdk/ python3 -m venv .venv && source .venv/bin/activate pip install -r requirements.txt cdk bootstrap # once per account/region cdk deploy --all
前两个命令克隆示例并移动到项目目录中。接下来的两个创建并激活 Python 虚拟环境并安装 CDK 应用程序的依赖项。 cdk bootstrap 为 CDK 准备帐户和区域(每个帐户/区域只需要一次),并且 cdk deploy --all 提供所有四个堆栈。
账户和区域来自您的 AWS 配置文件 (CDK_DEFAULT_ACCOUNT / CDK_DEFAULT_REGION),因此应用程序无需任何编辑即可部署。
区域可用性:托管知识库、代理检索 (AgenticRetrieveStream) 和 Amazon Bedrock AgentCore(运行时和网关)并非在每个 AWS 区域都可用。在部署之前,请确认您的目标区域中提供了所有这些,并相应地在“config.py”中设置“ACCOUNT_REGION”。默认值为 us-west-2。有关当前可用性的信息,请参阅 Amazon Bedrock 和 Amazon Bedrock AgentCore 文档以及 AWS 区域服务列表。
此版本中没有部署脚本,这就是要点:“cdk deploy --all”遍历从“app.py”派生的依赖关系图,按顺序部署四个堆栈,并自动传递每个跨堆栈值。终端在完成时报告每个堆栈,bmkb-obs-cdk-kb [1/4](默认的 PROJECT_NAME),然后是网关 [2/4],然后是代理 [3/4],然后是仪表板 [4/4],并且该顺序是派生的,而不是声明的:它不属于堆栈之间的构造引用,因此添加使用现有输出的第五个堆栈会自行重新排序部署。
Stack -agent 使用 CodeBuild 构建代理容器,因此该阶段大约需要 8-10 分钟。其他三人也很快。每个堆栈在完成时都会打印其输出,您可以在其中获取知识库 ID、网关 URL、运行时 ARN 和两个仪表板 URL。部署完成后,所有四个堆栈都已完成。以下屏幕截图显示了成功执行“cdk deploy --all”后的 AWS CloudFormation 控制台。
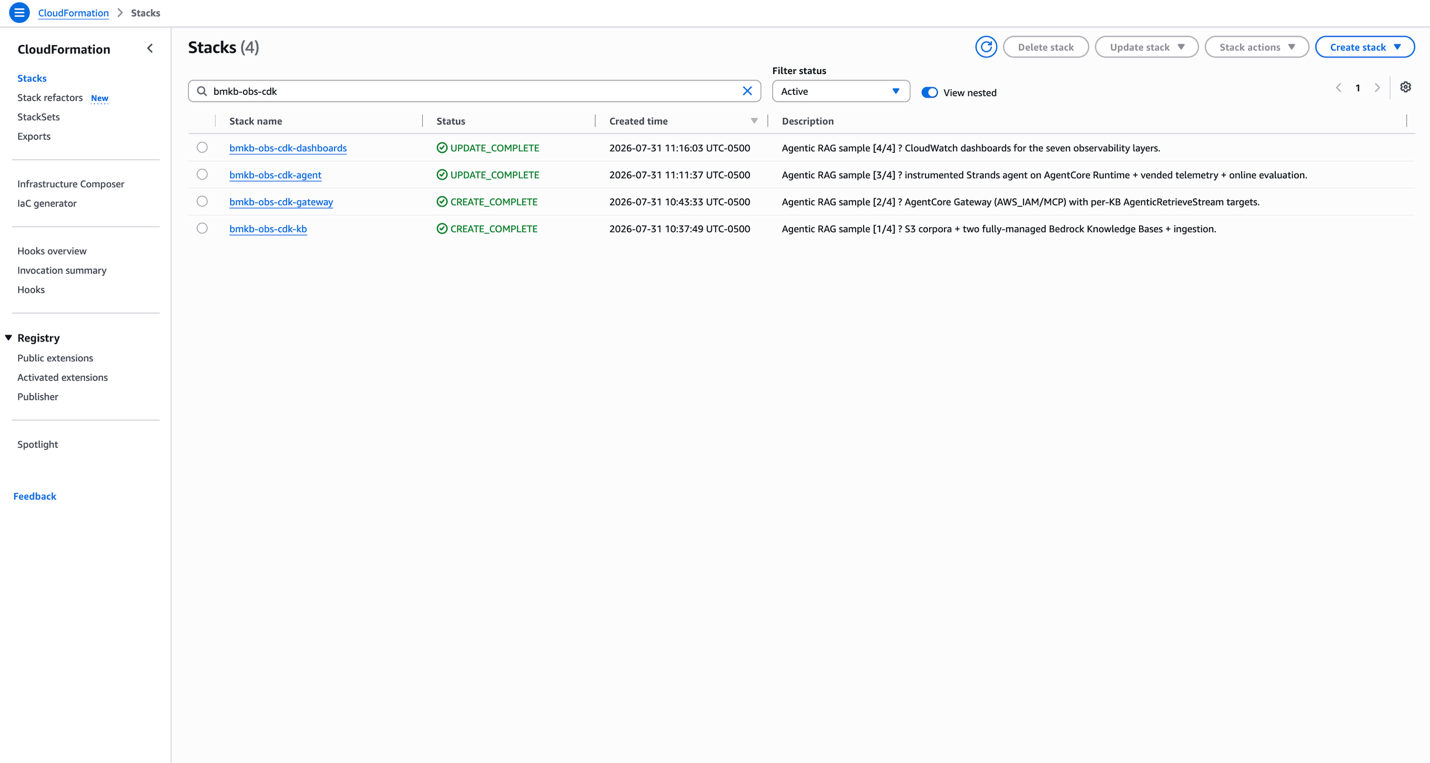
图 4:成功部署后的 AWS CloudFormation 控制台,所有四个堆栈均为 CREATE_COMPLETE
在控制台上,所有四个堆栈(kb、网关、代理和仪表板)都会报告 CREATE_COMPLETE,每个堆栈在其描述中显示的派生依赖关系顺序中都有其 [n/4] 位置。
关于长期运行资源的说明
此解决方案中的两件事花费的时间远远超过 AWS Lambda 函数允许进行简单轮询的 15 分钟上限:KB 摄取同步和 CodeBuild 映像构建。 AWS CDK 提供程序框架通过“on_event”/“is_complete”拆分来处理此问题,其中一个处理程序开始工作,第二个处理程序接受轮询,直至报告完成。
cr.Provider( self, "IngestSyncProvider", on_event_handler=on_event, # StartIngestionJob, return the job id is_complete_handler=is_complete, # GetIngestionJob, report IsComplete query_interval=Duration.seconds(30), total_timeout=Duration.minutes(30), )
没有任何阻碍,返回到 CloudFormation 的响应协议由框架拥有,而不是手写到每个处理程序中,并且 30 分钟的预算是一个属性,而不是需要围绕它进行设计的东西。
启动并测试
打开notebooks/01-drive-and-observe.ipynb并从上到下运行它(首先pip install -r requests-notebook.txt)。它读取堆栈输出,然后向部署的代理发送特定于主题的提示,每 KB 一个会话,因此您可以在一个位置查看答案和语义路由:财务问题由 Octank 10-K 回答,天气问题由龙卷风报告回答,每个问题都会自动路由到匹配的 AgenticRetrieveStream 工具。
笔记本从堆栈输出中发现所有内容,因此无需手动粘贴任何内容:
Stack names are derived from the same PROJECT_NAME the CDK app uses, so renaming the
project in config.py cannot leave this notebook pointing at stale stacks.
from config import EnvSettings
PROJECT = EnvSettings.PROJECT_NAME STACKS = {suffix: f'{PROJECT}-{suffix}' for suffix in ('kb', 'gateway', 'agent', 'dashboards')}
def outputs(stack_name): s = cfn.describe_stacks(StackName=stack_name)['Stacks'][0] return {o['OutputKey']: o['OutputValue'] for o in s.get('Outputs', [])}
笔记本导入与应用程序相同的“config.py”,因此两者永远不会对堆栈的名称产生分歧。
驱动程序通过部署的代理发送每 KB 提示。财务问题转到财务知识库,天气问题转到天气知识库,每个问题都有一个有根据的引用答案。
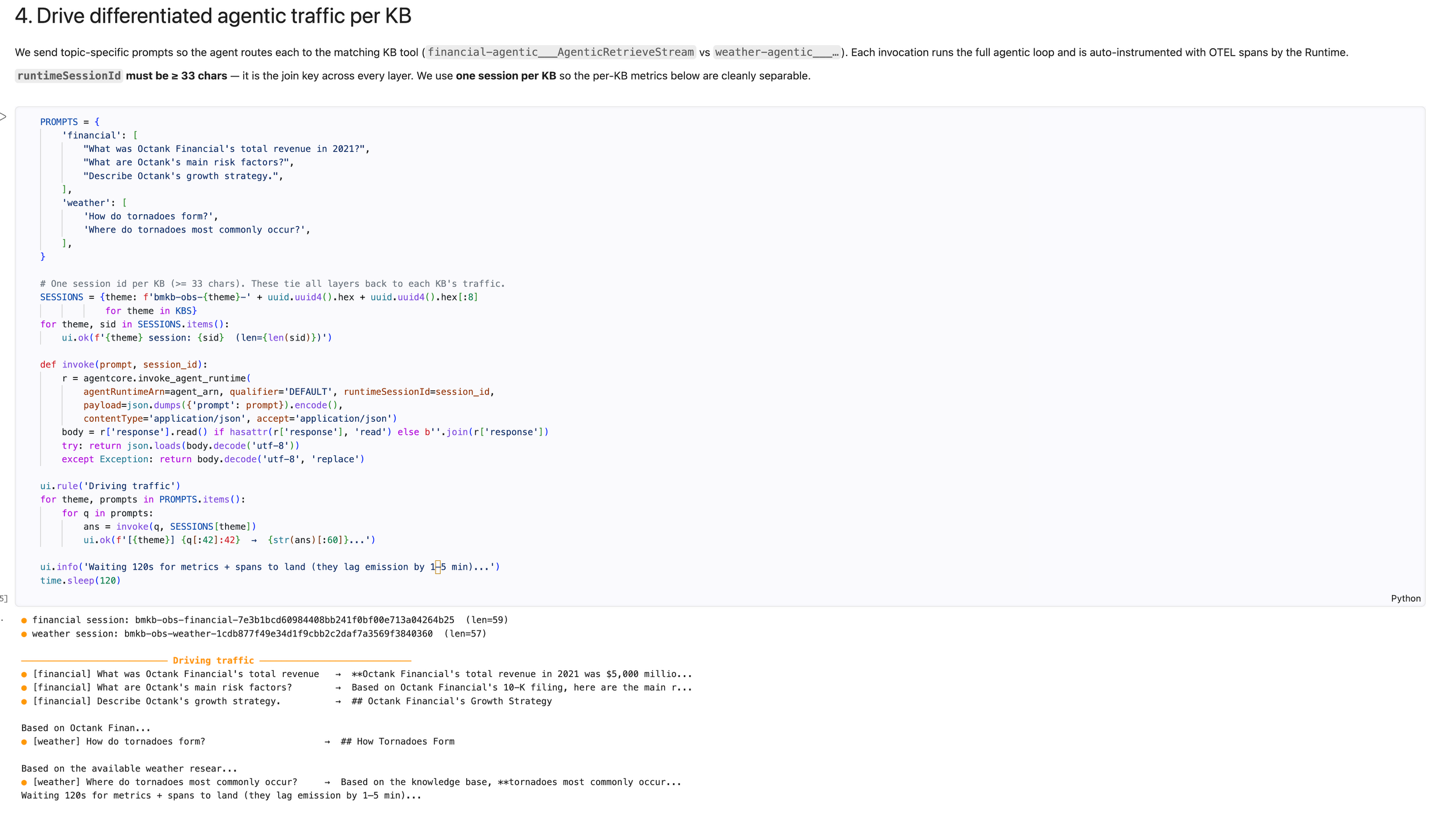
图 5:按知识库提示路由到匹配的知识库,每个提示都返回一个有根据的引用答案
该笔记本还根据代理实际检索和引用的内容计算无参考的第 3 层检索质量信号,无需地面事实,无需额外判断,并将其发布到 CloudWatch。
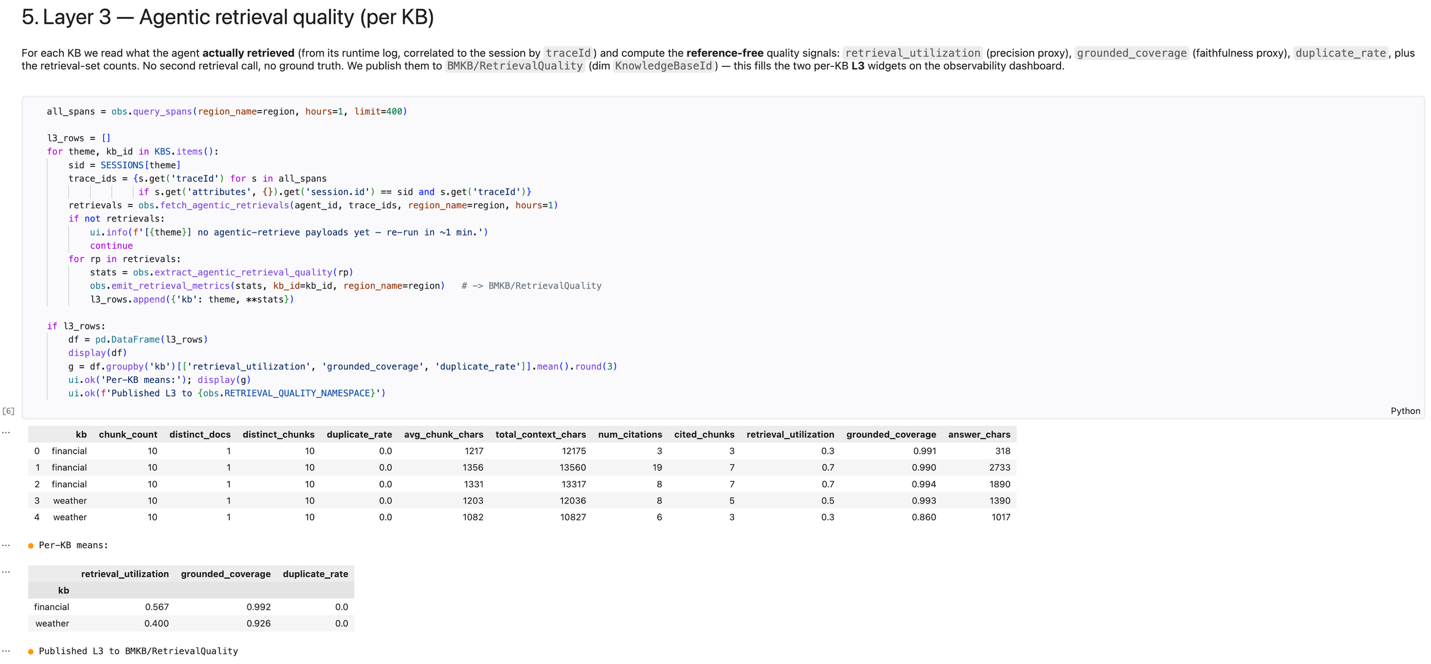
图 6:每个知识库的无参考第 3 层检索质量信号
观察:七层仪表板
两个仪表板是七个层可见的地方。该堆栈创建两个仪表板,并推动流量填充它们。以下屏幕截图显示了 CloudWatch 控制台中显示的两个仪表板。
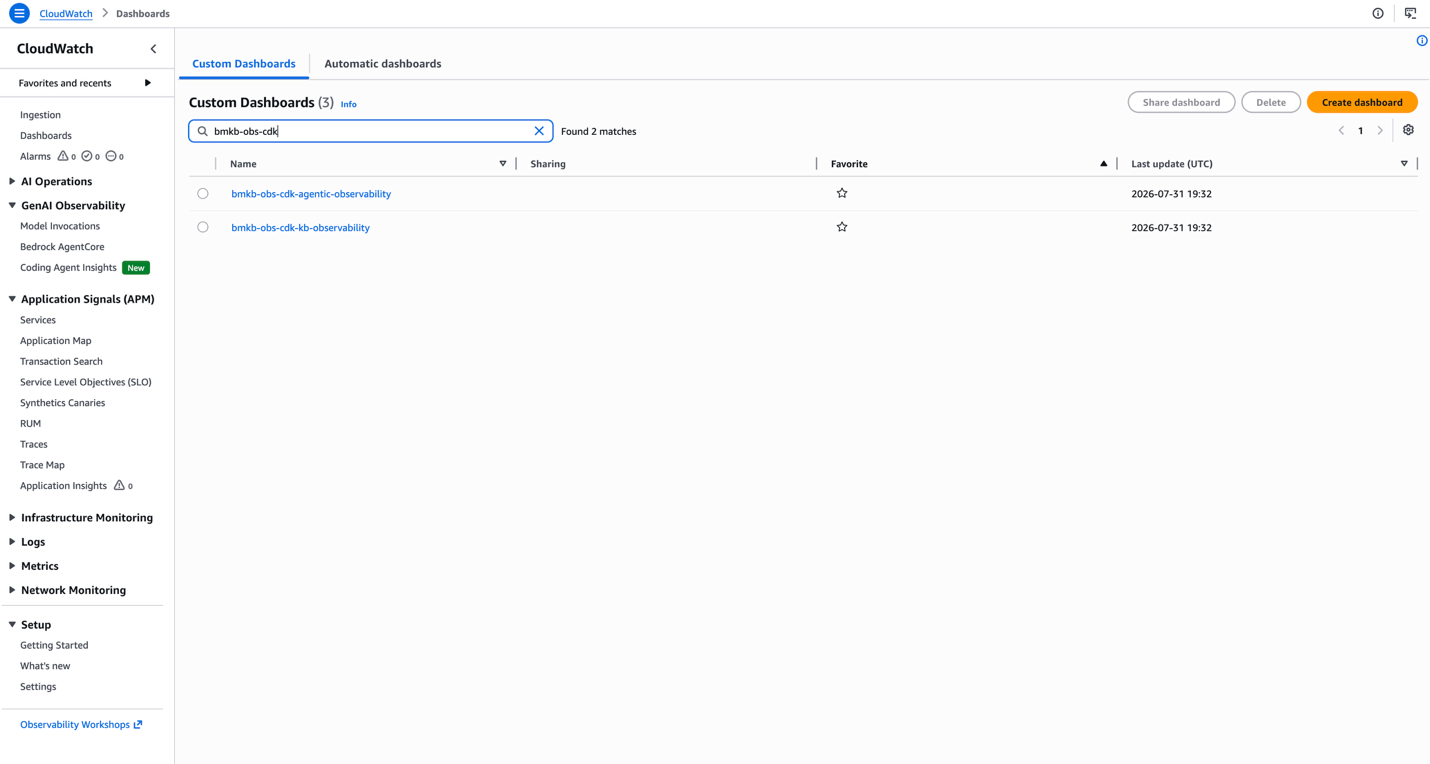
图 7:CloudWatch 控制台中的两个仪表板:端到端代理可观察性和每 KB 可观察性
两个仪表板都出现在 CloudWatch 控制台中:一个用于端到端代理可观察性,一个用于每 KB 可观察性(BMKB,Bedrock 托管知识库)。本节的其余部分将介绍每一层显示的内容。
在此版本中,仪表板是根据类型化对象而不是 JSON 字符串构建的。指标是 Metric,小部件是 GraphWidget,布局是行列表:
cw.GraphWidget( title="L4 — Gateway metrics (MCP)", width=12, height=6, period=PERIOD, statistic="Sum", left=[ self._gateway_metric("Invocations", gateway_arn, "tools/call Invocations"), self._gateway_metric("SystemErrors", gateway_arn, "SystemErrors"), self._gateway_metric("UserErrors", gateway_arn, "UserErrors"), self._gateway_metric("Throttles", gateway_arn, "Throttles"), ], )
实际的好处并不是更少的行数,“dashboards_stack.py”运行了 400 行,比等效的 DashboardBody JSON 还要多。这是因为拼写错误的属性或无效的小部件组合在您的笔记本电脑上的“cdk合成器”上失败,大约一秒钟。 DashboardBody 字符串中的相同错误已成功部署,并在 AWS 管理控制台上呈现为损坏的小部件,您可以通过查看它来找到它。
因为 Row 接受任何小部件,所以文档是布局的一部分,而不是漂移的 wiki 页面。每个仪表板将 TextWidgets 与图表交错:
[cw.TextWidget(width=24, height=7, markdown=self._l3_explainer())], [ self._quality_widget("L3 · Financial KB — agentic quality (reference-free, 0–1)", fin_id), self._quality_widget("L3 · Weather KB — agentic quality (reference-free, 0–1)", wx_id), ],
_l3_explainer() 返回一个定义每个比率以及如何读取它的降价表,因此解释 grounded_coverage 的小部件与绘制它的小部件在同一提交中发布,并且冷打开仪表板的读者不需要猜测什么是无引用指标。
仪表板 A — 代理可观察性(端到端)。 该板以每层如何计算不同事物的解释器开头(对于 N 查询,您将看到 ~N 代理调用、~2N 检索、~3N LLM 调用和 ~5N 网关 MCP 操作,代理循环可见),然后显示 KB 指标 (L1)、网关指标和延迟 (L4)、令牌使用情况 (L6),因为代理使用 AgenticRetrieveStream,它返回一个综合的、引用的答案,而不是每个块的分数,即无参考的第 3 层质量信号,内联定义并按 KB 绘制。
在仪表板 A 上,按知识库绘制第 3 层无参考质量信号。首先是金融知识库。下图绘制了其retrieval_utilization、grounded_coverage 和duplicate_rate。
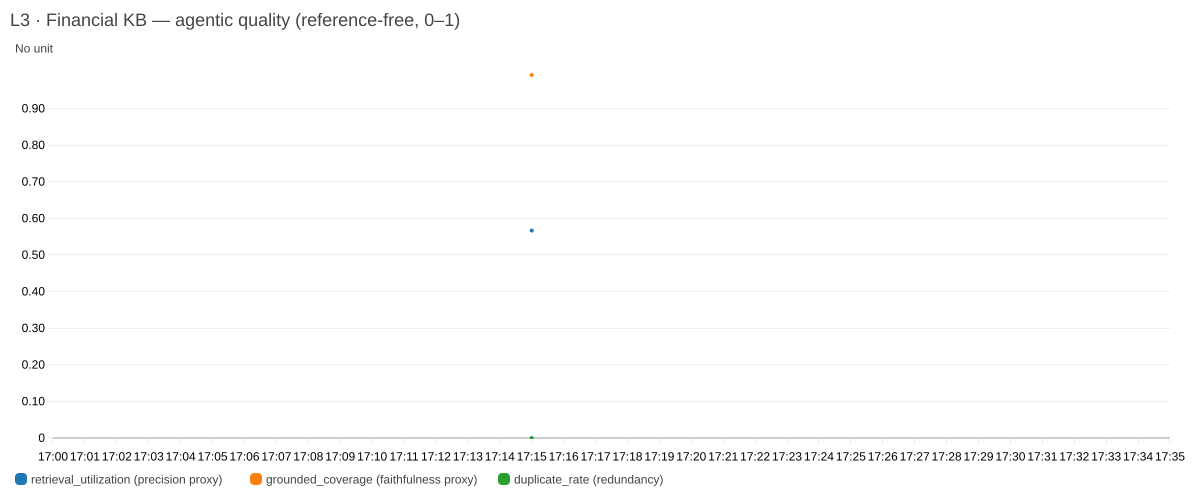
图 8:金融知识库第 3 层质量,绘制检索利用率、接地覆盖率和重复率
天气 KB 显示相同的三个信号,单独跟踪,因此这两个域永远不会模糊为一个数字。
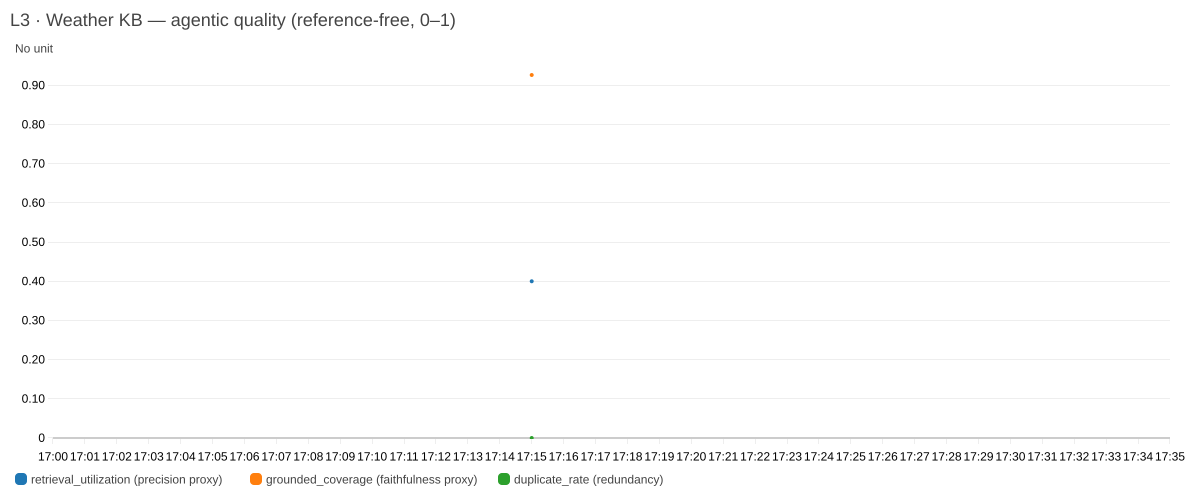
图 9:天气知识库第 3 层质量,与金融知识库分开跟踪
这两张图表绘制了金融知识库(左)和天气知识库(右)的检索利用率、接地覆盖率和重复率,因此每个知识库的检索质量保持可分离,而不是平均为一个数字。
仪表板 B — 每 KB (BMKB) 可观察性。 还确定每 KB 支出的操作信号:索引大小(来自 S3 源字节)、检索量、代理工具调用、会话令牌使用情况以及按模型划分的生成令牌使用情况,每个信号都有内联说明。
以下屏幕截图显示了仪表板 B 的四个指标小部件,在运行后填充。第一个小部件报告每个知识库从 S3 源字节派生的索引大小。
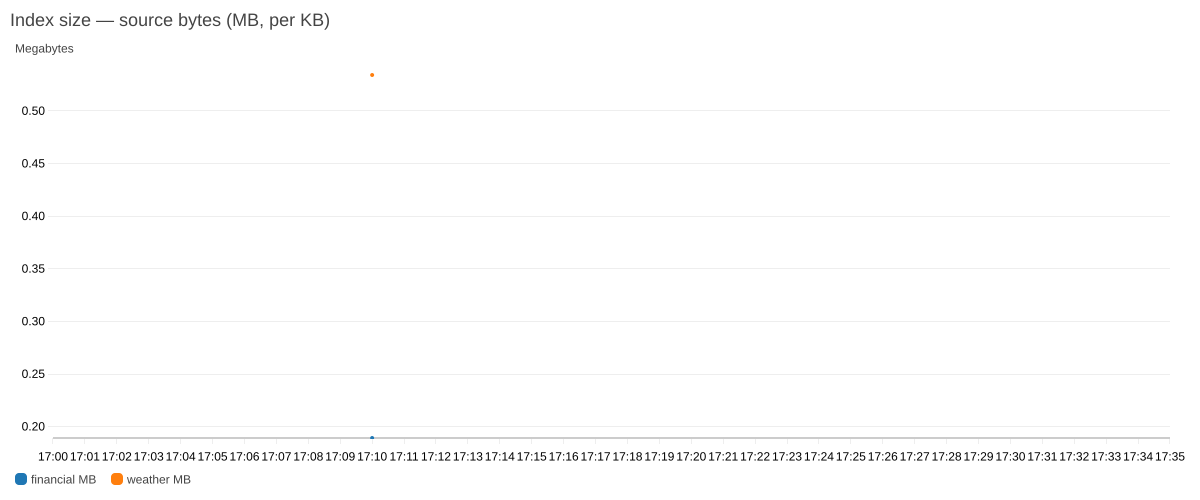
图 10:每个知识库的仪表板 B 索引大小,源自 Amazon S3 源字节
第二个小部件对每个知识库的检索调用进行计数。
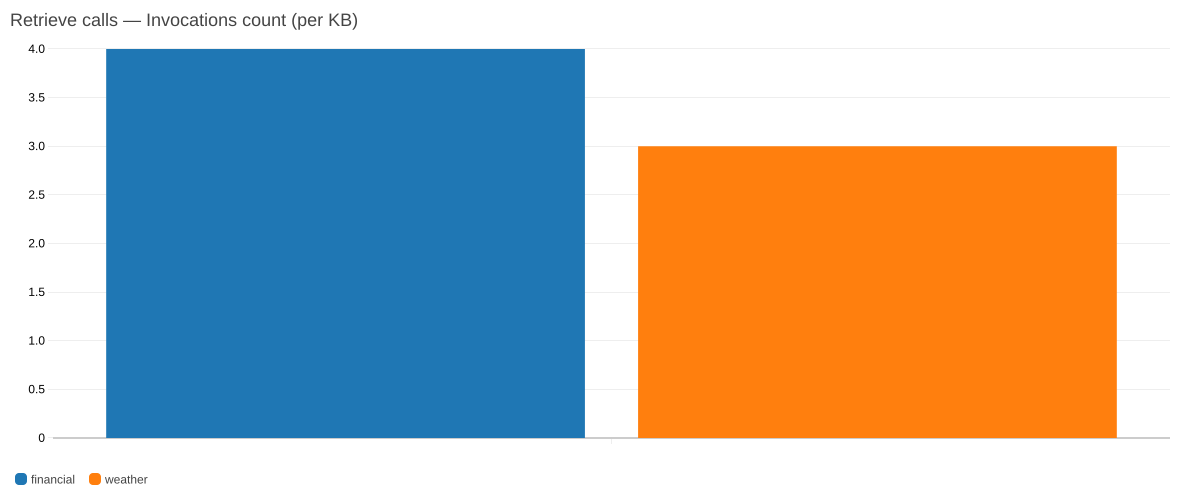
图 11:仪表板 B 每个知识库的检索调用计数
第三个小部件对通过网关的代理工具调用进行计数。该知识库在两个知识库之间共享,而不是分割。
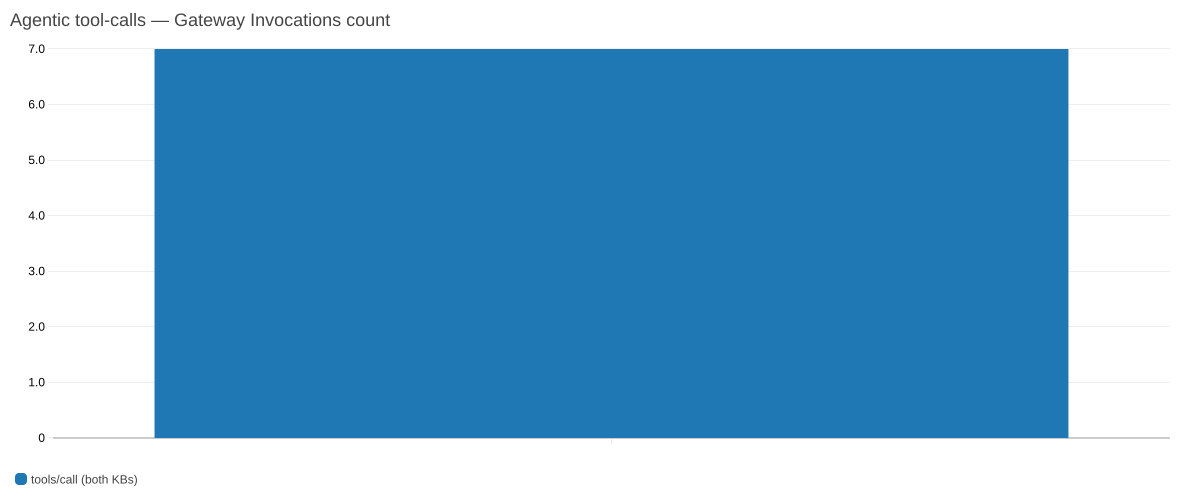
图 12:仪表板 B 通过 AgentCore 网关的代理工具调用计数,在两个知识库之间共享
第四个小部件报告每个知识库的会话令牌使用情况。
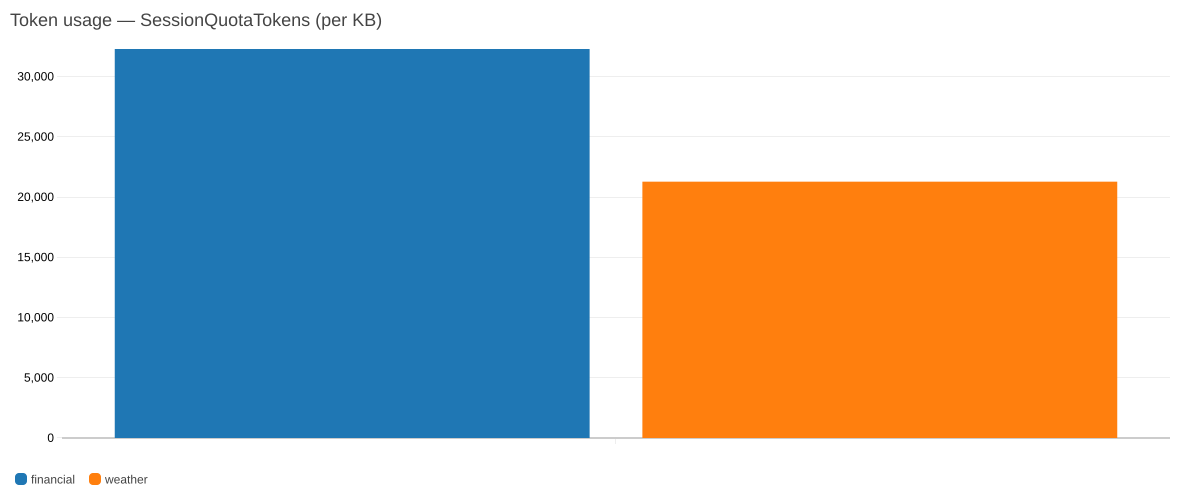
图 13:每个知识库的仪表板 B 会话令牌使用情况
这四个小部件显示索引大小(来自 S3 源字节)、检索调用量、通过网关的代理工具调用以及会话令牌使用情况。除网关工具调用计数外,每个知识库均按知识库进行细分,网关工具调用计数在两者之间共享。
有一个维度细节值得一提,因为类型化 API 不会为您捕获它:“AWS/Bedrock/KnowledgeBases”命名空间需要一个前缀 id“knowledge-base/
L1 — AWS/Bedrock/KnowledgeBases wants the prefixed form.
dimensions_map={"Operation": "Retrieve", "KnowledgeBaseId": f"knowledge-base/{kb_id}"}
BMKB/* — our own namespaces use the bare id.
dimensions_map={"KnowledgeBaseId": kb_id}
第 5 层:生成树
第 5 层是 aws/spans 中的原始 OTEL span 树,它是直接向您显示代理循环的层。值得仔细阅读,因为嵌套并不明显:一次 LLM 调用会产生三个跨度。 Strands invoke_agent 范围包装轮次,内部 chat 范围包装模型调用,类型 CLIENT 的 chat
以下屏幕截图显示了 aws/spans 中的跨度树,其中三跨度嵌套在顶行中可见。
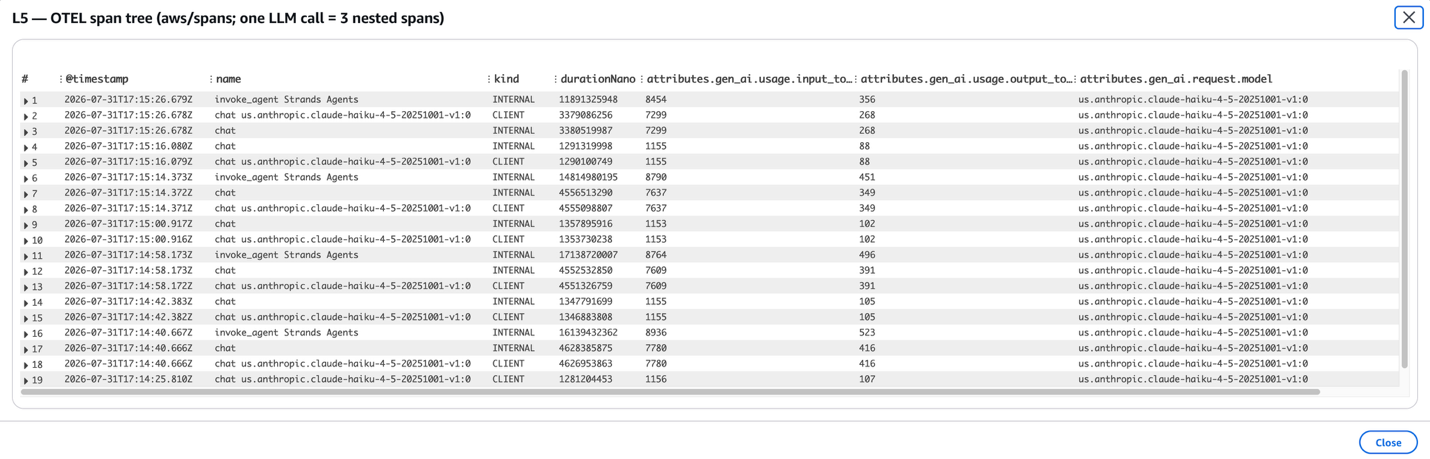
图 14:aws/spans 中的第 5 层跨度树,显示单个 LLM 调用的三跨度嵌套
读取前三行:invoke_agent Strands Agents 聚合,然后是内部聊天范围,然后是 CLIENT 聊天范围,所有这些都报告相同的 7,299 个输入和 268 个输出令牌。这是相同的 LLM 调用出现在树的三个级别,这就是聚合需要小心的原因。
当你聚合的时候,这种结构就很重要。要对每个 LLM 调用计数一次,请过滤到“CLIENT”叶:
fields attributes.gen_ai.request.model as model, attributes.gen_ai.usage.input_tokens as in_tok, attributes.gen_ai.usage.output_tokens as out_tok | filter ispresent(in_tok) and kind = 'CLIENT' and name like /^chat / | stats sum(in_tok) as input_tokens, sum(out_tok) as output_tokens, count(*) as llm_calls by model
如果没有该过滤器,相同的查询会报告三倍的令牌和三倍的调用。
应用该 CLIENT-leaf 过滤器,以下屏幕截图显示了按模型划分的生成令牌使用情况,每个 LLM 调用都计数一次。
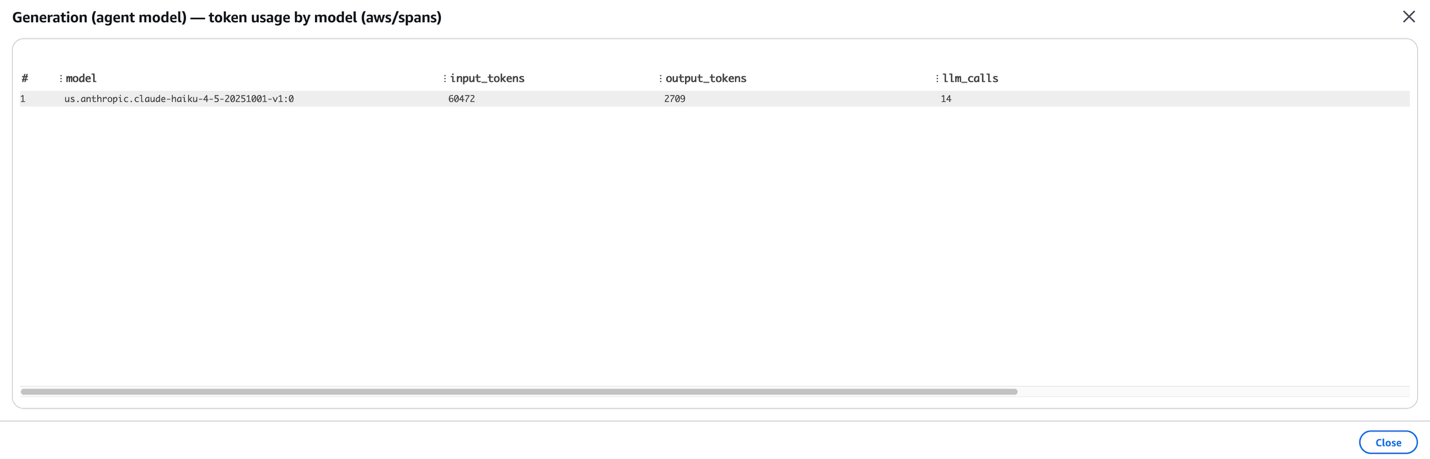
图 15:按模型划分的生成代币使用情况,每个 LLM 调用计数一次
过滤器就位后,运行显示 14 个 LLM 调用,总计 60,472 个输入和 2,709 个输出标记。如果没有它,相同的查询将报告三倍的调用和三倍的令牌。
评估:按需且连续
质量有两种衡量方式,均由应用程序提供。
按需: 驱动程序笔记本调用 AgentCore 此版本中没有部署脚本,这就是要点:(LLM作为评判)针对内置评估器、正确性、忠实性、工具选择准确性的每个会话跨度,并将分数发布到 CloudWatch,它们在仪表板 A 上显示为第 7 层。
以下屏幕截图显示了仪表板 A 上的第 7 层:每个知识库的按需评估分数,以及同一仪表板上的第 5 层 OTEL 范围表。
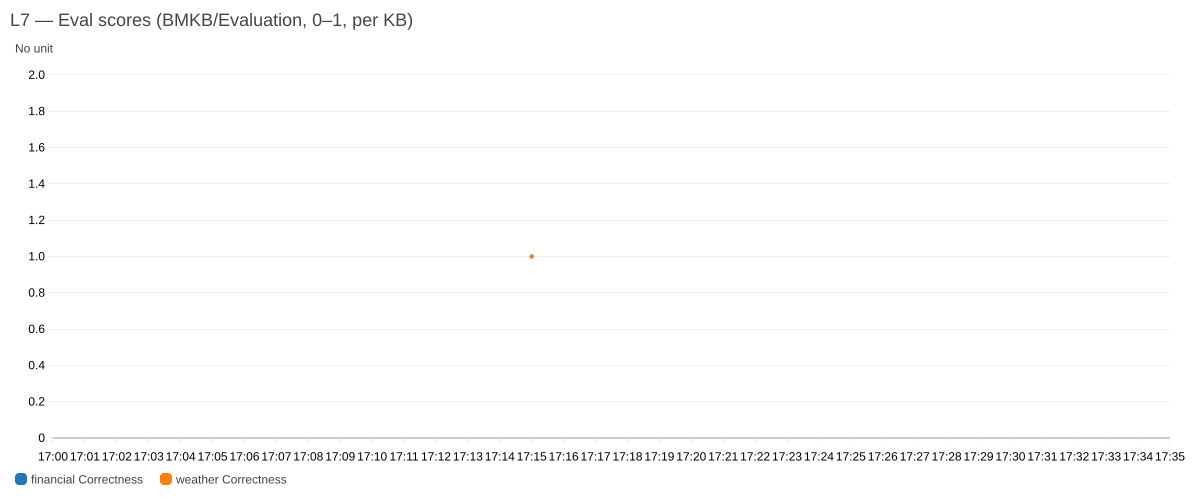
图 16:每个知识库的第 7 层按需评估分数,位于第 5 层跨度表旁边
第 7 层显示每个知识库的按需评估分数,旁边有第 5 层 OTEL 跨度表,因此分数和产生它们的跨度在一块板上一起读取。
连续(在线): 代理堆栈还提供了一个“AWS::BedrockAgentCore::OnlineEvaluationConfig”,它可以对实时会话进行采样并自动对其进行评分,无需运行笔记本。配置本身在 Bedrock AgentCore 控制台的评估 → 评估 → 评估配置下可见。结果存放在日志组“/aws/bedrock-agentcore/evaluations/results/
以下屏幕截图显示了 AgentCore 控制台中的在线评估配置,依次位于“评估”、“评估”和“评估配置”下。
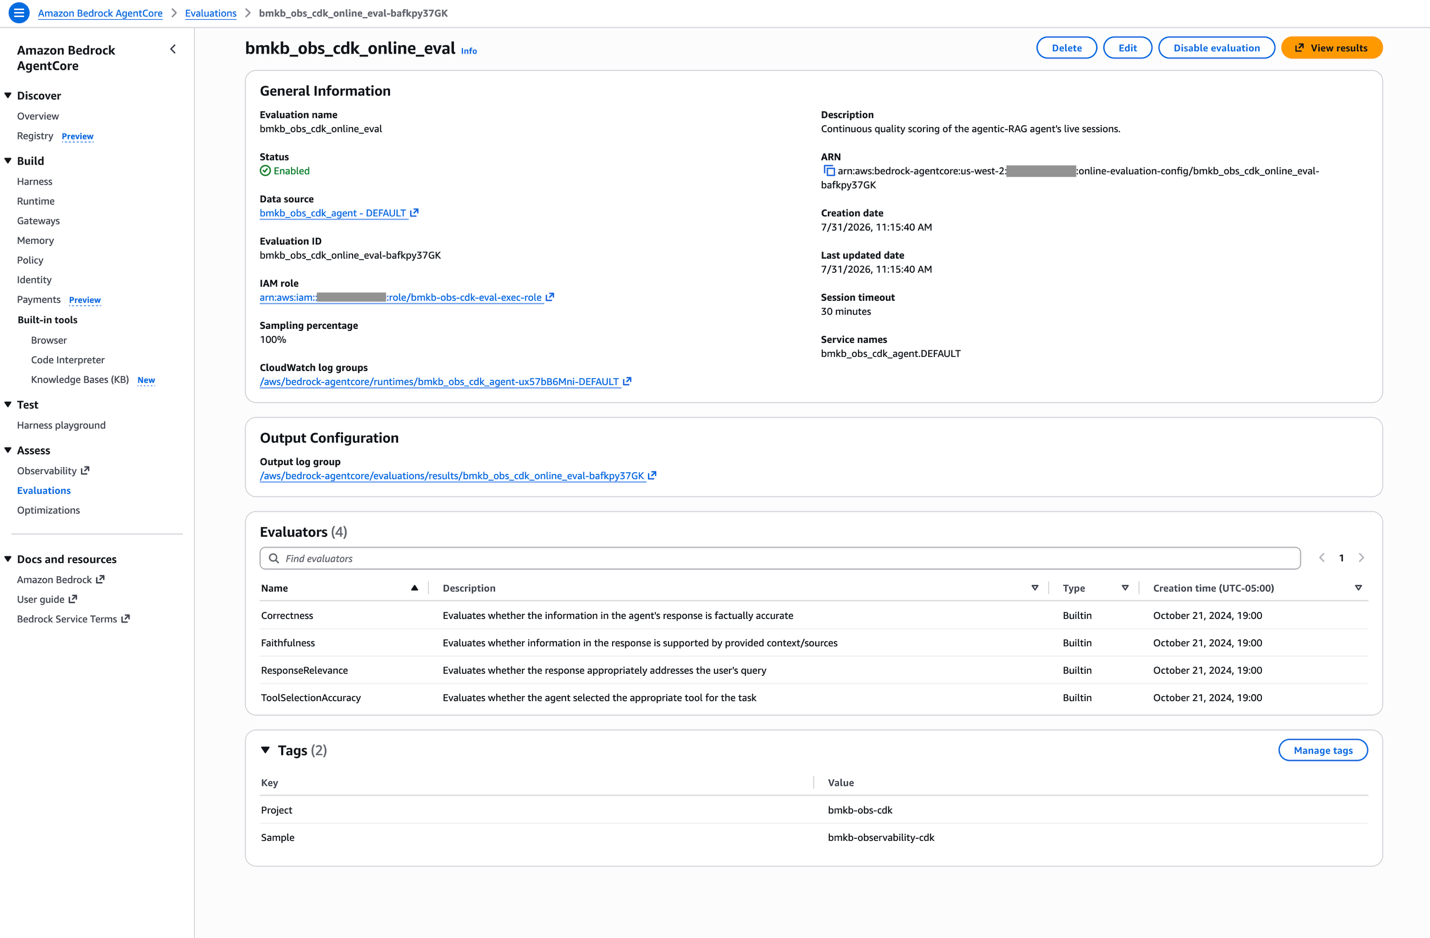
图 17:AgentCore 控制台中的在线评估配置,具有四个 100% 采样的内置评估器
配置列出了四个内置评估器:工具选择准确性、忠实性、正确性和响应相关性,设置为 100% 采样并显示为活动并启用。
因为分数是普通的 CloudWatch 指标,所以它们像其他任何东西一样绘制图表,没有日志解析,并且相同的小部件可以携带警报。以下屏幕截图显示了这四个评估者分数,以普通 CloudWatch 指标的形式绘制。
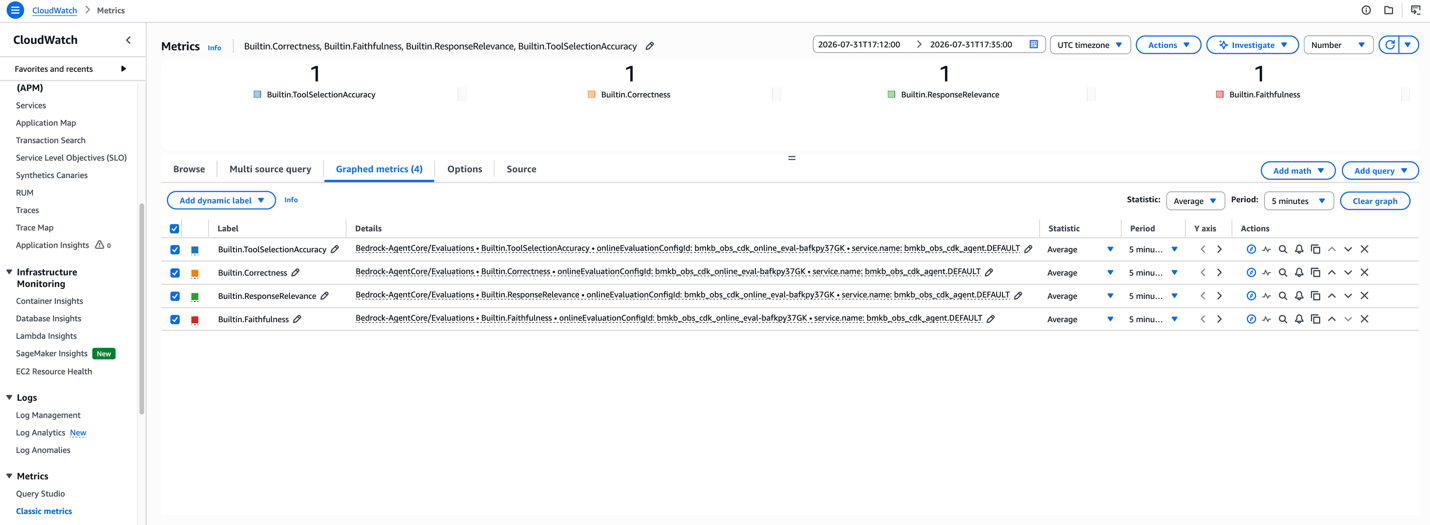
图 18:四个连续评估者分数以普通 CloudWatch 指标的形式绘制
四个评估器分数在“Bedrock-AgentCore/Evaluations”命名空间中显示为指标,每个分数都与评估配置 ID 和代理的服务名称相关,因此您可以对它们进行绘图或发出警报,而无需解析日志。
在线结果仅在会议结束后才会到达。评分在已完成的会话上运行,因此在增加流量后,结果日志组在大约会话空闲超时(约 30 分钟)内保持为空。运行后立即出现空组是正常现象,而不是配置错误。每个结果事件都带有“session.id”,因此它会连接到所有其他层。笔记本中的点播路径没有这样的等待,这就是两者都在这里的原因。
在这次运行中的四个内置评估器中,连续路径在正确性、忠实性、响应相关性和工具选择准确性方面得分为 1.00,每个评估器有 5 个评分轨迹,每个结果都带有书面解释。
⚠️ 采样和成本。 此应用程序设置 SAMPLING_PERCENTAGE = 100 纯粹用于博客实验,因此每个会话都会进行评分,并且结果立即可见。 这不是生产建议。 在线评估会在每个采样会话中调用LLM作为评委,因此成本随采样率和流量而变化。对于实际部署,请选择适合您的质量监控需求和预算的采样百分比,并在启用之前将配置与您组织自己的策略和成本治理要求保持一致。该比率是“config.py”中的一个常量“EvalConfig.SAMPLING_PERCENTAGE”。
## 清理
完成后,删除解决方案,这样它就不再产生费用,因为存储的 KB 数据、ECR 中的代理映像以及仍然有效的在线评估都会在堆栈闲置时产生费用。一个命令就能摧毁一切:
cdk destroy --all
CDK 按反向依赖顺序删除其自身的堆栈,仪表板,然后是代理,然后是网关,然后是 kb:它为部署派生的相同图表,向后走。没有与部署脚本保持一致的拆卸脚本,这是对依赖项进行一次建模的更有价值的属性之一。
有两种删除行为值得了解,因为它们都取代了手写的清理代码:
self.source_bucket = s3.Bucket( self, "SourceBucket", removal_policy=RemovalPolicy.DESTROY, auto_delete_objects=True, # replaces a list_object_versions delete loop )
self.repository = ecr.Repository( self, "AgentImageRepo", removal_policy=RemovalPolicy.DESTROY, empty_on_delete=True, # replaces an image-delete loop )
两者都是为了样本卫生而设置的,对于您关心的任何内容,请将存储桶切换到“RemovalPolicy.RETAIN”。
CDK 引导堆栈(“CDKToolkit”)及其暂存桶不会被删除。它们是其他 CDK 应用程序可能依赖的共享帐户范围基础设施。
单次解决方案以来发生了什么变化
这篇文章和 2024 解决方案 都是 Python 中的 CDK 应用程序,使用“cdk deploy”进行部署。创作工具在这里是不变的,改变的是它下面的架构,而且大部分的改变是减法:
关注2024:单发 RAG这个解决方案 矢量商店您配置、扩展和支付 OCU 费用的 OpenSearch 无服务器集合和索引没有任何。类型:托管,Amazon Bedrock 拥有存储和索引 索引生命周期自定义资源创建索引并等待它变得可搜索没有什么可创造的 嵌入模型您选择它并授予模型访问权限默认由服务管理 堆栈3:知识库角色 → OpenSearch 基础设施 → 知识库 + 数据源4:kb → 网关 → 代理 → 仪表板 检索通过向量相似度检索前 k 个块AgenticRetrieveStream,在内部重新排名,返回综合引用的答案 选择知识库不适用,只有一个索引代理在语义上跨两个进行路由 二看语料库不可能一举两得客服人员在应答前再次检索 遥测没有配置七层,两个仪表板 评价手册:同步、选择模型、提出问题按需和连续,均已配置 闲置时的成本下限无论您是否查询,OCU 都会产生费用仅限存储
贸易在两个方向都是真实的。回答单次问题的单个索引对于每个查询来说更便宜,更容易推理,并且当一个语料库包含答案时完全足够。当没有这种设计时,就采用这种设计。
CDK 构建完成工作
四个结构在这个应用程序中占据了大部分的比重,它们值得命名,因为每个结构都取代了人们手写的东西:
提供程序 – 适用于超出 AWS Lambda 函数 15 分钟上限的自定义资源。 “on_event”/“is_complete”拆分意味着轮询循环中没有任何内容休眠,并且返回 CloudFormation 的响应协议是框架的工作,而不是每个处理程序中供应的“urllib”回调。 BucketDeployment – 上传语料库,因此摄取自定义资源仅摄取。 auto_delete_objects=True 和 empty_on_delete=True,替换手写的 list_object_versions 和图像删除循环,否则堆栈需要完全可销毁。 repository.grant_pull_push(project) – CodeBuild 需要的八个 ecr:* 操作的一行,通过构造正确拼写。
并从“观察”部分输入仪表板:Metric / GraphWidget / Row 对象,而不是 DashboardBody JSON 字符串,这会将无效的小部件组合从“在控制台上渲染损坏”移动为“在‘cdk Synth’处失败”。
CDK 不会改变的两件事,在开始之前都值得了解:
自由格式 JSON 保持驼峰命名法。 connector_parameters 和 parameter_values 是逐字传递的,因此 AWS CDK Snake_case 到 PascalCase 的转换不适用于它们内部。像 bucketName 和 inclusionPrefixes 这样的键必须完全按照 API 的预期拼写,并且在资源失败之前不会告诉您其他情况。 字符串类型的值仍然是字符串。 观察部分中的“knowledge-base/
这也不是选择一种工具而不是另一种工具的理由。它们是“类型化”给你带来的边界,知道边界在哪里是 CDK 令人愉快而不是令人惊讶的主要原因。
结论
我们在托管 Amazon Bedrock 知识库和 AgentCore 上构建了完整的企业代理检索解决方案:多 KB 语义路由、推理代理、七层可观察性以及按需和持续评估,并将其全部部署为单个 AWS CDK 应用程序。
有两件事值得拿走。托管知识库删除了而不是添加了基础设施:无需配置向量存储,无需创建和等待索引,在系统空闲时不会累积 OCU 行项目。它也是支持代理检索和 AgentCore Gateway 连接器的知识库类型,如 Amazon Bedrock 文档 中所述。一旦检索变得具有代理性,可观察性就不再是可选的。该应用程序提供的大约一半内容是为了回答代理实际做了什么以及答案是否好,这对代理系统来说不是开销。这是使一个人可操作的部分。
CDK 创作模型赢得了自己的一席之地。在这个架构中,有七个值跨越堆栈边界,并且每个值都是构造引用而不是导出/导入对,这也是为什么没有部署脚本、没有拆卸脚本、也没有需要记住的固定顺序的原因。
从这里,您可以将数据源指向您自己的语料库,将代理放置在虚拟私有云 (VPC) 中,根据您的预算和策略调整在线评估采样率,或者向路由器添加更多知识库。要了解更多信息,请参阅 Amazon Bedrock 详细信息页面和 Amazon Bedrock 文档。该应用程序、驱动程序笔记本和独立实用程序均位于附带的 GitHub 存储库 中,因此您可以克隆它并使用一个命令部署您自己的副本。
关于作者