在线AI教程 / AI部署
[Amazon Bedrock] 停止猜测 Amazon SageMaker AI 上 TTS 的自动扩展目标
人工智能 停止猜测 Amazon SageMaker AI 上 TTS 的自动缩放目标 流量高峰到达您的自托管文本转语音 TTS 端点,并且请求开始排队。当大多数呼叫者正在收听时,
人工智能
停止猜测 Amazon SageMaker AI 上 TTS 的自动缩放目标
流量高峰到达您的自托管文本转语音 (TTS) 端点,并且请求开始排队。当大多数呼叫者正在收听时,延迟就会超过您的服务级别目标 (SLO)。该端点背后的自动扩展策略应该可以防止这种情况发生,但它扩展的目标值是一个猜测,并且类似的猜测会默默地失败,直到实际流量证明它们是错误的。
如果这个数字错误,它会以两种方式之一付费,并且都不会显示为警报。猜想太保守了,队列运行的 GPU 实例大部分处于闲置状态。该费用包含在每张发票上,但绝不会包含在事故报告中。如果猜测过于激进,舰队就会面临无人察觉的风险。每个实例持有的并发请求数量超出了其在延迟承诺范围内所能提供的服务数量。在真正的流量高峰使排队时间超过 SLO 之前,一切看起来都没什么问题。当大多数来电者都在听的时候,这种情况就会发生。这就是隐藏的差距。一项在控制台上看起来不错的政策可能已经让它应该服务的人们失望了。
在本文中,我们将 Kokoro-82M(一个 8200 万参数的 TTS 模型)部署为 Amazon SageMaker AI 实时终端节点上的自定义容器。 AWS 云开发工具包 (AWS CDK) 堆栈处理部署。我们用针对实时端点进行的两次测量来代替猜测。 “Q_max”是一个实例在违反 SLO 之前维持的最高并发量,“T_total”是横向扩展所需的时间。我们通过算术从这两个数字得出扩展阈值、缩减阈值和冷却时间。本文中的每个数字都来自本文中引用的 aws-samples 存储库的实际部署和测量运行。
为什么默认自动缩放指标不适用于 TTS
大多数有关 Amazon SageMaker AI 自动扩展的公开指南都针对短同步请求/响应调用或大型语言模型 (LLM) 服务,其中自然指标是每秒生成的令牌。 TTS 合成不适合这两种模式:单个请求使连接保持打开状态几秒钟,没有令牌生成循环来附加指标。 Kokoro-82M 是非自回归的,是带有 ISTFTNet 解码器的 StyleTTS2 衍生品,采用对抗性训练,而不是通过自回归下一个标记预测或迭代去噪进行训练。它从一个持续时间对齐的通道中生成完整的话语。首先没有生成循环来使用每个代币指标进行检测。决定 TTS 实例是否过载的因素比听起来更简单:现在有多少请求正在排队并在其上执行。
部署的策略根据“ConcurrentRequestsPerModel”进行扩展,这是 Amazon SageMaker AI 自行发布的一项本机指标,而不是该项目自己的容器代码必须发出的指标。根据 Amazon SageMaker AI 发布的指标进行扩展可以消除一类故障,即自定义指标配置在纸上看起来正确,但实际上没有发布任何内容。
“ConcurrentRequestsPerModel”发布 10 秒窗口内的最大统计数据,该数量与基准测试客户端直接测量的平均飞行计数不同。工具解释了这一点。在并发阶梯的每个梯级上,它都会针对相同负载测量这两个数量并记录它们之间的比率。然后,它使用该比率将客户端测量的阈值转换为 Amazon CloudWatch 单位,然后再将其写入可部署配置。对于本文中运行的 Kokoro-82M,每个梯级的测量比率都恰好为 1.0,因此客户端测量的阈值和 Amazon CloudWatch 报告的阈值直接匹配。
解决方案概述
该解决方案将 Kokoro-82M 部署在 Amazon SageMaker AI 实时终端节点上的自定义容器中,然后将猜测的自动扩展目标替换为根据针对该实时终端节点进行的两项测量得出的目标:“Q_max”(一个实例在 SLO 内提供的并发上限)和“T_total”(实际横向扩展需要多长时间)。综合请求流经四层:客户端、Amazon SageMaker AI 终端节点、该终端节点后面的 GPU 实例上的自定义容器以及容器内的 Kokoro-82M 模型。
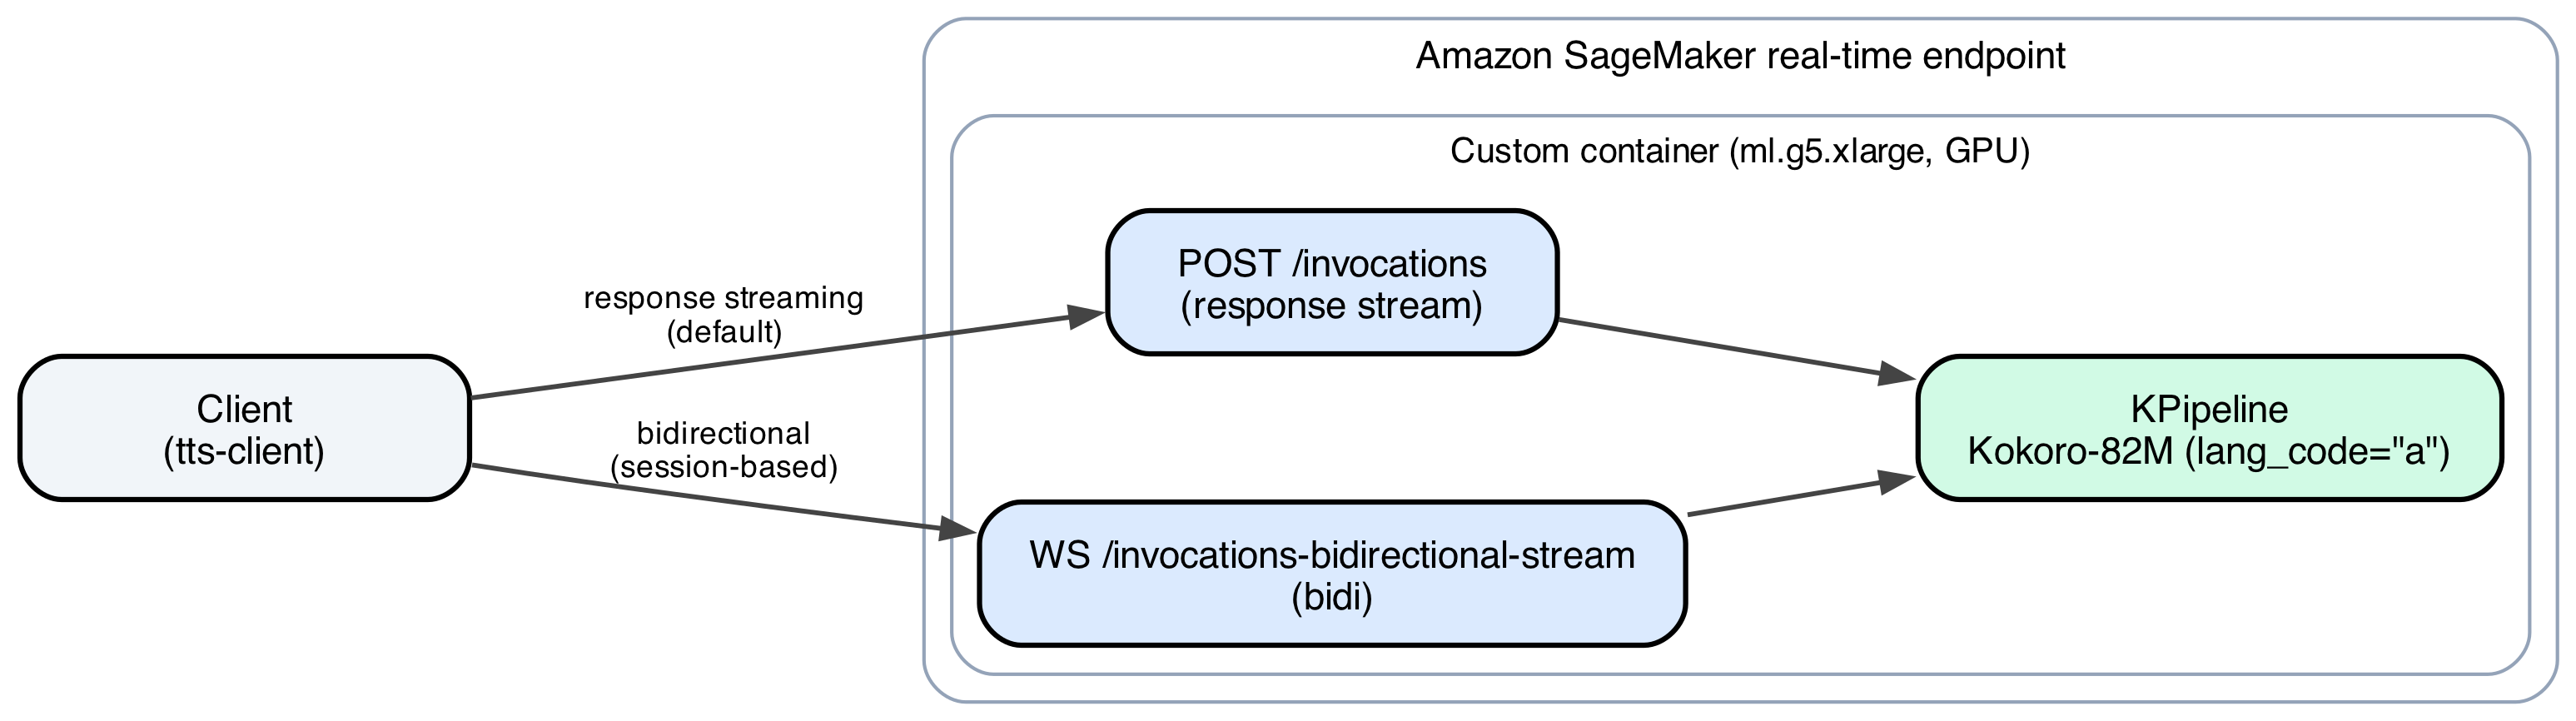
图 1:Kokoro-82M 请求路径,从客户端通过 Amazon SageMaker AI 终端节点和自定义容器到达模型
该容器支持两种有线传输:响应流(“InvokeEndpointWithResponseStream”),它在合成时将音频流式传输回来,以便在话语结束之前开始播放;以及双向流(“InvokeEndpointWithBi DirectionStream”),它为多个消息打开一个长期会话。
在自定义容器中运行 Kokoro-82M,而不是在托管推理工具包后面,这使得本文的其余部分成为可能。您控制的容器可以强制实施其自身的准入限制,并公开 Amazon SageMaker AI 已发布的确切并发信号,而不是将借来的指标改造到并非为其构建的工作负载上。部署此终端节点的 AWS CDK 堆栈仅在模型存在真实的、测量的“计划”时才附加自动扩展资源,因此猜测的配置永远无法静默地到达生产环境。这篇文章的其余部分就是这个测量。
先决条件
要遵循本演练,您需要:
有权创建 AWS Identity and Access Management (IAM) 角色、Amazon Simple Storage Service (Amazon S3) 存储桶、Amazon Elastic Container Registry (Amazon ECR) 存储库和 Amazon SageMaker AI 资源的 AWS 账户。 注意:示例容器将早期的 PyTorch 与已知建议(“PYSEC-2026-2286”,已在 torch 2.10.0 中修复)固定在一起。在进行任何非价值证明使用之前,请检查并升级密码。 AWS CDK v2,在您的目标账户和区域中安装并引导。 Python 3.11 或更高版本、uv 和 Docker 来构建容器映像。 在运行本文中的横向扩展测量之前,“ml.g5.xlarge”服务配额至少有一个备用插槽高于您的基线。 本文引用的 GitHub 存储库 中的部署代码。
演练
在本演练结束时,您将获得 Kokoro-82M 的实时 Amazon SageMaker AI 自动扩展策略,该策略完全源自针对您自己的终端节点进行的两次测量,而不是猜测。
部署端点堆栈
终端节点通过三个 AWS CDK 堆栈进行部署,按顺序应用:“SpeechFoundationStack”创建 IAM 角色和缓存模型权重的 Amazon S3 存储桶,“SpeechModelCacheStack”将模型的 Hugging Face 权重同步到该存储桶一次,“SpeechEndpointStack”构建容器映像,将其推送到 Amazon ECR,并创建 Amazon SageMaker AI 模型、终端节点配置和终端节点。
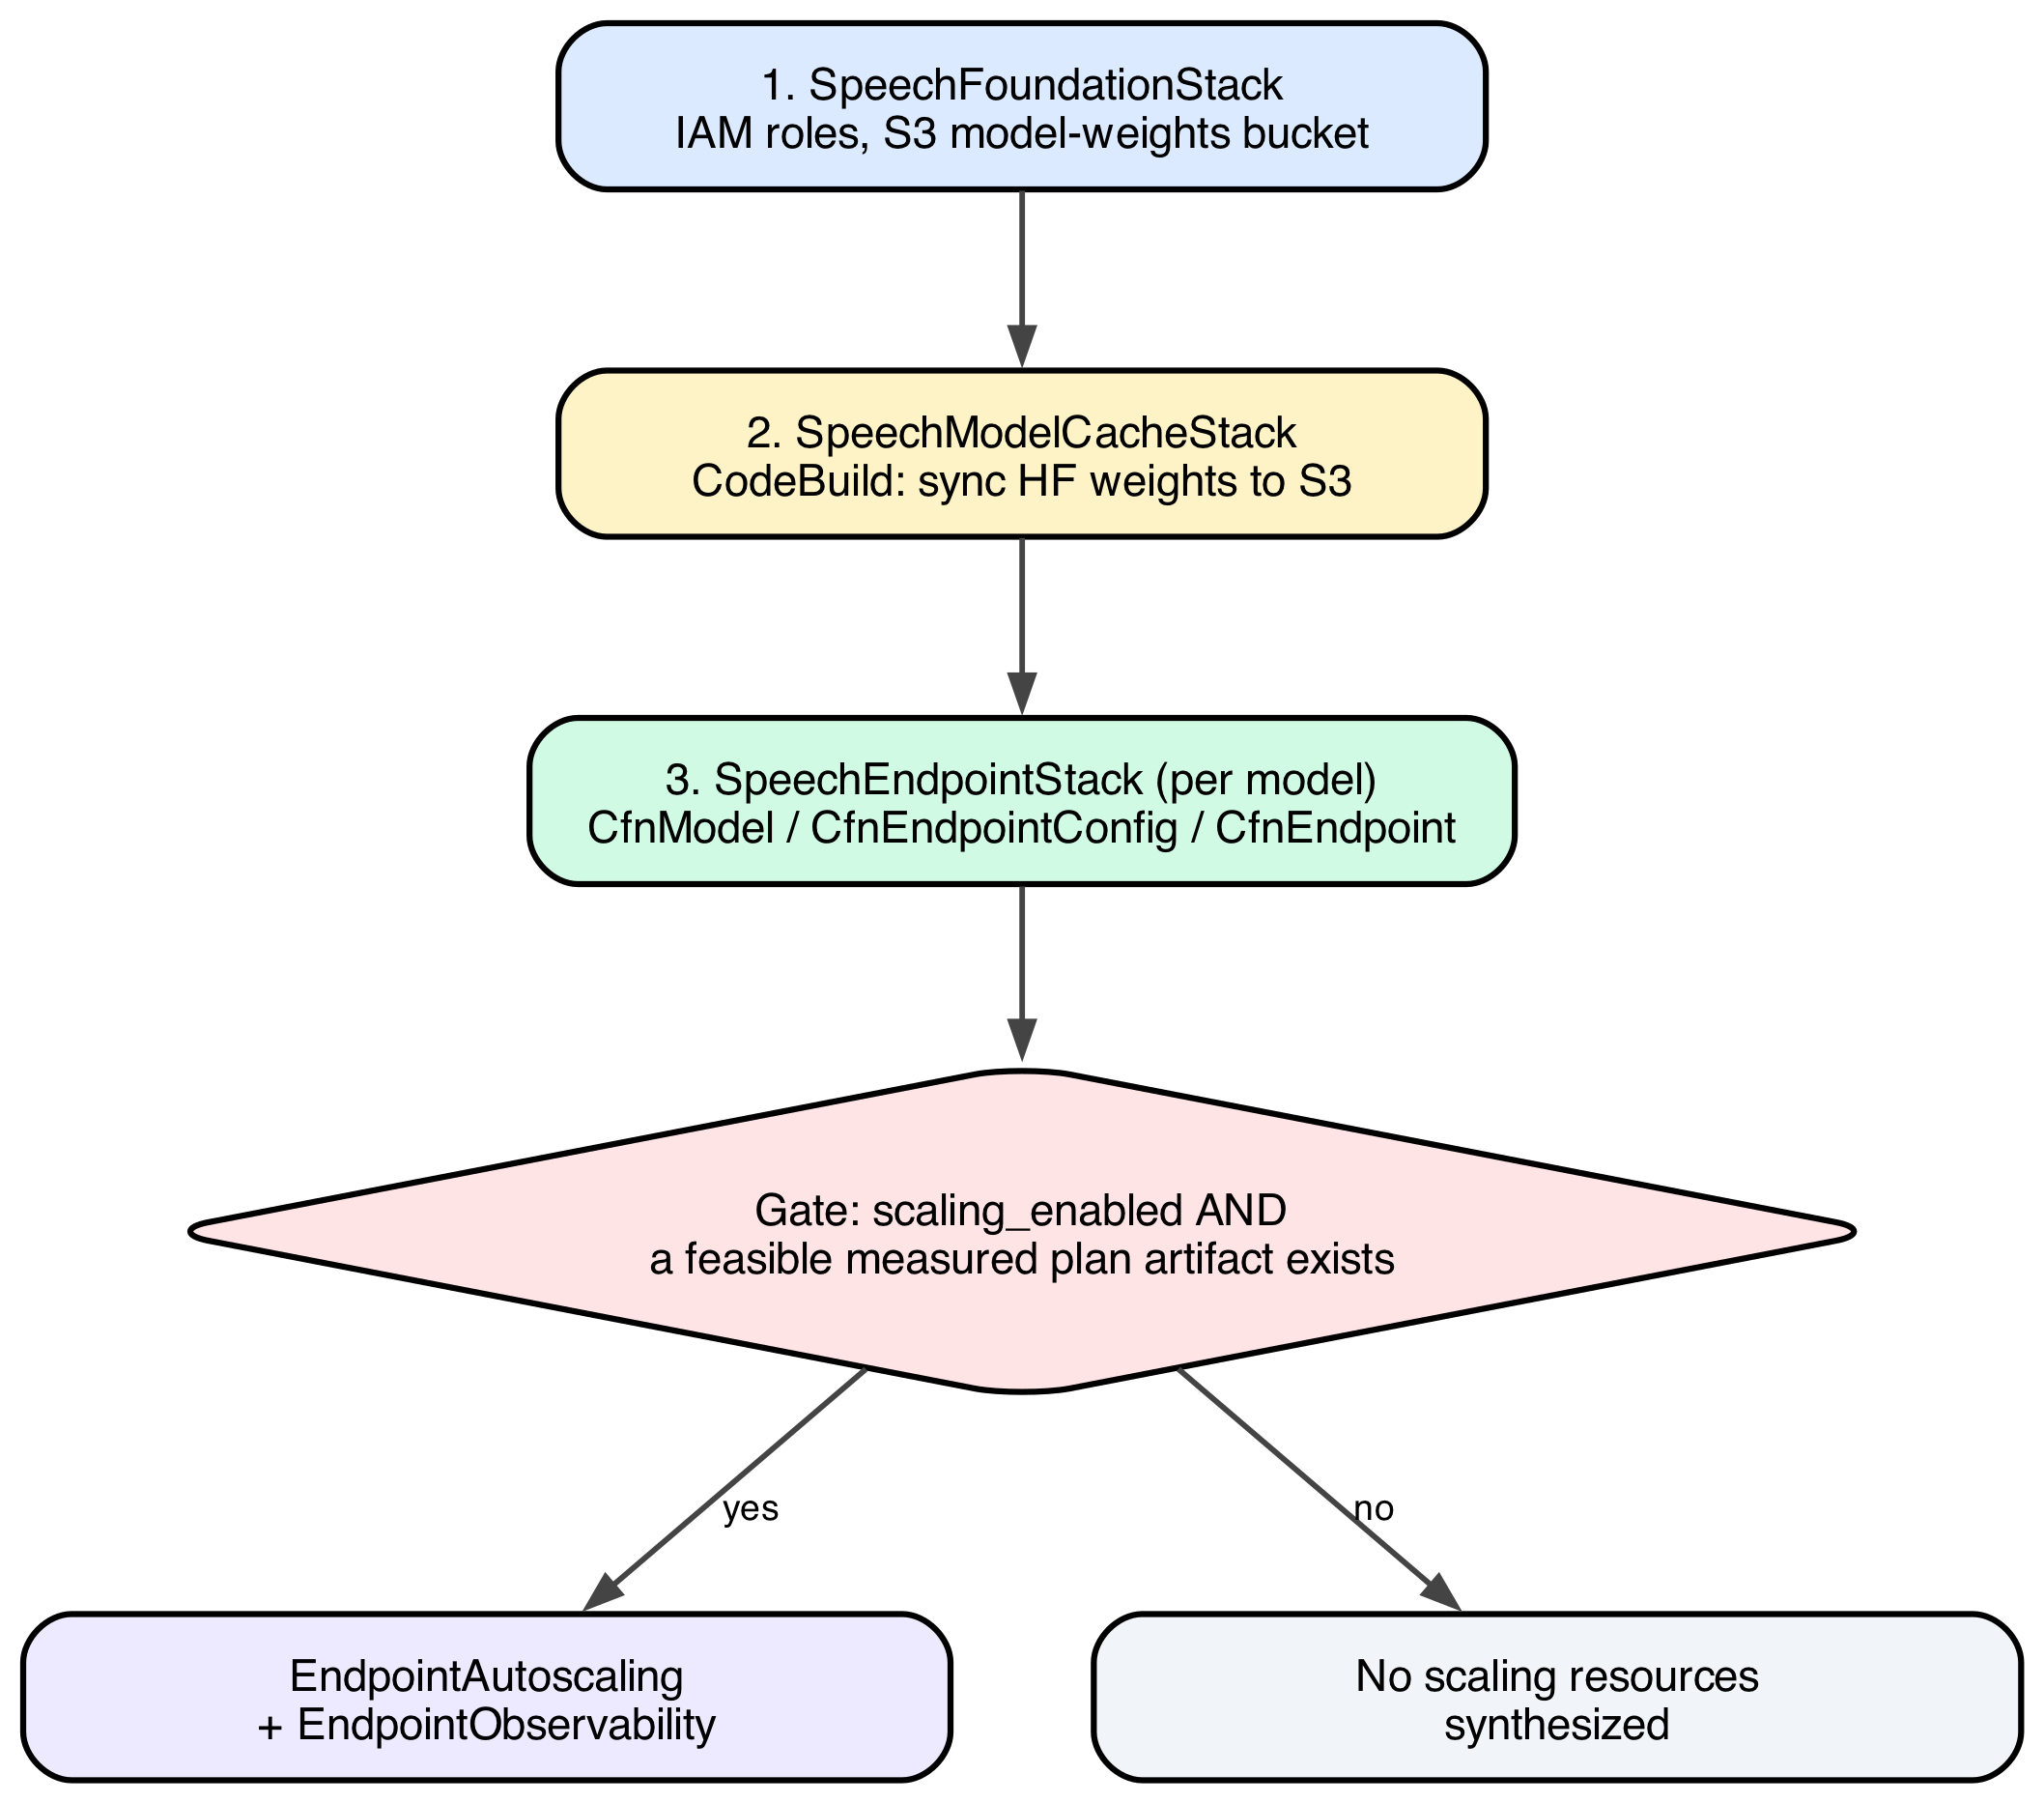
图 2:三个 AWS CDK 堆栈以及决定是否合成自动扩展资源的门
第三个堆栈上的门阻止默认的、未测量的扩展配置进入生产。 scaling_enabled 是一个静态标志,每当 max_instances 配置为大于 min_instances 时,它就为 true,并且它本身没有说明其后面的数字是否被测量过。该堆栈在综合时添加了第二个独立检查:该模型是否存在真正可行的“计划”工件?仅当这两个条件都成立时,堆栈才会综合扩展资源:连接扩展策略和警报的“EndpointAutoscaling”构造,以及添加用于监视它的仪表板和警报的“EndpointObservability”构造。具有“scaling_enabled=True”但背后没有测量的模型将获得与具有“scaling_enabled=False”的模型相同的无缩放资源输出。
该项目的 CLI 将三个堆栈包装在单个命令后面,并按依赖顺序应用它们:
uv run speech-infra deploy kokoro-82m
SpeechModelCacheStack 运行一个 AWS CodeBuild 项目,该项目将模型的 Hugging Face 权重同步到缓存的 Amazon S3 存储桶中一次。冷端点启动不需要将它们从互联网上拉出来。通过前面的“scaling_enabled”检查,“SpeechEndpointStack”构建容器映像,将其推送到 Amazon ECR,并创建 Amazon SageMaker AI 模型、终端节点配置和终端节点。
该方法打包为命令行工具链,以固定顺序运行:

图 3:工具链按顺序运行,每个命令将一个工件传递给下一个命令
第 1 步:检查漂移
每次,“drift”都会先运行,然后再执行任何需要花钱或使端点处于负载状态的操作。它是实际部署的内容(可扩展目标、扩展策略、警报状态)和配置文件所说应该部署的内容之间的只读协调。早期模型中的孤立策略,或者停止或取消的“qmax”或“ttotal”运行,否则会在测量过程中默默地移动容量并损坏正在测量的数字。
uv run tts-bench drift
干净的结果报告没有不匹配,并以预检正常状态退出,为“qmax”扫清了道路。停止或取消的“qmax”或“ttotal”运行是报告的不匹配的最常见来源,因为它可能会使单个实例上的自动缩放冻结。 uv run tts-bench thaw --endpoint voice-kokoro-82m 会在继续之前恢复部署的策略,因为 qmax 和 ttotal 都假设部署状态与配置文件完全匹配。
步骤2:测量Q_max,并发上限
“Q_max”是最大并发量、排队的请求加上在一个实例上执行的请求,此时请求仍然到达 SLO 内第 95 个百分位数的第一个音频字节。它是通过闭环负载阶梯来测量的:精确地保持固定并发“N”,并一次向上移动“N”一个梯级,直到 SLO 中断。闭环避免了协调遗漏,这是固定到达率测试中的缺陷,其中缓慢的服务器使客户端发送更少的请求,而不是呈现真正的排队延迟。
uv run tts-bench qmax --model kokoro-82m --dry-run uv run tts-bench qmax --model kokoro-82m
“--dry-run” 打印时间表和挂钟估算,AWS 调用为零,因此您可以首先预算实时运行的大约 36 分钟的成本。 live 命令会冻结自动缩放并将容量固定到一个实例,并在退出时自动恢复,因此它生成的数量是真正的每个实例上限。
负载梯记录了以下结果:
并发p95 TTFAB(毫秒)满足 3,000 毫秒 SLO? 165.465.4是的 5286.2286.2是的 1010 568.5568.5是的 2020 1,129.31,129.3是的 301,689.81,689.8是的 4040 2,245.02,245.0是的 5050 2,805.72,805.7是 (Q_max) 603,374.83,374.8否(违规)
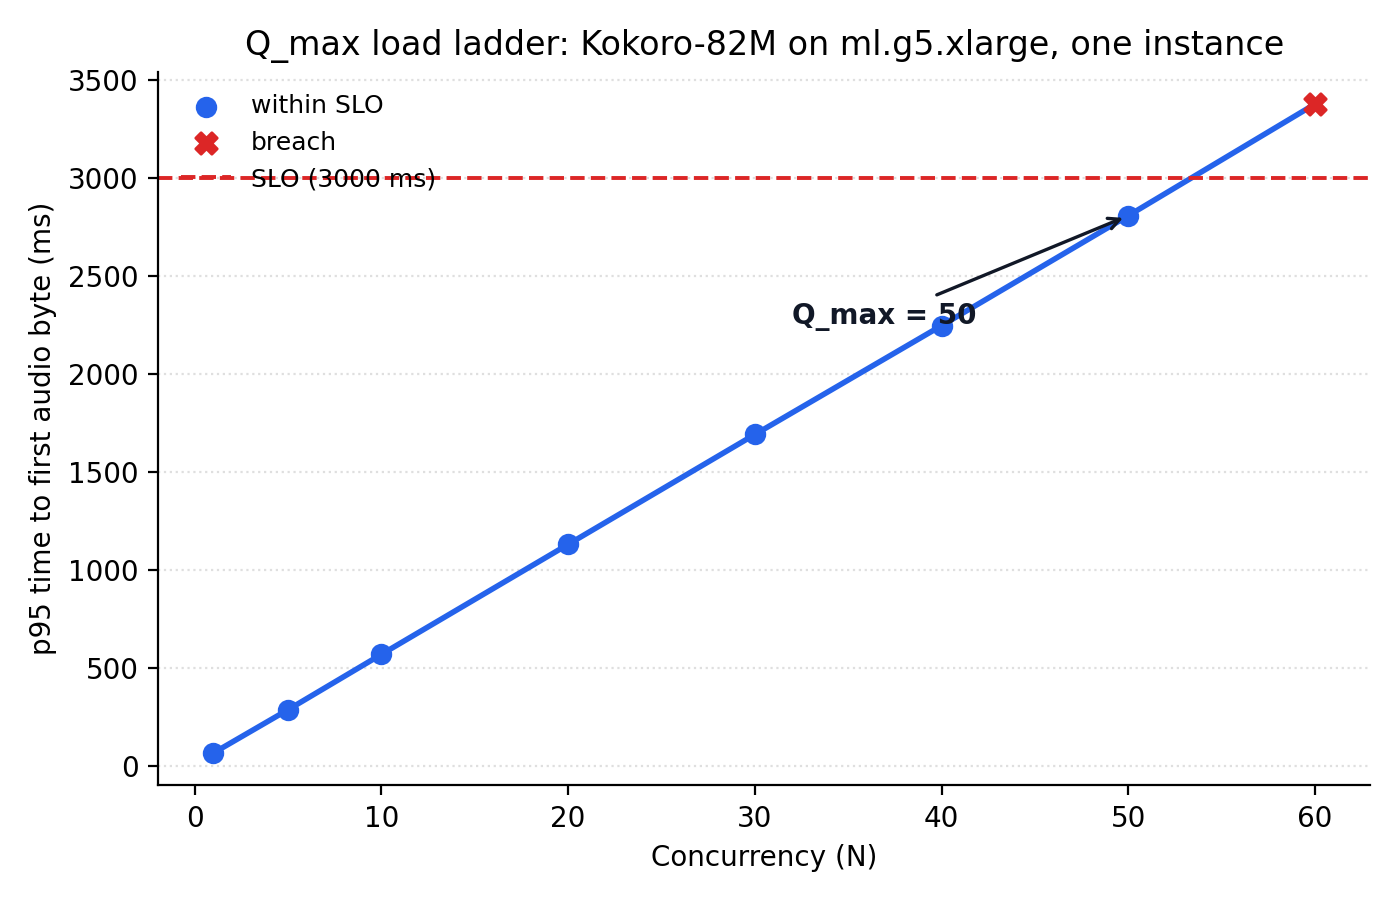
图 4:p95 相对于并发的首个音频字节时间,SLO 线和并发点为 60
Q_max = 50,这是一个括号内的结果:梯级 60 实际上跨越了 SLO,这使得 50 成为真正的上限而不是下限。同一次运行测量了无竞争服务时间,即一个请求完全没有排队所花费的时间:平均值 61.3 毫秒,p95 66.1 毫秒。该数字驱动第二个独立警报,稍后将对此进行描述。
步骤 3:测量 T_total,真实的横向扩展时间
“T_total”是挂钟,从请求更多容量的那一刻到容量为健康的流量提供服务所需的时间。它是通过直接强制横向扩展、绕过已部署策略自身的检测逻辑,然后为每个可区分的阶段添加时间戳来衡量的。
uv run tts-bench ttotal --model kokoro-82m --qmax
ttotal 需要 qmax 工件作为输入,因为它的恢复判断读取该梯子自己的测量梯级,并且拒绝与在不同有线传输上测量的梯子运行。
强制横向扩展分为八个测量阶段:
舞台持续时间“T_total”的份额 向desired_set 请求的容量30.0 秒9.4% required_set 为日志中可见的实例180.8 秒56.5%(主导) 实例对容器可见已启动3.7 秒1.2% 容器启动到framework_init0.0 秒0.0% 从framework_init到weights_ready6.5 秒2.0% 重量_准备好热身_完成1.0 秒0.3% Warmup_done 到 in_service20.7 秒6.5% in_service 流量恢复47.4 秒14.8% 测量总数 (t_total_s)260.2 秒
- 策略检测滞后,有界(未测量)60.0 秒
T_total,计划320.2 秒
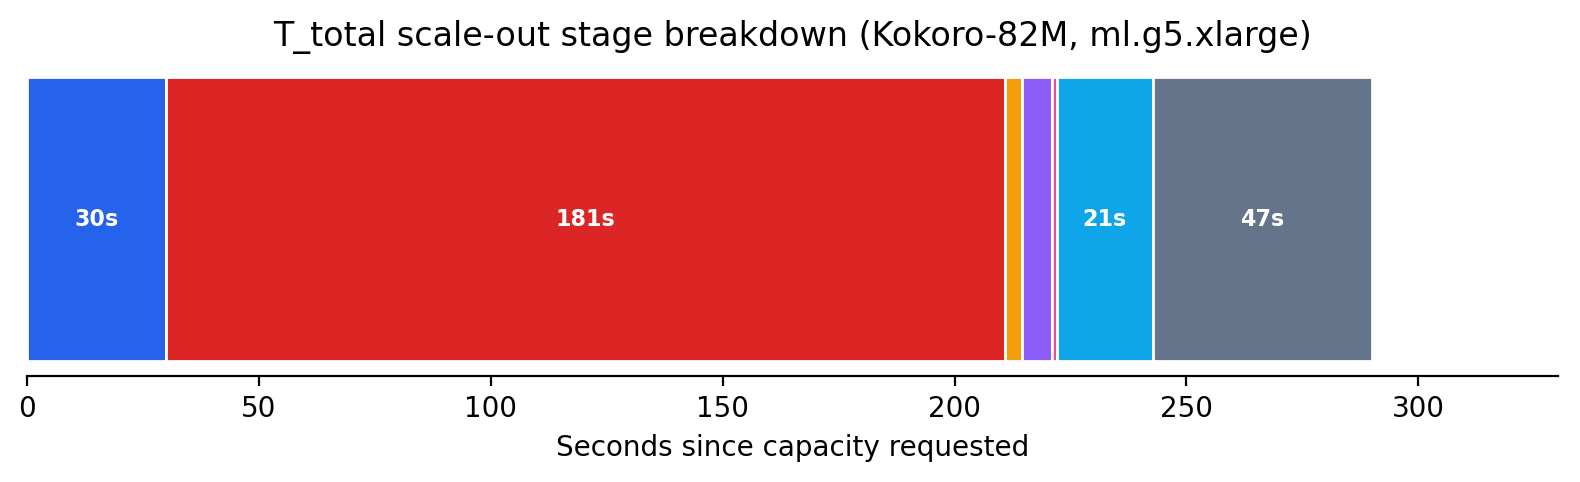
图 5:实际横向扩展的八个测量阶段,从容量请求到恢复流量
主要阶段是 Amazon Elastic Compute Cloud (Amazon EC2) 实例预置和容器映像拉取,用时 181 秒,占计划总数的 56%。减少“T_total”影响最大的方法不是应用程序代码,而是减少图像大小或使用热容量池。 “日志中可见的实例”下游的所有内容加起来相对较短,为 79 秒。
本次运行未测量测量的 260.2 秒之外的 60 秒。它受策略自身配置(警报评估期乘以评估期,加上冷却时间)的限制,因为此运行故意绕过策略的检测逻辑以隔离纯粹的配置时间。 “计划”的大小相对于 320.2 秒的总时间来说有很大的余量,因为反应时间是任何生产扩展的真实部分,即使这种测量将其排除在外。
步骤 4:通过计划导出部署的策略
“plan”是唯一一个从未接触过 AWS 的命令。它读取“qmax”和“ttotal”工件,将它们与两个操作员选择的输入、3,000 ms p95 TTFAB 的 SLO 和 1.25 倍的浪涌比(队列可以在一个横向扩展周期内容忍流量增长 25%,而不违反 SLO)相结合,并执行以下算术。然后,它打印一份报告,其中包含对每个发现的结论:“确定”、“警告”,或者,对于真正不可行的计划,“停止”。
uv run tts-bench plan --qmax
“--peak-rps”标志(此处每秒 5,000 个请求,假设波谷为 10)确定队列实例计数的大小。它不考虑下面的阈值算术。
h = surge_ratio - 1 = 1.25 - 1 = 0.25
C_scale_max = (1 - h) x Q_max = 0.75 x 50 = 37.50 C_scale_min = (1 - 2h) x Q_max = 0.50 x 50 = 25.00
W_max = SLO - S_p95 = 3.000s - 0.066s = 2.934s
“C_scale_max”是再添加一个实例的并发度,低于“Q_max”激增比例“h”,因此当队列需要更多容量时仍然有队列空间。 “C_scale_min”是删除一个实例的并发度,设置为“Q_max”的“(1 - 2h)”,因此仅当负载远低于再次触发横向扩展时才会触发横向扩展。
最终部署的配置与工具生成的配置完全相同:
"kokoro-82m": ModelEndpointConfig( model_name="kokoro-82m", instance_type="ml.g5.xlarge", min_instances=1, # trough 10 rps; 3 is the smallest safe floor for scale-in max_instances=9, # peak 5000 rps scaling_target_value=37.500, # C_scale_max, in Amazon CloudWatch units (ratio measured as 1.0) scale_in_threshold=25.000, # C_scale_min, in Amazon CloudWatch units ttfab_slo_ms=3000, queue_max_depth=50, # enforced by the container's own admission gate scale_out_cooldown_s=30, # short: one instance added at a time scale_in_cooldown_s=960, # long: see below )
两个冷却时间故意不对称。横向扩展的代价是错误的:最坏的情况是,您为一个不需要额外 30 秒的实例付费。扩展在成本上并不对称,因为删除容量并随后再次需要替换容量需要花费完整的“T_total”(320 秒)。缩减冷却时间设置为大约“T_total”的三倍,因此只有在负载真正持续下降时才会触发缩减决策。
容器自己的准入控制单独强制执行“queue_max_depth = 50”,等于“Q_max”:超过该深度,请求将立即被拒绝并返回“503queue_saturate”响应,而不是留在队列中超过可以满足 SLO 的点。 “FirstChunkLatencyP95”警报的阈值为 65 毫秒(在并发性 1 时测得的 p95 服务时间),它监视已在服务的实例上的服务时间,比端到端 SLO(包括排队)更严格。
Kokoro-82M 运行的两个发现值得包括在内,因为它们是正确呈现已知的、可接受的权衡而不是缺陷的工具:
surge_survival (警告): 将 C_scale_max (37.5) 与 Q_max (50) 保持一致,会使一个实例在横向扩展触发时达到 97.4% 的利用率,并且替换需要完整的 T_total 才能到达。激增率保留了额外的队列槽位,但在真正的激增中幸存下来取决于流量、队列耗尽的速度,并且在 97.4% 的利用率下几乎没有留下流量余量。 scale_in_safety (警告): 从一组“N”中删除一个实例会将每个剩余实例的并发性乘以“N / (N-1)”。只有当该比率保持在“C_scale_max / C_scale_min”(此处为 1.5)以下时,缩小才会保持稳定,这需要“N >= 3”。在下限为 1 实例的情况下,从 2 缩减到 1 会使幸存者恰好处于“Q_max”,正好回到触发另一次横向扩展的上限。较长的冷却时间会减弱这种拍打现象,但不会消除它。将楼层提高到 3 层会从结构上消除它,但代价是在交通流量较低时失去站立能力。
每个“qmax”或“ttotal”工件的文件名都对其测量的配置、实例类型和压缩为 slug 的容器映像摘要进行编码(例如,“g5xlarge-8b1b96bc”)。 “ttotal”和“plan”都拒绝将指纹不一致的工件配对。这可以通过“--allow-config-mismatch”降级为警告,但默认是拒绝。
步骤 5:使用 validate 确认已部署的策略
“validate”是链中的最后一个命令,第二个命令与“drift”一起,永远不会改变任何内容。它将实际部署的扩展策略与“计划”工件中的值进行比较,在将配置视为活动配置之前确认两者匹配。
uv run tts-bench validate --model kokoro-82m --plan
干净的结果确认了“scaling_target_value”、“scale_in_threshold”,并且已部署的可扩展目标上的两个冷却时间都与派生的“plan”相匹配。任何不匹配都意味着部署的策略和测量的计划已经偏离,应该在依赖端点的自动扩展行为之前解决。
测试和验证
本文中引用的每个“qmax”、“ttotal”和“plan”工件都是存储库中的已提交文件,而不是一次性的本地输出。通过针对两个提交的测量文件重新运行“计划”,可以独立重现前面的工作示例(包括每个数字),并且 AWS 调用为零,新支出为零:
$ uv run tts-bench plan --qmax
清理
要删除本演练中创建的资源,请使用单个命令以相反的顺序拆除堆栈:
uv run speech-infra destroy kokoro-82m
speech-infra destroy 会删除 Amazon SageMaker AI 模型、终端节点配置、终端节点以及附加到其上的任何自动扩展或 Amazon CloudWatch 资源。它不会清空缓存模型权重的 Amazon S3 存储桶,也不会删除保存容器映像的 Amazon ECR 存储库,因为两者都可以跨模型共享。如果您不再需要它们,请清空并删除 Amazon S3 存储桶,并手动删除 Amazon ECR 存储库,因为存储的模型检查点和容器映像在删除之前会继续产生少量存储费用。
结论
将 Kokoro-82M 作为 Amazon SageMaker AI 实时终端节点上的自定义容器部署,并用针对实时终端节点进行的两项测量来取代猜测:“Q_max”(一个实例在违反 SLO 之前维持的最高并发数)和“T_total”(真正横向扩展需要多长时间)。您可以通过算术从这两个数字得出扩展阈值、缩减阈值以及两个冷却时间。在 AWS 发布的原生指标“ConcurrentRequestsPerModel”上进行扩展,并直接测量其单位转换而不是假设它,是使此配置与实际并发性保持联系的原因。
结果是一个自动扩展策略,其中每个数字都可以追溯到针对您自己的端点的实际测量,而不是从不同的工作负载形状继承的假设。这种区别使得配置文件的猜测(默默地超额支付或默默地违反其 SLO)转变为一种策略,您可以通过特定的并发上限和特定的横向扩展时间(两者都是测量的,而不是断言的)来捍卫。
这个四数模型、选择的 SLO 和浪涌比、测量的“Q_max”和“T_total”以及导出的其余部分都不是特定于 TTS 的。它适用于延迟敏感、并发限制的实时 Amazon SageMaker AI 终端节点。例如,通过 GPU 前向传递保持每个请求打开的实时图像嵌入端点受相同并发上限的约束,而不是受吞吐量指标的约束。相同的 qmax/ttotal/plan 链不变。真正的瓶颈是并发的正在进行的请求,而不是从不同工作负载形状借用的吞吐量指标。这里的具体数字“Q_max=50”和“T_total=320s”对于“ml.g5.xlarge”上的 Kokoro-82M 来说是正确的。对于不同的模型或实例类型,它们会有所不同。产生它们的方法和工具却没有。包含五个命令的工具链“drift”、“qmax”、“ttotal”、“plan”和“validate”将不加更改地延续到您以此方式部署的下一个模型。
克隆示例存储库,然后针对您自己的端点运行五个命令链“drift”、“qmax”、“ttotal”、“plan”和“validate”以生成测量策略。查看 Amazon SageMaker AI 自动扩展文档 以根据您的 SLO 调整阈值,并打开 SageMaker AI 控制台以观察策略对实时流量的反应。如果您需要帮助构建类似的测量驱动部署,请联系您的 AWS 客户团队。
关于作者