在线AI教程 / AI部署
[Amazon Bedrock] 宣布使用 SageMaker AI 自定义模型的新方法,无需管理 GPU
人工智能 宣布使用 SageMaker AI 自定义模型的新方法,无需管理 GPU 从人工智能中获得实际成果的公司不仅仅使用现成的基础模型 FM 。他们使用强化学习等训练后技术来定
人工智能
宣布使用 SageMaker AI 自定义模型的新方法,无需管理 GPU
从人工智能中获得实际成果的公司不仅仅使用现成的基础模型 (FM)。他们使用强化学习等训练后技术来定制开放权重模型。根据您的业务背景、产品目录或临床词汇进行训练的模型将更准确地完成您的任务,并且运行成本更低。当您构建代理时,您的数据、工作流程、评估和成功标准也会影响模型的行为方式。
然而,模型定制是困难的。您必须选择正确的技术,设置和管理 GPU 基础设施,并为代理构建多轮强化学习的环境。我们推出了 Amazon SageMaker AI 无服务器模型定制来解决这些挑战,今天,我们通过全面推出培训课程来扩展它。
通过培训课程,您可以控制培训后逻辑,而无需管理底层基础设施。您编写并协调训练循环,包括自定义损失函数或奖励信号。 SageMaker AI 处理 GPU 分配、分布式执行、故障恢复和检查点存储。
定制,免去基础设施管理的麻烦
通过 SageMaker AI 无服务器模型自定义,您无需选择实例类型、管理集群或编写分布式训练配置。
我们不想限制你。您可以使用 SFT、DPO、RLVR、RLAIF 或多轮 RL 等技术。您可以选择使用低秩适应 (LoRA) 或完全微调以及通过持续定制将技术链接在一起来更新模型的多少。
我们不想让你浪费时间。我们的 SageMaker AI 培训课程手册提供了示例和用例,以及模型定制代理技能。您描述您的用例,代理处理数据准备、技术选择、培训、评估和部署。代理在您工作的地方工作,例如 SageMaker Studio、Kiro、Claude Code、Codex 或 GitHub Copilot。
“我们采用 SageMaker AI 无服务器培训课程来构建医疗保健索赔拒绝分类模型,这些经验从第一天起就验证了该平台。低级 API 界面、对前向和后向传递、采样和优化器步骤的直接控制为我们的科学家提供了在要求严格、准确性关键的用例上进行强化学习所需的细粒度控制。培训课程为我们提供了正确的原语,以推动生产级性能。” — Rob Gontarek,ImagineSoftware 数据科学高级副总裁
编写你自己的训练后循环
智能体训练的一个重要转变是转向多轮强化学习。例如,预订旅行、分类支持票或运行多步骤研究任务的代理需要进行几轮交互,然后才能判断它是否达到了正确的结果。
然而,训练循环很快就会变得复杂。您可以在一组基础设施上训练模型,在另一组基础设施上运行推理以生成响应,对这些响应进行评分,并将结果输入到下一次更新中。每个阶段都需要不同的计算,跨不同的工具和集群连接它们会增加工作量。
SageMaker AI 已经提供多轮强化学习作为一种托管的无服务器技术。但我们收到客户的反馈,他们希望在一个循环中定义自己的损失函数、形成奖励信号或 RL 阶段。培训课程为您提供了这种灵活性。
“通过 SageMaker AI 无服务器培训课程,我们对 gpt-oss-20b 进行了微调,使其能够调用我们的 Amazon Neptune 知识图谱,以实现代理式多轮工具,并且该平台为我们处理了基础设施。设置就可以正常工作,无需手动调整,也不会出现内存不足的问题。检查点和恢复功能非常出色:从精确的步骤恢复完全可靠。它为我们的开发人员提供了他们想要的灵活性,同时减轻了他们的操作负担。” — Karini AI 首席执行官 Nitin Wagh
它是如何工作的
您的代码在您的环境中运行训练循环和奖励函数,并将代理连接到其工具或模拟器。训练会话执行 GPU 密集型工作:采样器生成响应,训练器计算梯度并更新模型权重。确切的顺序取决于您编写的算法。
例如,让我们看看组相对策略优化 (GRPO) 的实现。 GRPO 是一种强化学习方法,它可以针对同一提示生成多个响应,对它们进行评分,并使用它们的相对表现来更新模型。一次循环的工作方式如下:
示例响应 – 您的循环要求采样器使用当前模型为每个提示生成多个响应。 对它们进行评分 – 您的奖励函数使用验证器、奖励模型或测试工具对环境中的每个响应进行评分。 更新模型 – 您的循环将分数发送回训练器。 forward_backward() 使用它们来计算梯度,而 optim_step() 将更新应用于模型权重。 刷新并重复 – 您的循环要求会话使用更新的权重刷新采样器,然后开始下一批。您的代码会重复这些步骤,直到训练完成。
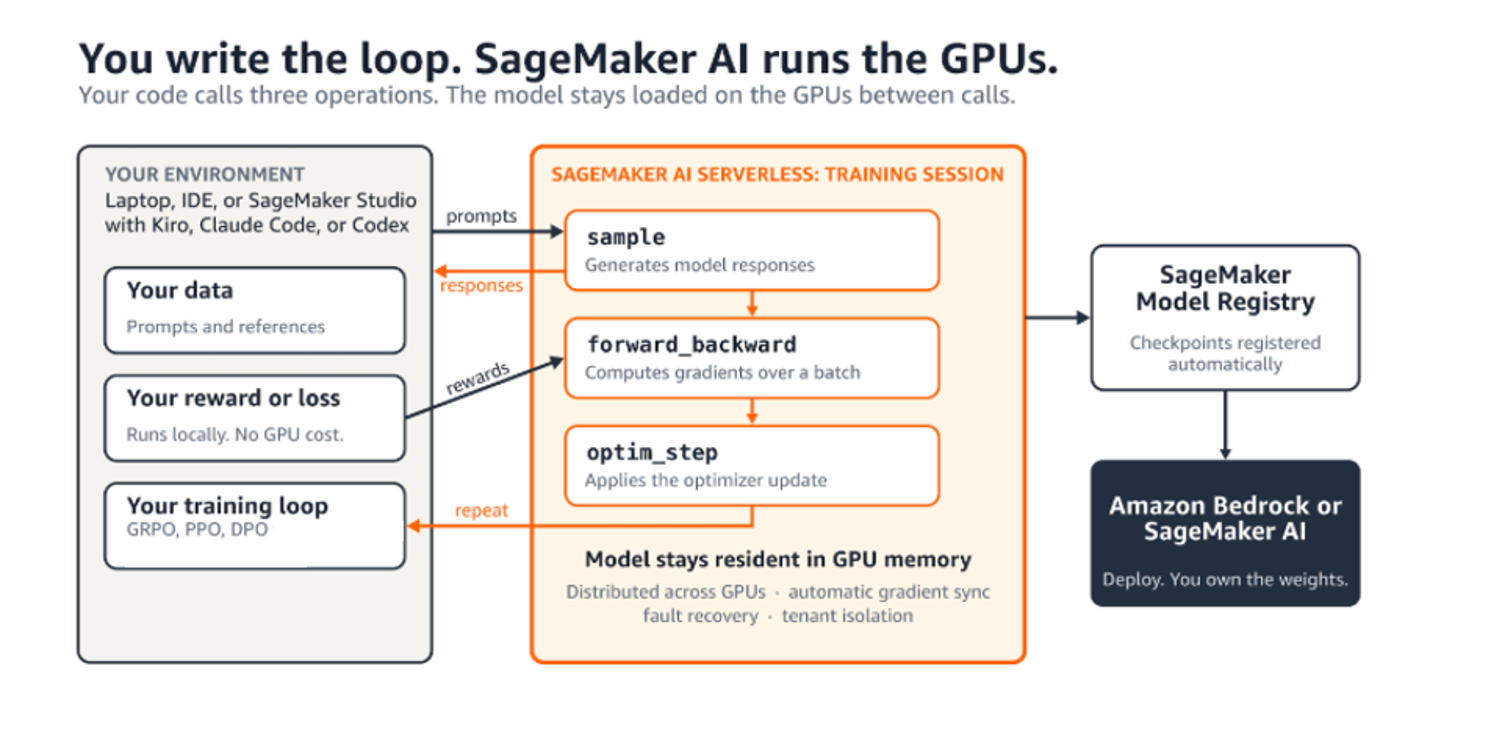
您需要为 SageMaker AI 流程的代币付费。当您的奖励函数在您的环境中对批次进行评分并且没有容量可预订时,计量器就会停止。
控制您的数据和模型
每个会话都使用您创建的 AWS Identity and Access Management (IAM) 执行角色,并且您可以添加自己的 AWS Key Management Service (AWS KMS) 密钥和 Virtual Private Cloud (VPC) 配置。您的数据保留在您选择的 AWS 区域中您自己的 Amazon Simple Storage Service (Amazon S3) 存储桶中,您的检查点也放置在那里。
我们不会使用您的数据或您的自定义权重来训练另一个模型。在部署之前,您可以评估模型的准确性、偏差和安全性。部署后,您可以应用护栏并使用 Amazon CloudWatch 进行监控。
您可以继续使用团队已有的治理流程。
今天开始
在 SageMaker AI 无服务器模型自定义培训课程上编写您自己的培训循环,该培训课程现已推出,支持“gpt-oss-20b”、“gemma-4-31B-it”、“Qwen3.6-27B”和“Qwen3.8-27B”。
两种入门方法:
在您的 IDE 中: 安装 SageMaker Python SDK(在使用 Python 3.10 至 3.12 的 Linux 或 macOS 上),克隆说明书,然后开始开发。 在 SageMaker Studio 中: 在 20 秒内启动即用型 AI 开发环境。登录,打开笔记本,连接您的编码代理(Kiro、Claude Code、Codex 或 Copilot),下载代理技能和食谱,然后就可以开始了。
资源
阅读完整的技术文章
培训课程示例
培训课程文档
培训课程食谱
关于作者