在线AI教程 / AI部署
[Anthropic Claude] 构建 agent:何时把子 agent 折进主 agent 循环
构建 agent:何时把子 agent 折进主 agent 循环 如果你在 Claude Platform 上构建的 agent 里包含多个 subagent,可以看看其中哪些适合
构建 agent:何时把子 agent 折进主 agent 循环
如果你在 Claude Platform 上构建的 agent 里包含多个 subagent,可以看看其中哪些适合用我们的迁移套件折进主 agent 循环。它会跑一套引导式工作流,识别你的模式、评估备选方案,并验证最佳做法。里面包含一个 demo,你可以先在模拟系统上试,再用到自己的 agent 上。
Subagents——由一个协调者编排、拥有自己的 context window、工具和指令的 agent——是 agent 设计的核心组件。它们在验证、并行工作和模块化权限管理上很有效。我们自己用 Claude Platform 构建的许多 agent 也在用它们,例如我们的多 agent 研究系统。
不过最近,Applied AI 团队发现这样一个模式:一些企业 agent 部署把 router、planner 和领域 subagent 折进主 agent 循环之后反而受益。在我们跨多个企业部署所做的对比中,一个带 skills 的单个 agent 在质量上常常既胜过「一条 prompt 应对一切」的设计,也胜过 subagent 设计,而且每个任务的成本和延迟往往更低。
例如,有一家企业发现,它面向客户的那个 agent 里的十几个专精 subagent 让一致的品牌体验难以维持,还增加了伤害用户体验的延迟。
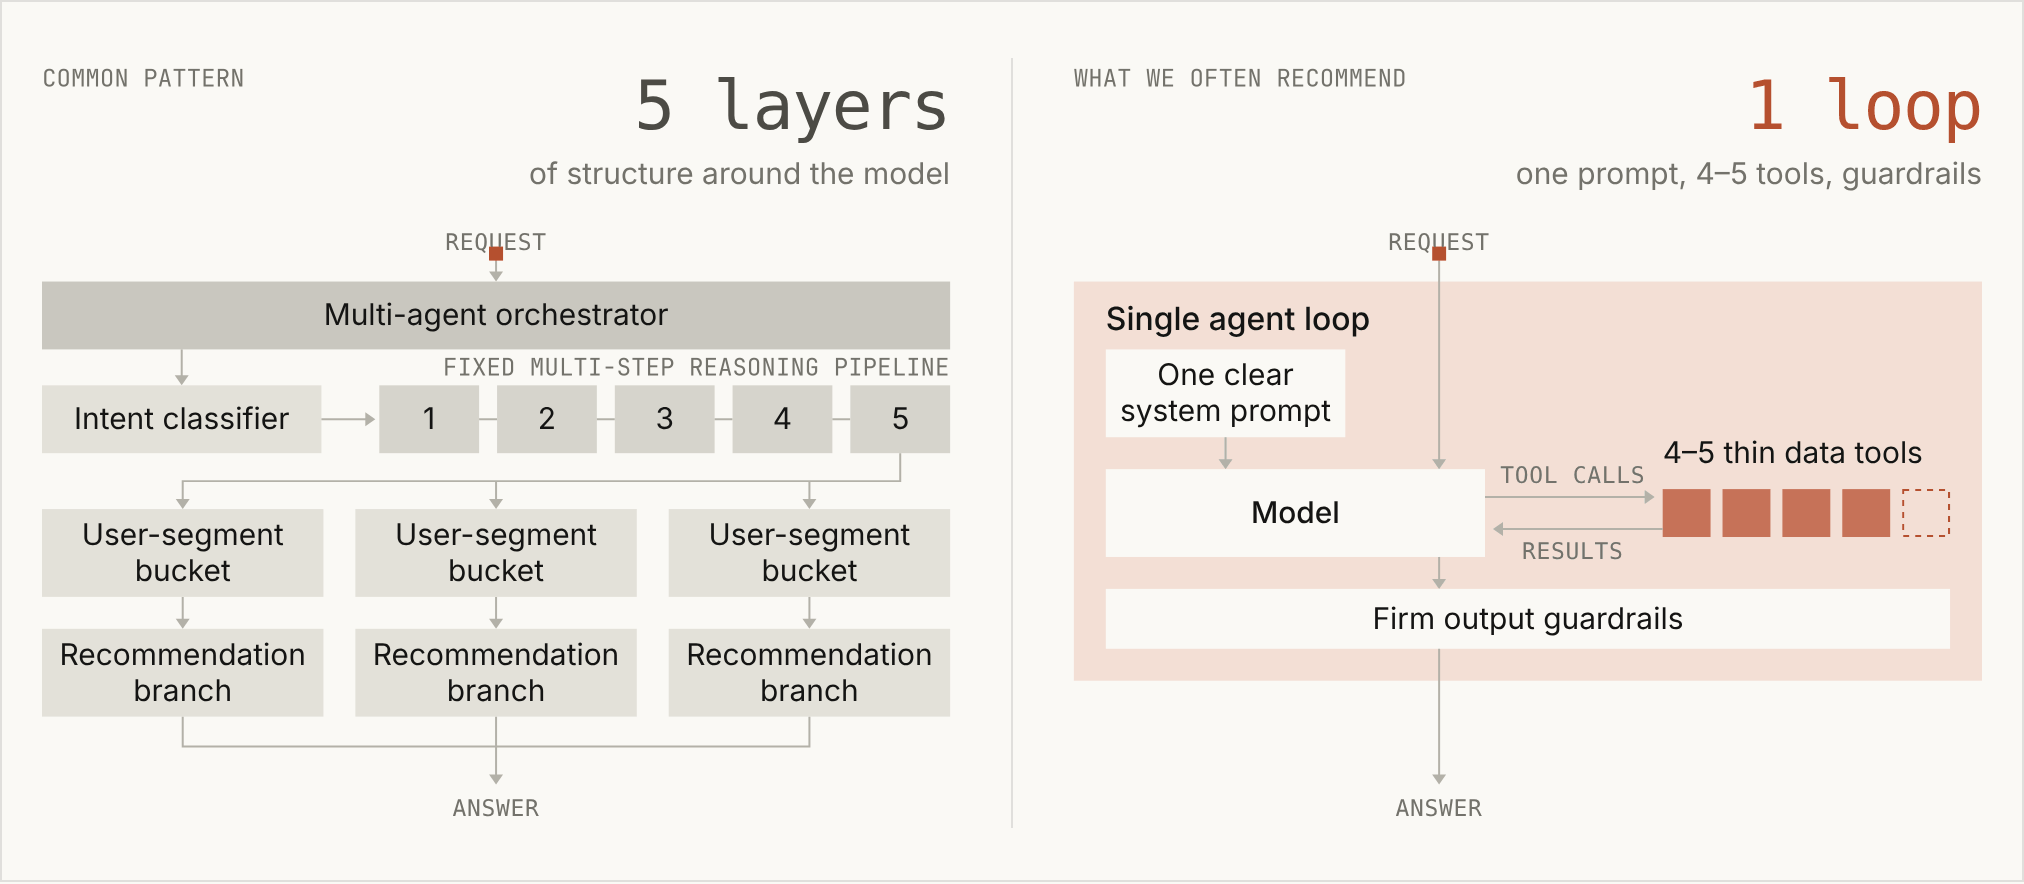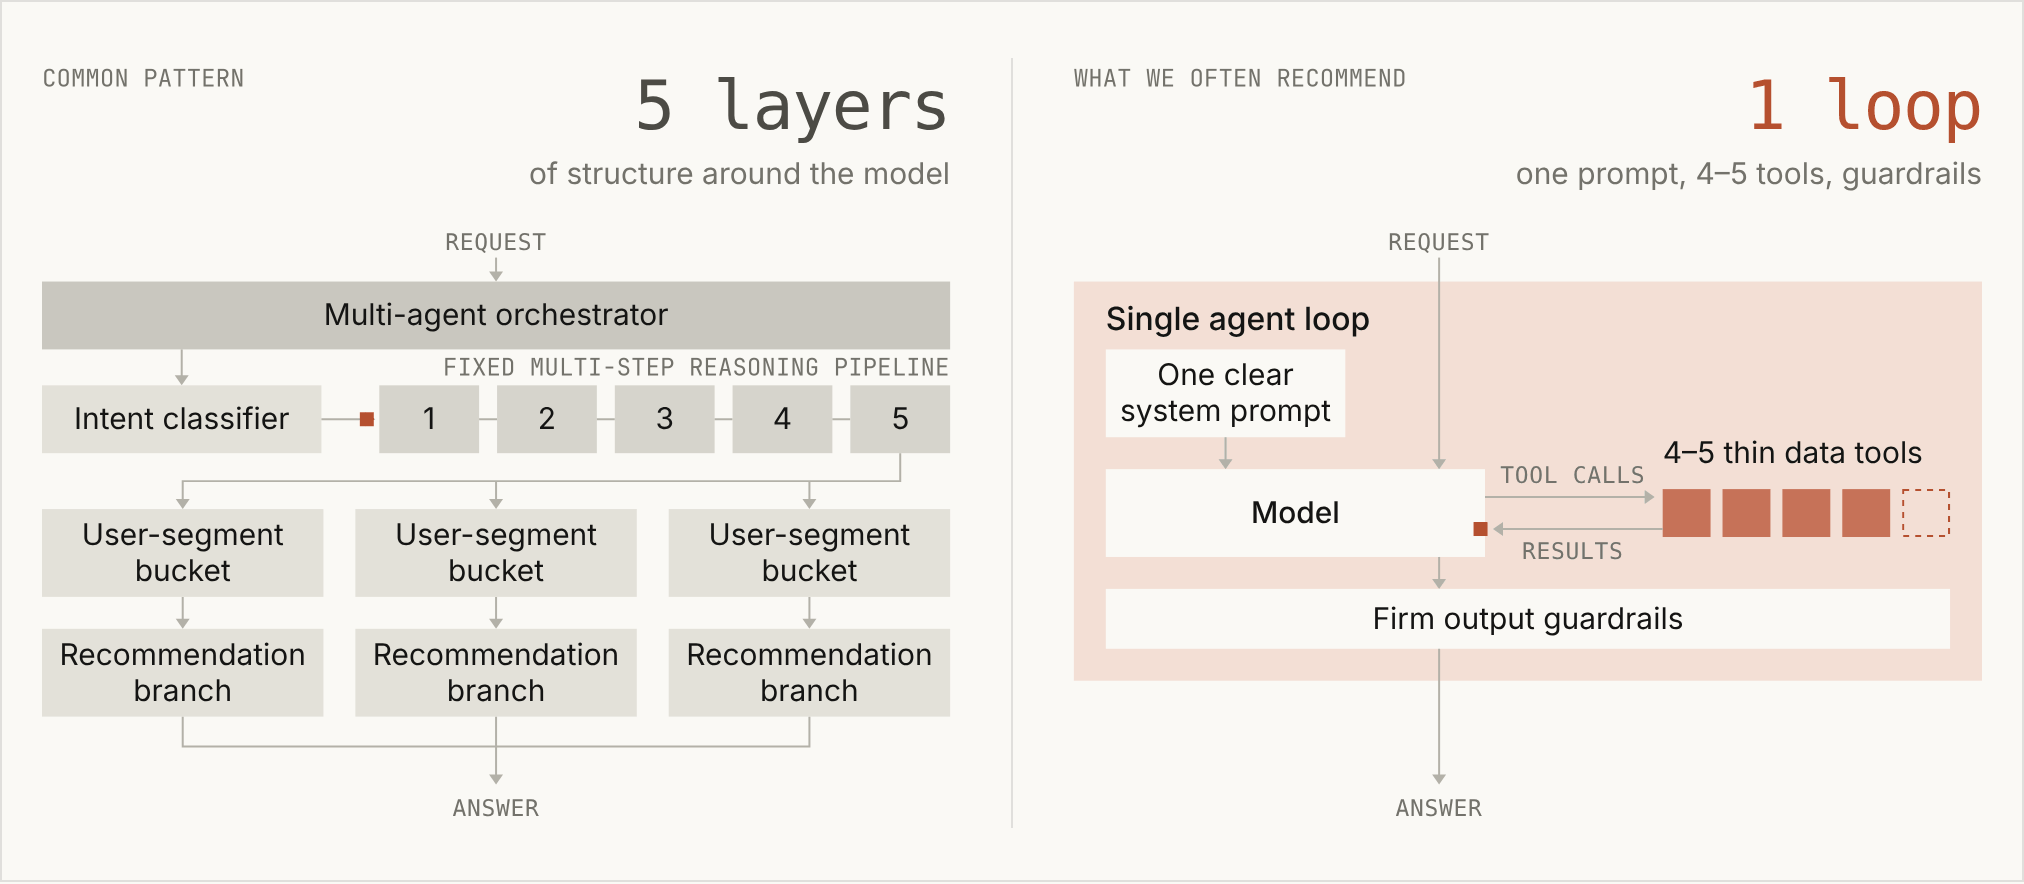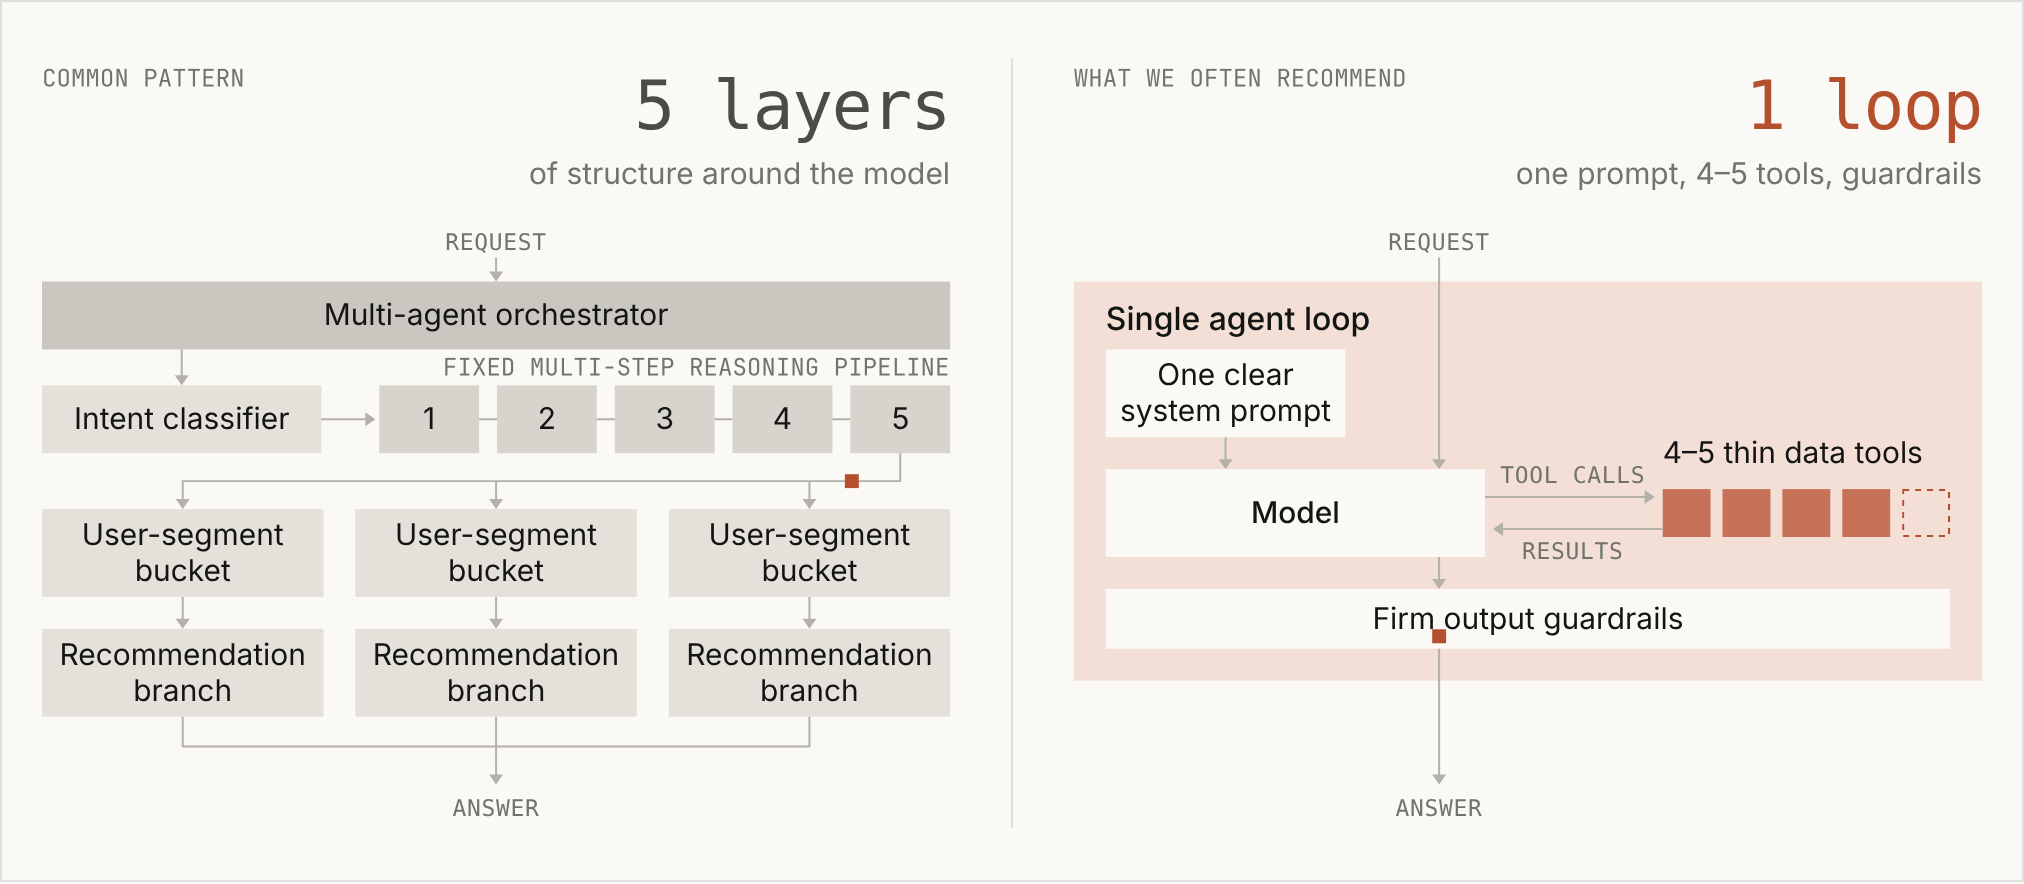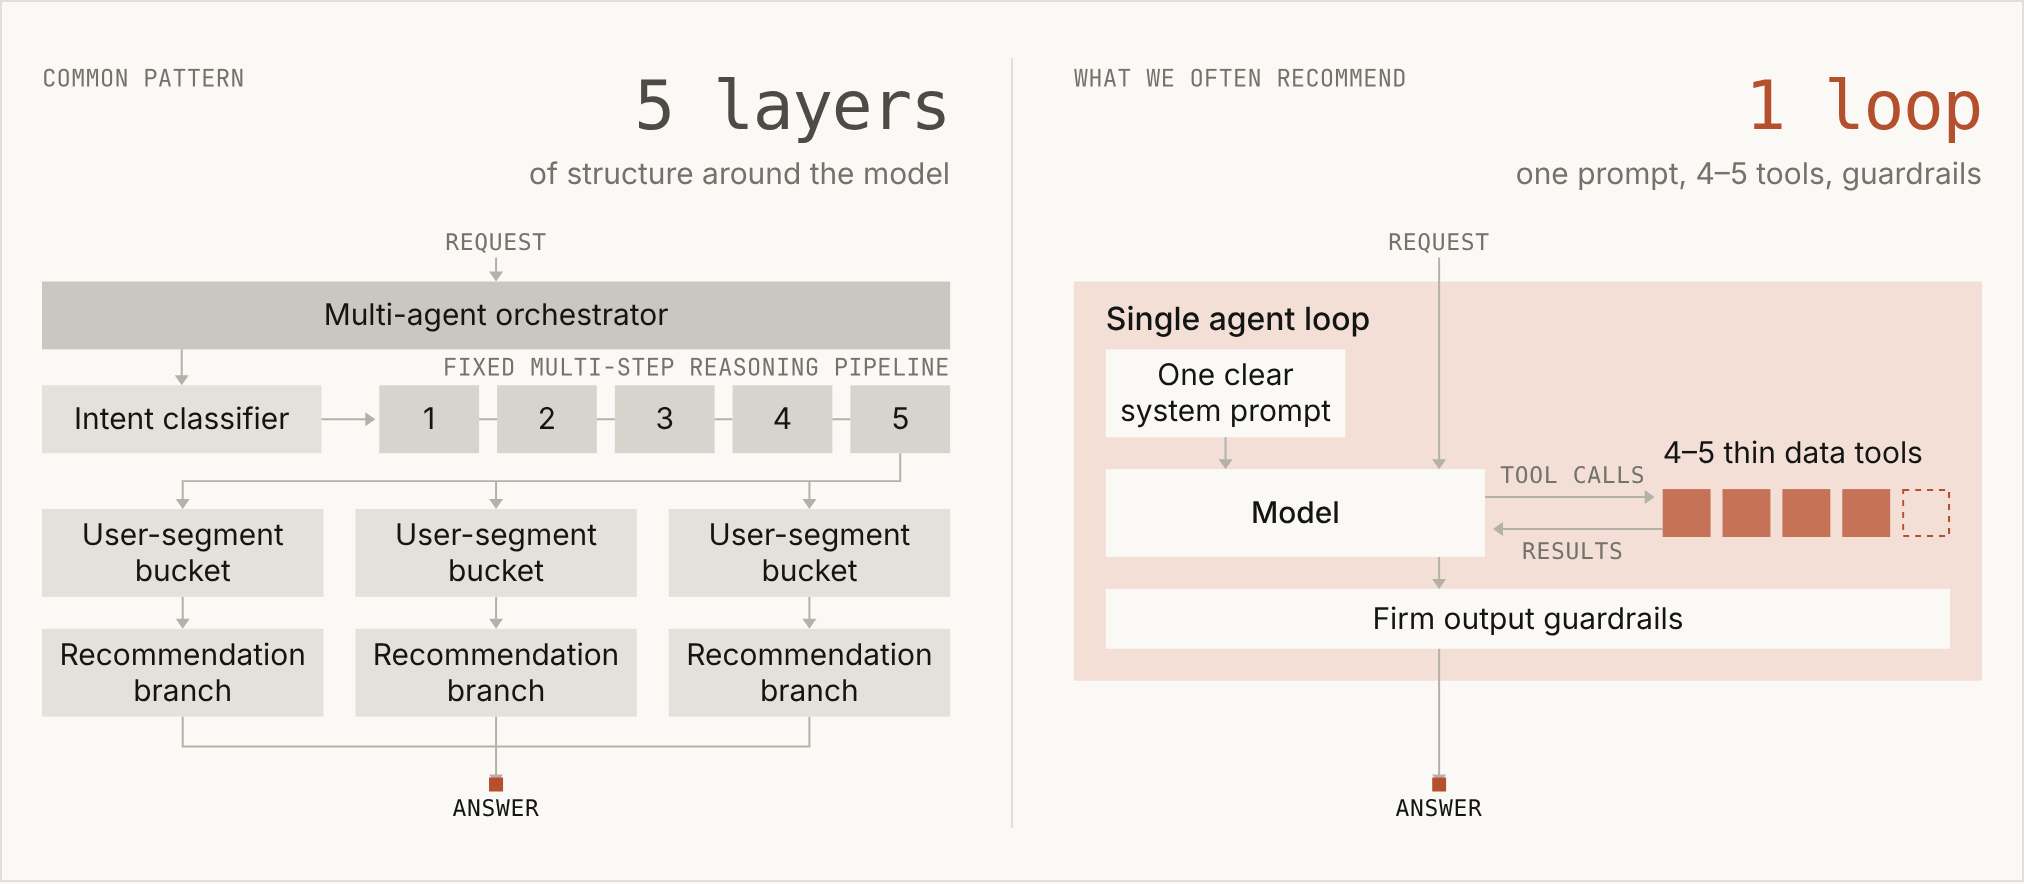
我们也常常看到这样的 agent 设计方案,遵循一条熟悉的路径:一个意图分类器、一条固定的多步推理流水线、按用户分层的分桶、各自独立的推荐分支,最上面再套一个多 agent orchestrator。
在这些案例里,得到的反馈往往是:这套结构的大部分东西在做模型已经不再需要别人替它做的活儿,而一条清晰的 system prompt、4-5 个轻薄的 data 工具、加上严格的输出护栏,就能覆盖绝大部分用例。
需要说清楚的是,subagents 依然有它们的位置,包括在研究前沿。在下列情况下使用它们:
单个 agent loop 因为 context 膨胀出现可衡量的性能下降,或 需要并行处理多个任务,且每个任务能配上全新的 context window、任务做完即可丢弃,或 单个 agent 难以挑选合适的工具,或者 system prompt 里存在相互冲突的指令。
但更常见的情况是,企业给每个团队或每类问题都配一个自己的 subagent,于是 agent 架构变成了它们组织架构图的翻版(Conway 定律在起作用)。
本文讲解何时该考虑把 subagents 折进你的主 agent 循环,并分享我们在大型组织里构建 agent 学到的最佳实践。
大型组织构建 agent 的失败模式
企业往往想构建一个 agent,把多个产品和能力统一到同一个面向客户的界面里。
通常每块能力由不同的团队负责,所以公司的做法是先让各个团队分别构建自己的 agent,再由一个中心平台团队在上面搭一个 orchestrator。这可以呈现好几种结构,包括 orchestrator-subagent,或者一个单 agent 把若干专门的 agent 作为 MCP 工具暴露出去。
这看起来是最简单的解法,但会立刻在以下方面引入复杂度:
上下文管理: 你得决定 agent 之间交换哪些 context,而细节往往在来回传递中丢失。 Subagent 蔓延:每个团队都上线自己的 subagent,结果公司手上握着成百上千个互相重叠的 subagent,既没有强制执行的标准,也没有明确的负责人。 Frankenprompt:每个团队都往 system prompt 里加一句话,最终规则互相冲突、语气也无法统一。 未经审查、过度局部的 evals:每个人都加上自己的 evals,而这些 evals 过度针对自己的子任务优化。没有人拥有和维护整套 evals,管理层只能基于被稀释过的、过度局部的分数做决策。 延迟:多 agent 架构的复杂度会增加延迟。有一家企业把自己的 multi-agent harness 与单个 agent loop 做了对比评估,发现后者的运行时间快了约 2x。
使用带渐进式披露的 agent loop
上面描述的 orchestrator-subagent 设计,是协调跨团队构建的专精 agent 的一种合理做法,但往往有更有效的路径:通过 skills 渐进式披露 context,以及通过 tool search 渐进式披露工具。换句话说,agent 只看到 skills 和工具的简短描述,真正需要时才完整加载。
这种方式说得通,有三个原因:
共享 context 产出更好的答案:对于运行时间更长的 agents,我们希望来自多个不同任务的 context 都留在主 context window 里。一个看得到每一步早期结果的 agent 能把它们串联起来,比起 subagents 交回的一堆摘要,产出更丰富的输出和更好的洞察。这也意味着更少的 context window 和更少的有损交接。 渐进式披露避免 context 膨胀:这个技术让团队能够构建单个 agent,完成非常多样的任务,而不必把所有 context 立刻装进一条超长 system prompt。这就移除了过去团队把工作拆给 subagents 的主要理由。事实上,我们把 Claude Code 面向更高级模型的 system prompt 削减了 80% 以上,其中就包括与渐进式披露 skills 和工具相关的削减。 模型更能干了:从 Opus 4.5 开始,模型在单个 loop 里能管理的东西远超多数团队的预期。Opus 5.5 和 Fable 5.1 你没法关掉 thinking,而近几代模型越来越会一边干活一边叙述进展、检查自己的工作,这让 harness 里的一些组件变得多余。每一代新模型都能让你把更多决策从 harness 移进模型本身。更简单的 loop 也更便于迁移到下一代模型;在我们协助客户完成的迁移中,往往是那些僵硬的多 agent 结构挡住了新模型、让它做不了更多工作。
单个 agent loop 的设计需要纪律:精心维护的 system prompt、能在正确时机触发的 skill 与工具描述,以及对 context window、memory 和记笔记的刻意处理。本文后面的小节会更深入地讲迁移与设计的考量。
应当由一个中心团队端到端地负责质量与 system prompt,每个新工具和每个 eval 上线前都要过审。把这个中心团队保持得小一些,有助于迭代快速推进,也能降低大组织里的协调成本。
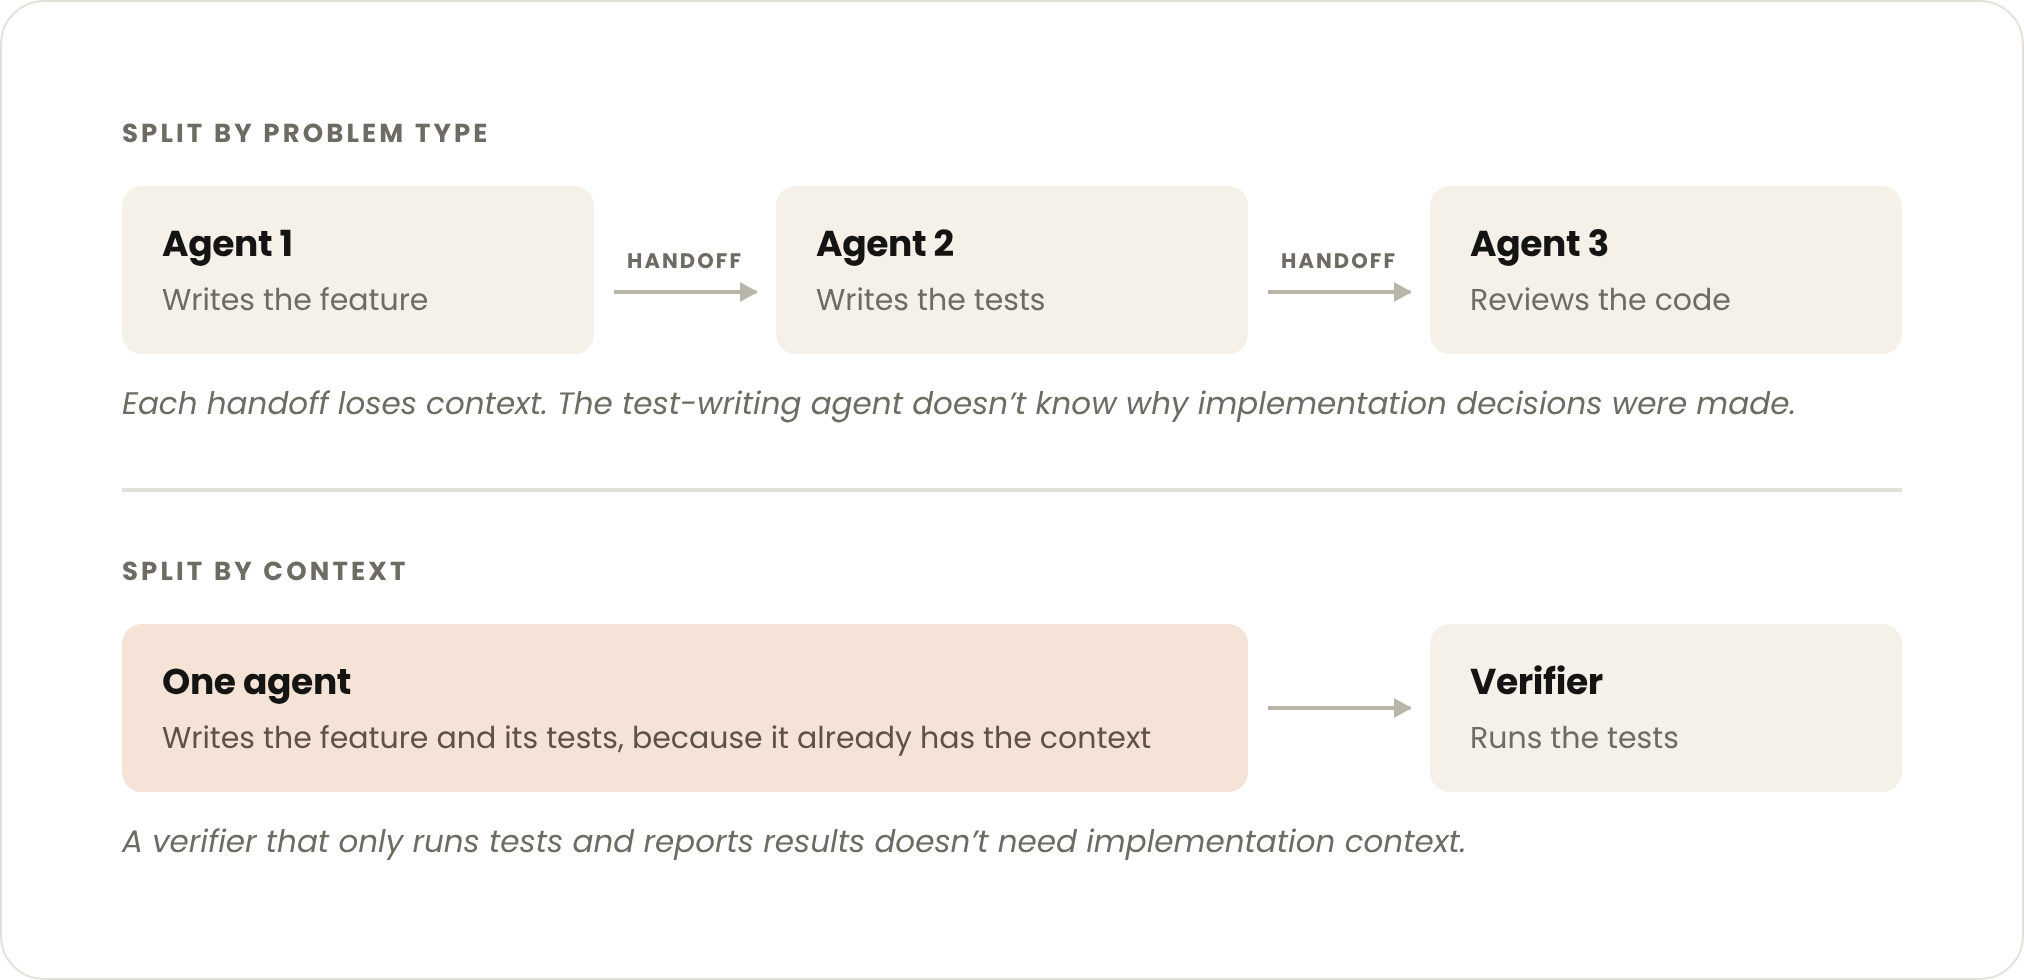
如果你走多 agent 路线,就从能跑通的最简单模式开始(generator-verifier、orchestrator-subagent 或其他)。要有效地划分边界,就按 context 切分:给每个 subagent 一块几乎不依赖系统其余部分的工作,并让它交回一个紧凑的结果(合适的候选是彼此独立的研究路径、接口干净的独立组件,或黑盒验证)。当 agents 按问题类型被切开时,它们就玩起了「传话筒游戏」,信息来回传递,每一次交接都在损耗保真度。
如何把 subagents 折进主 agent 循环
许多团队在生产环境里已经有一套 orchestrator 和一组专精 agents。下面是我们建议逐步收敛到的单循环设计:
一个模型、一个 context window,跑一个开放式的工具循环,循环的限制(轮次与成本预算、写入闸门)设在 harness 里。 每一轮,模型发出一批 tool calls。harness 并行执行它们,把原始结果返回给同一个模型,由模型决定下一步:再来一批、向用户提一个问题,还是给出答案。 当模型给出答案或触及 budget 上限时,循环停止。答案给出之后,可以选择再跑一次目标检查或 verifier 检查。 模型在第一轮就把它的计划写在 context 里,并随着结果到达不断修订。这正是与「orchestrator 加专精 agents」配置最关键的差别:写计划的模型同时也是执行计划的模型,所以它能在轮次中间改计划。 Context 仍然会被加载,并由 agent 自己管理:从规则目录重写计划的代码步骤不再需要,因为模型自己决定每一步。顺序编排与领域流程移入 skills。硬性限制(校验、审批闸门)以及对话中途出现的其他事情(例如 memory 检索)移入 tools。代码仍然可以用来加载那些成本低、且几乎总是相关的内容(例如实体解析步骤),以及在循环所调用的 tools 内部处理任何机械环节(payload 构造、stream 解析、恢复一次澄清)。
这种单循环设计也有助于许多团队正在追求的最终形态(一个理解用户高层目标、并代表用户行动的 agent),因为它把 agent 学到的一切都留在同一个 context 里。
下面的建议讲的是:一个团队如何分阶段从多 agent 系统走到单个 agent loop,以及多个团队如何在这个过程中持续为这个 agent 做贡献。
Task-completion evals
第一步是创建一套 eval,帮你判断该不该把某个 subagent 折进主 agent 循环。我们见过行之有效的 eval 结构是:一套由中心团队拥有的共享端到端 eval 集,加上每个团队随自己的 skill 一起交付的更小规模 eval 集。哪怕只有 10 个 golden 样例,也足够起步。
按 rubric 给 agent 的最终消息打分,是跟踪答案质量的好起点。在你还保留 orchestrator 时,还应该跟踪路由准确率(它有没有挑对 subagent?)。一旦某个 subagent 被折进来,就改为检查 agent 有没有加载正确的 skill、有没有调用正确的工具。逐步朝 task-completion evals 努力是有帮助的,因为比较架构时最看重的就是这个。
在内部系统难以回放、用户互动难以模拟的环境里,这件事会很复杂。我们在内部行之有效的一种做法是:给重要事件记录时间戳,之后可以回放它们,作为有针对性的 evals 来跑。
随时间减少 subagents
向单个 agent loop 演进,意味着把 subagents 折进 tools 和 skills。做法可以是合并领域 subagents、把它们当作工具调用,或者用 skills 和 tools 替代它们。
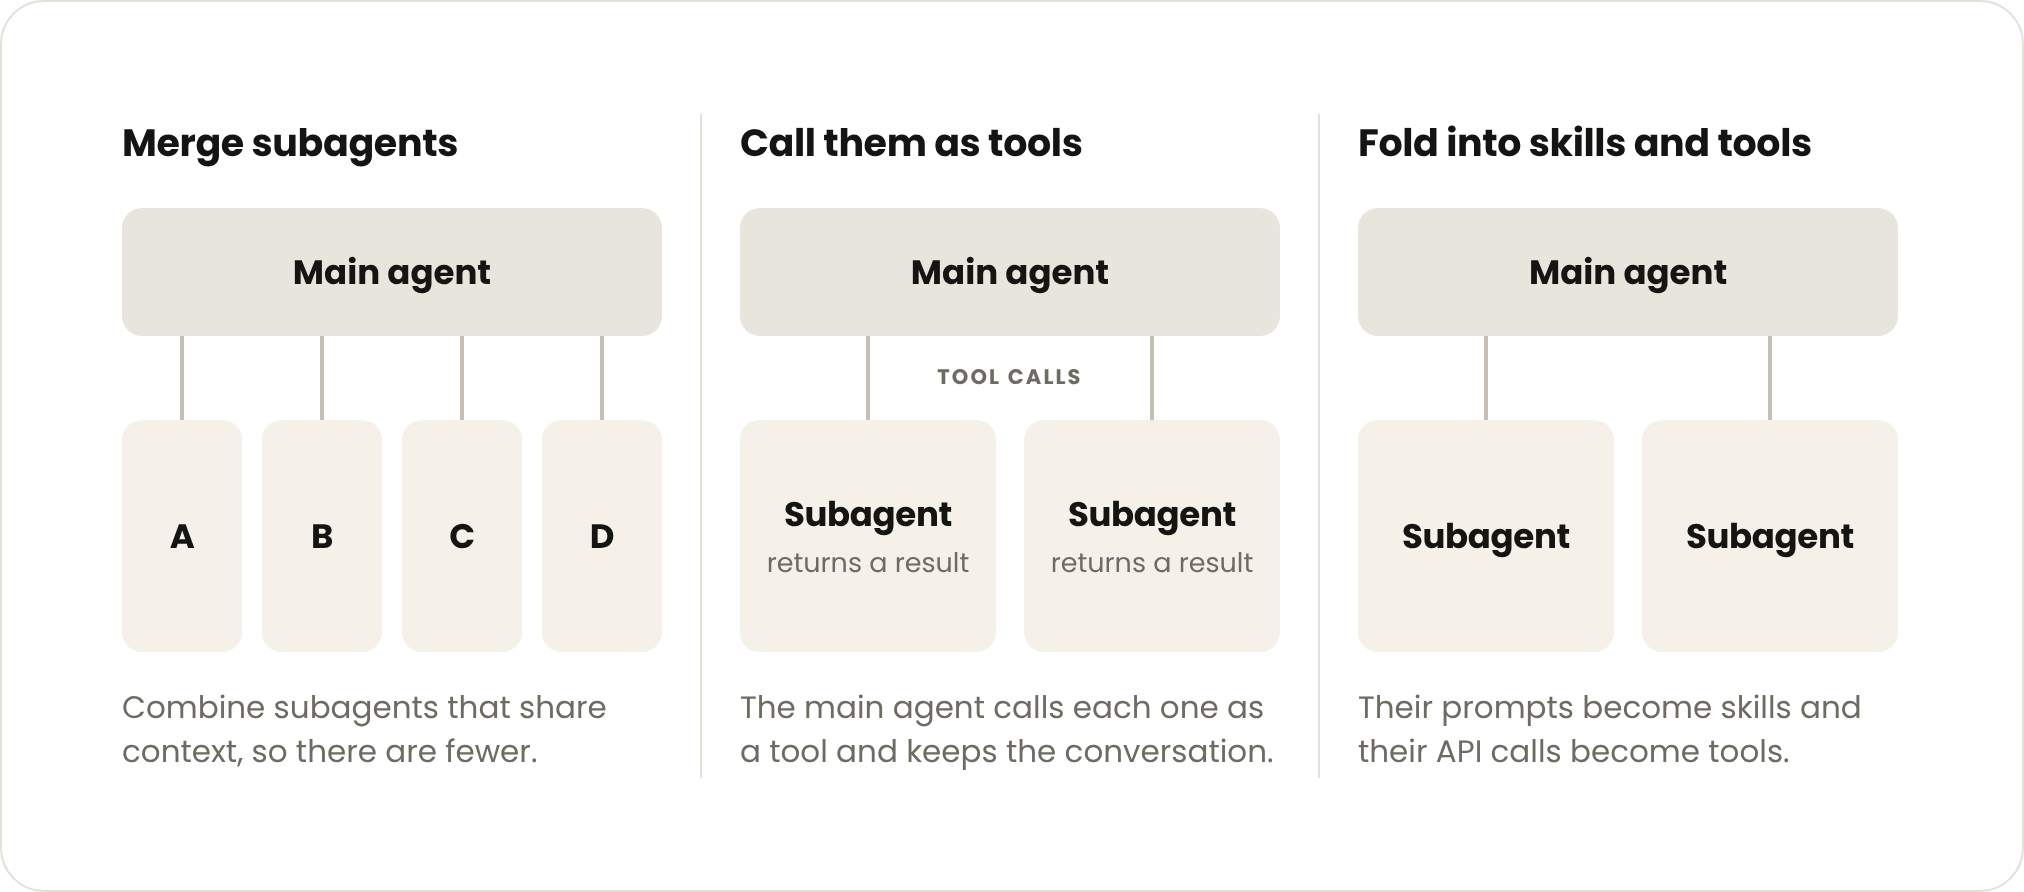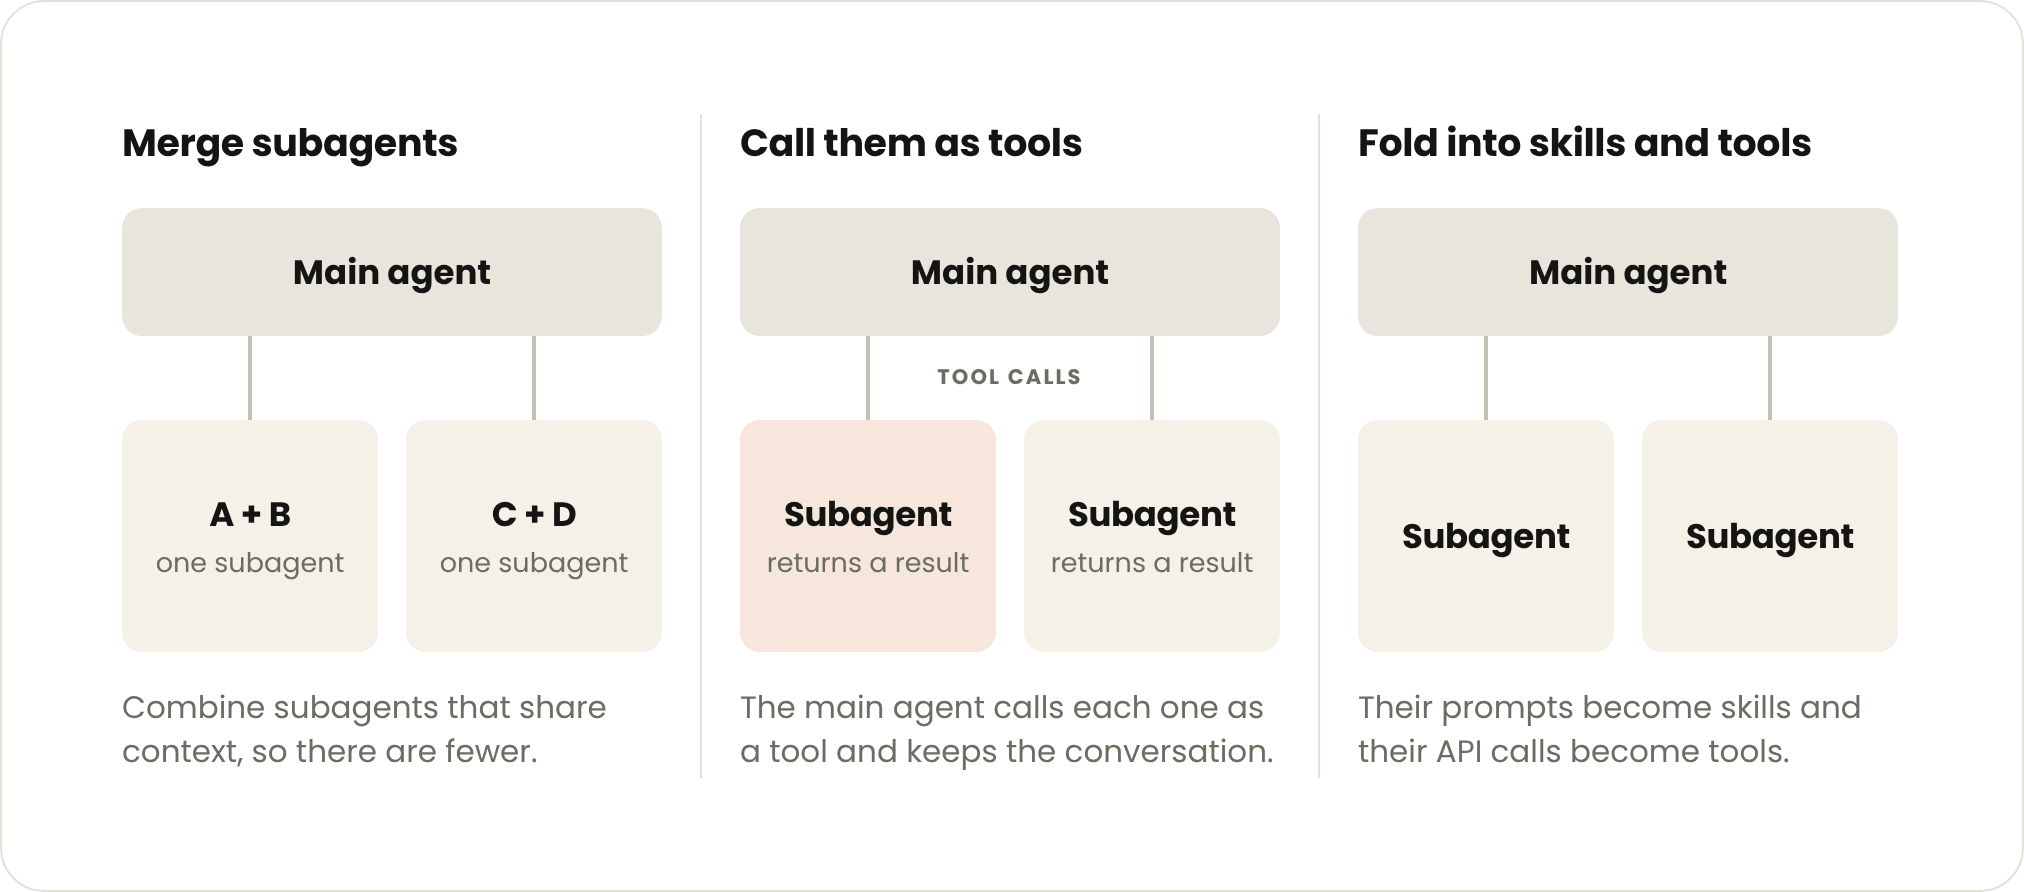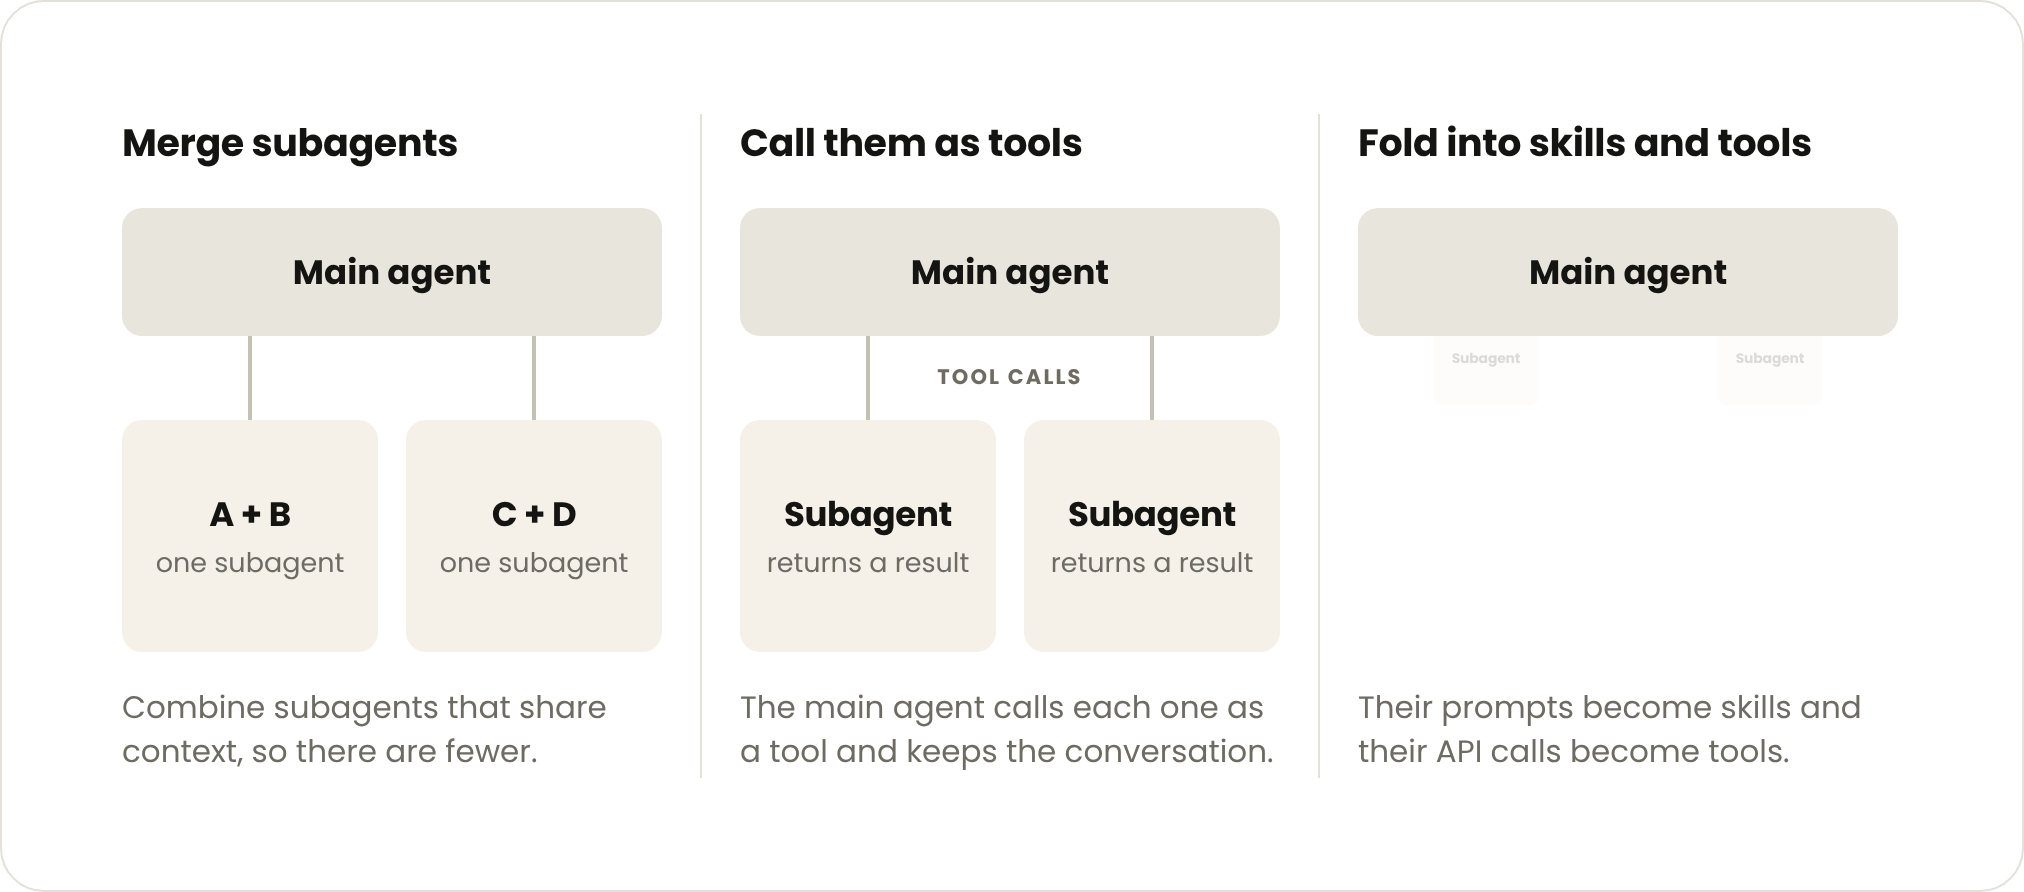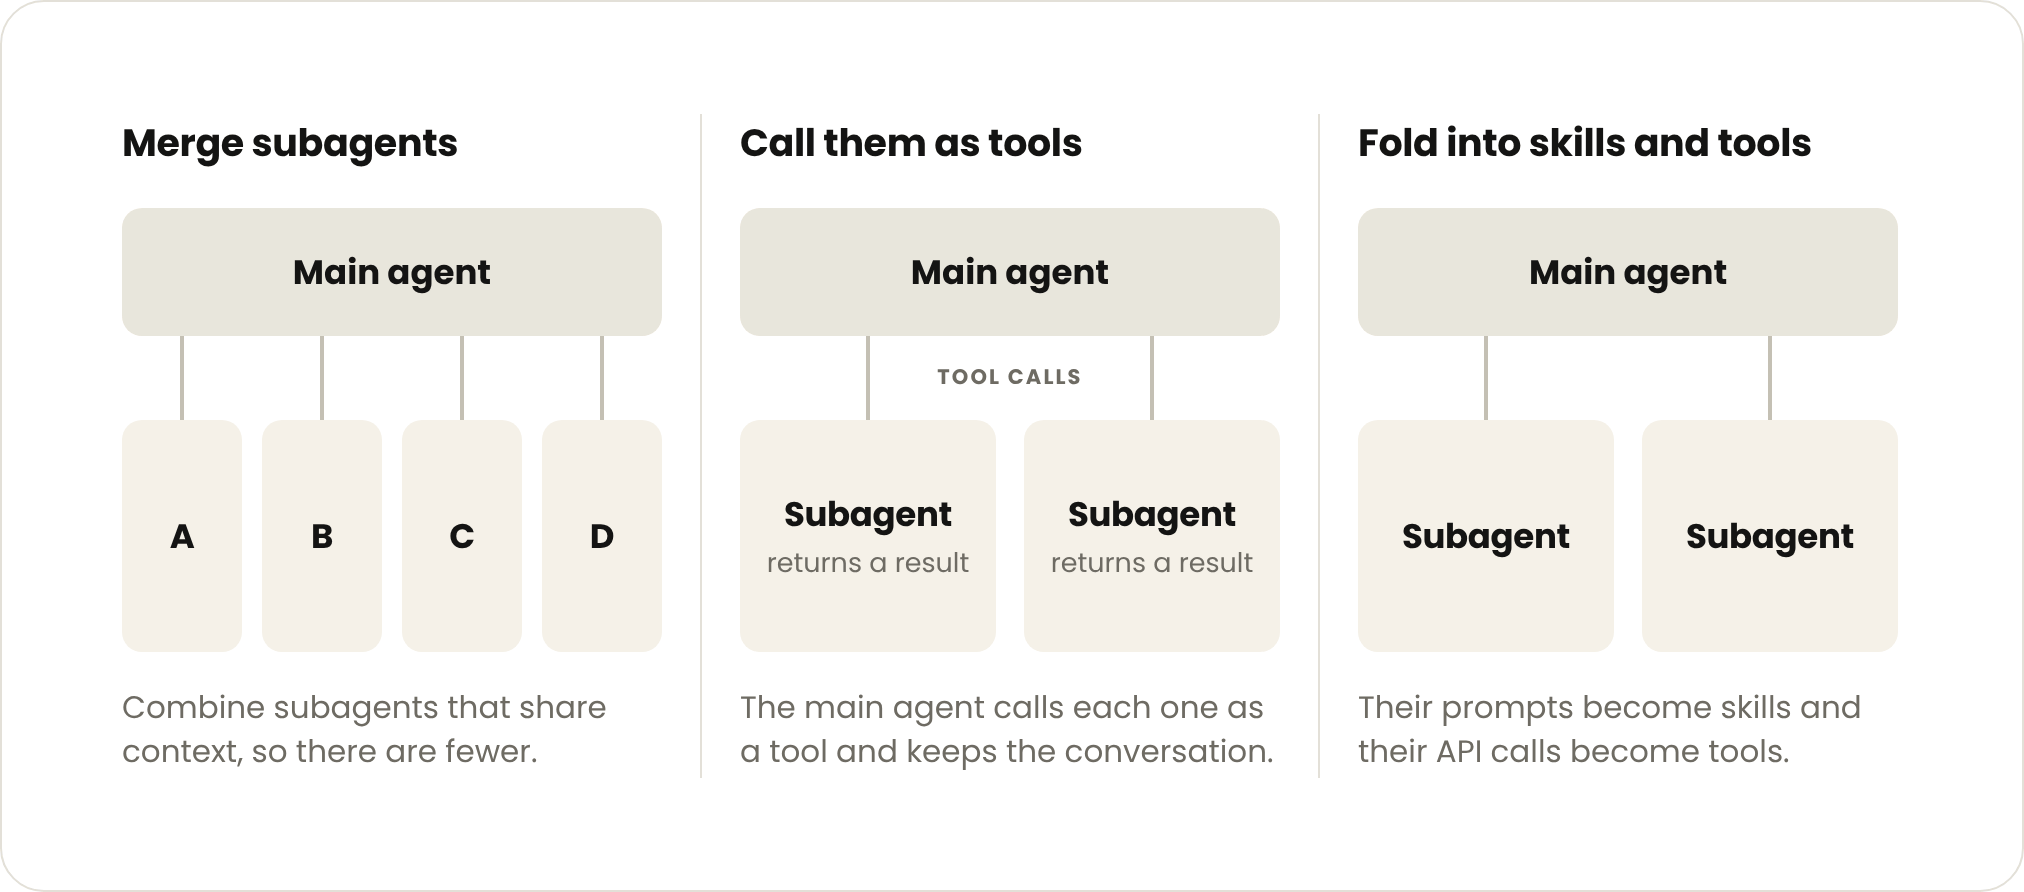
合并领域 agents
在第一次合并之前,先搭一个小型端到端 eval。然后按共享 context 折进,从使用量最大的 subagents 开始。
合并那些专精 agents,尤其是彼此接力输出、触碰同一份数据、或经常被一起调用的。例如,如果生产流量中有相当大的一部分是「一个专精 agent 后面紧跟第二个」,那它们就是紧耦合的一对,可以合并成一个领域 agent。
把 subagents 当作 tools 调用
当上面三个条件之一成立、而你保留某个 subagent 时,让主 agent 把 subagents 当作 tools 来调用往往很有效,这样它就能继续掌握与用户的对话。
只有在这个 subagent 需要直接与用户交谈时,我们才建议完整交接(由 subagent 接管对话)。其他情况都可以做成主循环里的一个 skill 加若干 tools。
这样你就能为 subagents 定义共享的响应 schema,用主 agent 拿真实数据校验结论,并裁剪最终合成步骤的输入。这是个不错的第一步,因为你不需要重写这些 subagents。它也让你在决定把任何 subagent 折进主 agent 之前,先拿到一个 task-completion eval 的基线。
不过,有些失败模式仍然会存在:
每个专精 agent 都有自己的 prompt、context、归属团队和 evals 每次调用交回的仍是一份有损摘要 每次调用都是一个嵌套的模型循环,都会增加延迟
通过 skills 和 tools 把 subagents 折进主 agent
一次折进一个 subagent:把每个 subagent 的 prompts 变成 skills,把它的 API 调用变成 MCP tools。对比有它和没有它的 eval 表现,再决定保留哪一个。
对比时不要只查看最终分数,还要看具体是哪些任务翻了盘。我们在一个 sample 支持 agent 上测试这种做法时,把一个 subagent 折进另一个之后延迟降低了,但也打断了一个原本一直通过的流程:主 agent 手里握着订单查询工具,就自行作答,没再去问物流专精 agent 要送达日期。
每次改动之前,确保你的 eval 为生产环境里每一组会一起运行的 agent 链条、以及每条 agent 绝不该打破的规则都备有一条任务,并且每条任务多跑几次,因为上面那种打破在两次运行里只出现过一次。
多个团队如何共同贡献一个 agent
领域推理可以从 knowledge bases、skills 和 MCP tools 里获取。各个团队可以把它们的职责从 agents 转向 skills 和 tools,由一个精干的中心团队继续持有 system prompt 和端到端质量。这包括在每个新 skill、新 tool 和新 eval 上线前先做审查。
MCP tools
当 agent 需要执行一个动作、从系统里读取实时数据、或以固定结构返回结果时,tools 是最合适的载体。在迁移过程中,你也可以把 tools 当作继续调用 subagents 的方式。我们建议按用户意图对 tools 分组(而不是一个 API 一个 tool),因为一旦 system prompt 里超过 30-50 个工具定义,工具选择的质量往往会下降。
用支持延迟加载的 tool search,限制硬性前置条件,并把确实需要的前置条件放进 tools 里。例如,如果 Y 需要 X 的输出,Y 的 tool 会先检查它,并返回一条模型可以照着执行的指令。按用户划分的权限也是同样的做法:每个 tool 检查发起调用的用户能看到什么、能做什么,并返回一条模型读得懂的直白拒绝,这样一个循环就能服务访问权限不同的用户,而不必为每种权限级别单独设一个 agent。
Skills
当 agent 需要知道一个团队是怎么干活的——比如原本写在专精 subagent 的 prompt 里的步骤、规则和判断取舍——skills 是最合适的载体。
我们扩充 skill 库的做法,是把维护工作交还给写 skills 的人。Claude 能承担大部分重活,用那些能够构建、测试和清理其他 skills 的 skills。
为了防止 skill 蔓延,可以让每个团队的 DRI 对自己团队的 skills 负责,确保它们打磨到位、彼此区分清晰,并配有恰当的 evals 一起交付。
/skill-creator 帮你写出从一开始就形态良好的新 skills,也能审计已有的那些,做裁剪、去重和重构。 /skill-doctor 让你看到库里每个 skill 的成本和它实际被使用的频率,删掉无用负担。
Knowledge bases
对于那些 agent 只是不时需要的参考材料,knowledge bases 是最合适的载体。事实与参考材料(政策、指标定义、产品规格)可以放在模型调用的搜索或查询工具后面,或者作为引用文件随 skill 一起交付。不要让代码把这些 context 取出来粘贴进 prompts。
加速这项工作的工具
我们最近发布了一组 Claude API skills,能帮上上面提到的大部分工作。我们的迁移套件把这些 skills 串成一套引导式工作流,用来评估并把多 agent 系统迁移到单个 agent loop。它包含一个 demo,你可以在动真实系统之前先试:
/claude-api build-eval:可以帮你先建一套由中心团队持有的端到端 eval 集,或每个团队随自己的 skill 交付的小型 evals。 /claude-api prompt-audit:能标出你的 prompts、skills 和工具描述里为老模型写的指令,并以 diff 形式提出修复建议。可以在你的 system prompts 上运行,找出那些为早期模型添加、如今却让 agent 变慢或变僵硬的规则。每个团队的 DRI 也可以在自己的 skills 和工具描述上运行它。 /claude-api hillclimb: 可以针对已有的 eval 迭代改进一个应用。它既能用来做「折进来 vs 保留」的对比(把某个 subagent 折成一个 skill 加若干 tools 后,让它迭代 skill 和 tool 的描述,看看折进来的版本能否追平或超过那个 subagent),也能用来优化你的 system prompt。 /claude-api cost-optimize: 给调用去向做画像,并从 prompt caching、裁剪不必要的输入与输出 tokens、effort、模型选择等选项里提出节省方案,一次只改一项。在给定的设计上,它能帮你把成本和延迟压下来。
随着模型演进,我们对如何最好地使用它们的理解、以及围绕最佳实践的指引也在演进。这让某一个具体架构的重要性,低于它背后的那条原则:先测量,一次只改一件事,留下真正站得住的东西。
这里正是这种情况。随着模型能力更强、agents 运行时间更长,你的 subagents 中会有更多可以变成 skills 和 tools。不过你不必一步到位。先搭一个小型端到端 eval,折进一个 subagent,只有当折进来的版本得分更差时才把它留作 subagent,然后重复这个过程。
文章
Oct 19, 2026
Anthropic 重新设计源码管理
当合并进 Anthropic 的 monorepo 的量从每天约 2,500 次增长到超过 30,000 次,源码管理成了最大的开发瓶颈。这里讲的是团队如何构建 Scion——一套为始终在线的 agents 设计的内部版本控制系统,并在五个月内迁移离开 git。
Claude Code
文章
Oct 16, 2026
Anthropic 日本的一名 BDR 如何用 Claude Managed Agents 安排自己的一天
一位业务拓展代表(BDR)如何用 Claude Managed Agents 和 Claude Tag 清空自己的入站队列,并起草双语的客户邮件。
Claude Managed Agents
文章
Oct 16, 2026
Claude Code 团队如何做代码审查
在 agents 产出代码的量级下,你该如何做代码审查?Claude Code 团队分享了他们的审查流程,从 Claude 自己验证自己的工作,到按风险分层的人工审批,外加一份采纳清单。
Claude Code
文章
Oct 13, 2026
Uber 的 CISO 谈如何为 AI 构建内部威胁项目
Uber 的 CISO Philip Martin 谈监控与可观测性对 AI agents 为何重要,以及 Uber 的开源工具如何与 Enterprise Frontier Safeguards 协同工作。
用 Claude 改变你组织的运转方式
查看定价联系销售
获取开发者通讯
产品更新、操作指南、社区亮点等等,每月送到你的收件箱。
如果你想接收我们每月的开发者通讯,请提供你的邮箱地址。你可以随时退订。