在线AI教程 / AI部署
[OpenAI] 在 OpenAI,FDE 意味着什么
在 OpenAI,FDE 意味着什么 我们做什么、怎么工作,以及我们如何解决企业最棘手的问题,交付真正的影响力。 作者:Colin Jarvis,OpenAI Forward De
在 OpenAI,FDE 意味着什么
我们做什么、怎么工作,以及我们如何解决企业最棘手的问题,交付真正的影响力。
作者:Colin Jarvis,OpenAI Forward Deployed Engineering 负责人
了解详情观看直播回放
Codex 刚发布时,团队里有人问我:“如果 Codex 一次就能搞定(one-shot)我们花了几个月搭建的那些用例,那我们做什么?”
这个问题正好触及了 FDE 在 OpenAI 的核心含义。我们与客户并肩工作,理解他们最难的问题,搭建他们能够依赖的解决方案。我们学到的东西帮助塑造我们的产品,也为 Research 提供具体要解决的问题。
这就是进步。如果我们每隔几个月就让自己变得“过时”,那说明我们的 FDE 团队做好了本职工作。
我在 2025 年初创立了这个团队,为了弥合我们所说的 “部署鸿沟”: 模型看起来能做到的事,与人们能可靠地用来完成自己工作的事之间的距离。
模型能力的推进速度,超过了把它们用起来所需的体系和流程。有时候缺的是一个产品。有时候一个模型在基准测试上表现很好,却在真实世界的变量和约束下做不成事。
我们聚焦客户最难的问题。在我们的模型今天就能把活干好的地方,我们和 Product 以及客户一起把解决方案做成可复用的;在模型力有不逮的地方,我们与客户和 Research 一起定义差距并做出改进。我们的目标是让每一次合作都留给下一个客户一个更好的起点——如果我们把底线抬到客户下次不需要 FDE 来解决这一类问题的程度,那我们的工作就做到位了。
John Deere 是一家有 200 年历史的农业企业,它面临的挑战是如何规模化地为农民提供个性化建议。
一个例子是 See & Spray,它的精准除草技术:用摄像头和机器学习来识别杂草并定点喷洒,而不是整块田都施药,从而把化学品使用量最多降低 70%。
但要把这些好处真正兑现,取决于农民是否知道如何配置这套技术、如何规划自己的作业季,以及如何在条件变化时调整自己的做法。
John Deere 部署了 OpenAI 的 API,让这种支持做到个性化、可扩展。
AI 可以用自然语言回答农民的问题、提供针对性的设置指引和建议、识别设备何时没有发挥出全部潜力,并帮助农民理解他们从这项技术里得到的价值。
机会不止于某一次单独的交互:而是在整条客户旅程中持续给出相关的指导,帮助农民更好地利用自己的设备,同时提升效率和可持续性。
这正是 OpenAI 的 FDE 致力于解决的挑战:帮助组织从 AI 能力走向能在复杂真实环境中交付实用价值的系统。
但这些问题往往完全敞开,可能没有既定的标准答案,也没有现成的打法手册。 人人都想做出从未存在过的东西,愿意付出到达那一步所需代价的人却更少。
在寻找有天赋的 FDE 的同时,把“够用”的基线不断往上抬,意味着持续不断的试验和落地。
从结果出发
每次 FDE 团队会议一开始,我都会放一页幻灯片,上面写着一条核心价值观:“从结果出发,用一切必要的办法把事情做成,然后再谈规模化。”
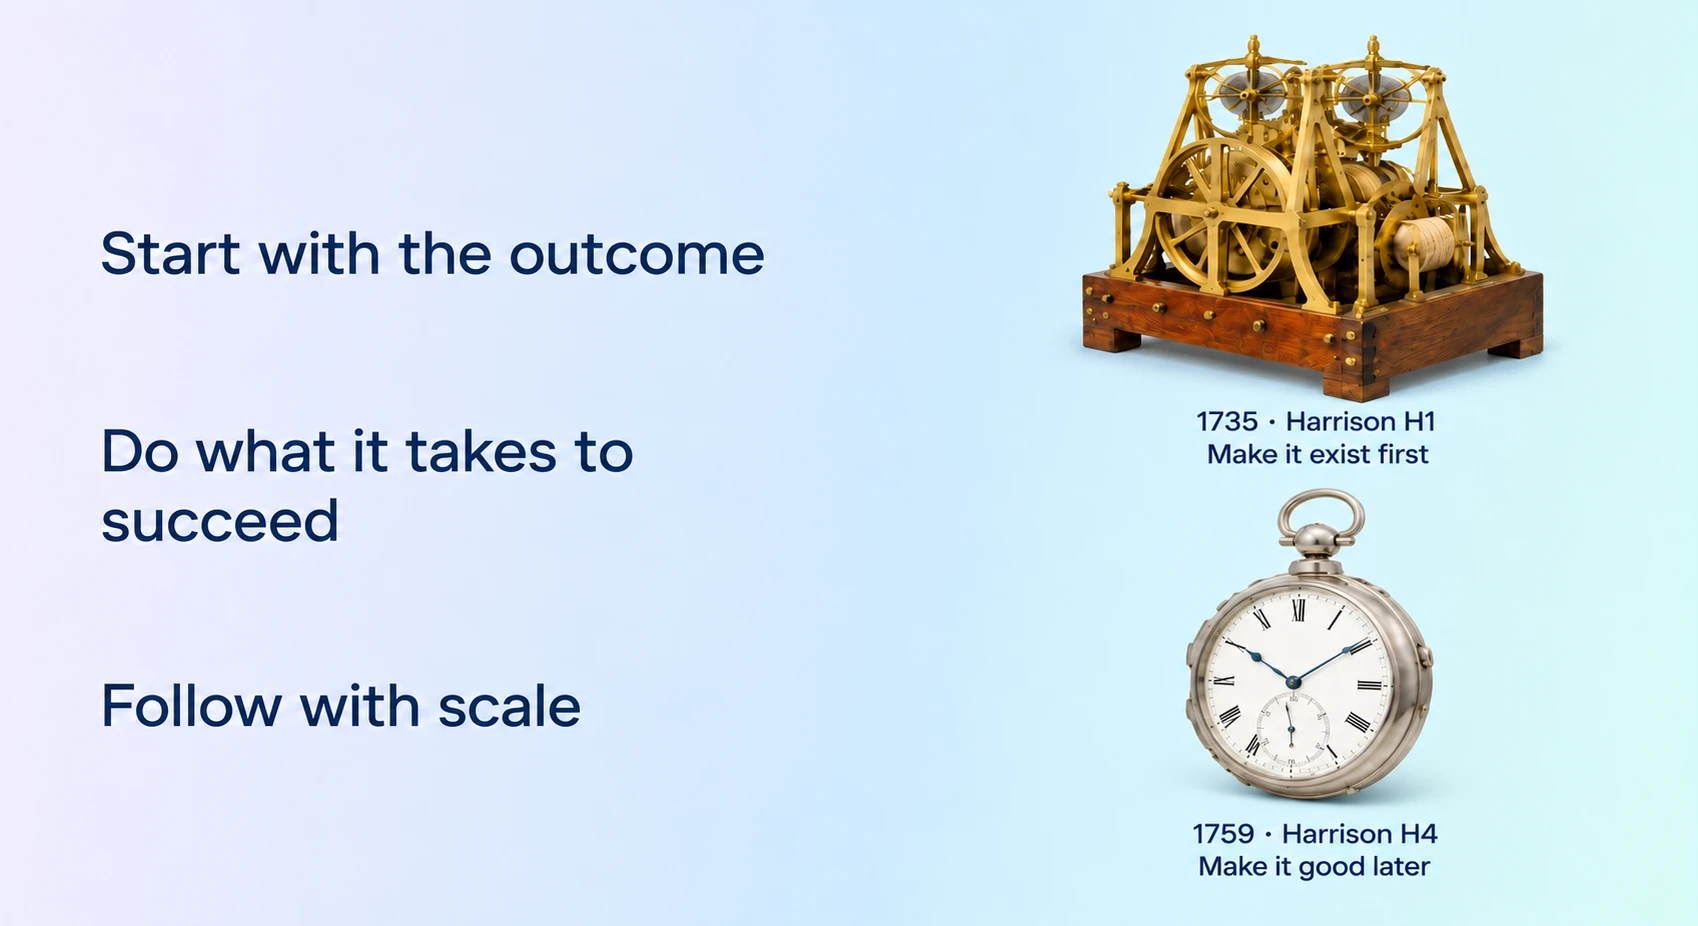
一个惊艳的演示可以走很远,远到没人问它在真实世界里究竟行不行。
我们的职责是解决客户的问题,并达到一个我们敢在生产环境里为之背书的标准。
2025 年年中,我们大约有 15 名 FDE 与一家大型半导体客户合作,覆盖 10 多个用例。我们的雄心是让他们的验证流程变成 AI 原生的,范围包括:
定向测试生成 根因分析与调试 一个架构助手
在这个行业里,验证可以占到一个项目工作量的约 70%。机会巨大,可以下手的地方也非常多。
有些 FDE 加入 OpenAI 才几天,此前从未在半导体行业工作过。他们嵌入式地进驻客户的验证团队,利用业余时间学习芯片设计,并和工程师一起搭建 eval,用来检验 AI 能否生成有用的测试、能否正确诊断芯片故障。
在边学边做的同时,我们为各个具体用例搭建了定制的 harness。最初的 3-6 个月里,这些用例全部上了生产,并拿到了早期用户的采用。回报是看到那些指标:
基于 AI 的定向测试生成节省了约 48% 的时间。 通过内核优化带来 22% 的中位性能提升。 数周的调试被压缩到几小时
当我们把这一切复盘汇报时,首席硬件官问:“你们来这儿之前做过芯片设计师吗?”
我们的 FDE 不需要在第一天就懂这个行业,但把它学会是他们的责任。
随着编程助手让软件更快被构建出来,理解客户的业务变得更加重要。我们组建团队时会把通才和行业专家搭配起来。
你需要足够的知识来做出可靠判断,还需要足够的好奇心去质疑关于现状的种种假设。
比如在生命科学领域,我们 FDE 的科学背景帮助他们赢得研究人员的信任——这些研究人员做的是临床前药物发现的任务,例如靶点验证与优先级排序、基因表达分析、化学合成路线重建。这种专业积累让他们能够就这些工作流如何改进贡献有依据的判断。
让成功可复制
我们已经证明这些工作流能够创造价值,但每一个仍然需要太多定制集成,才能推广到另一个团队。下一个挑战是保住这些成果,同时让软件更易部署、更易维护。
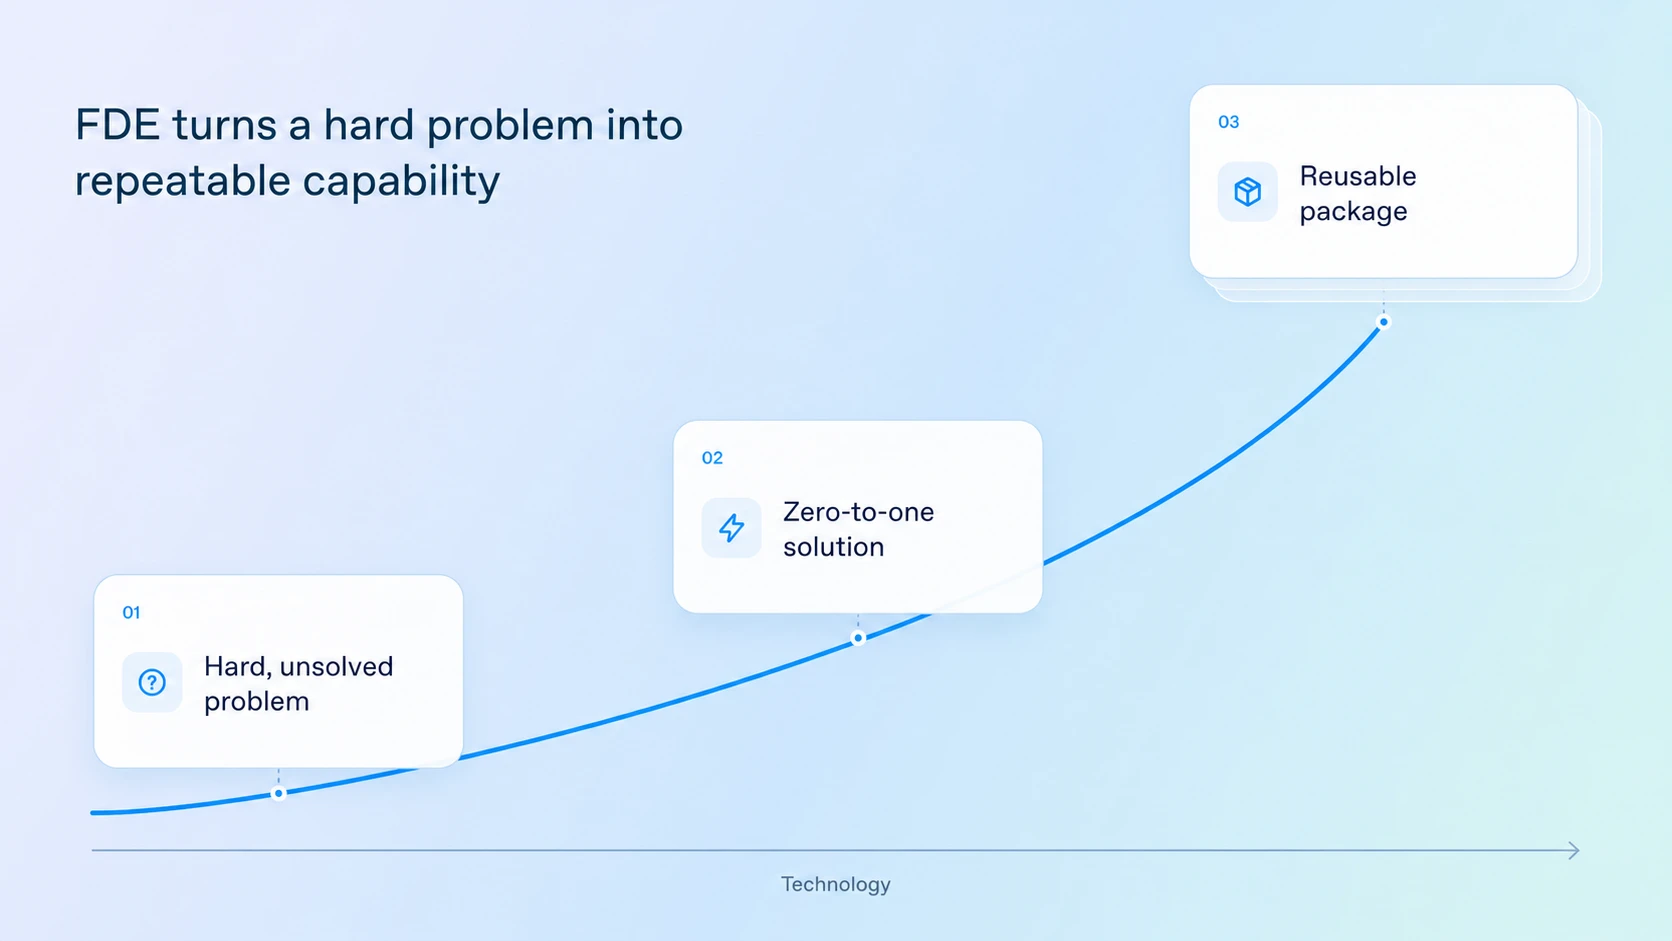
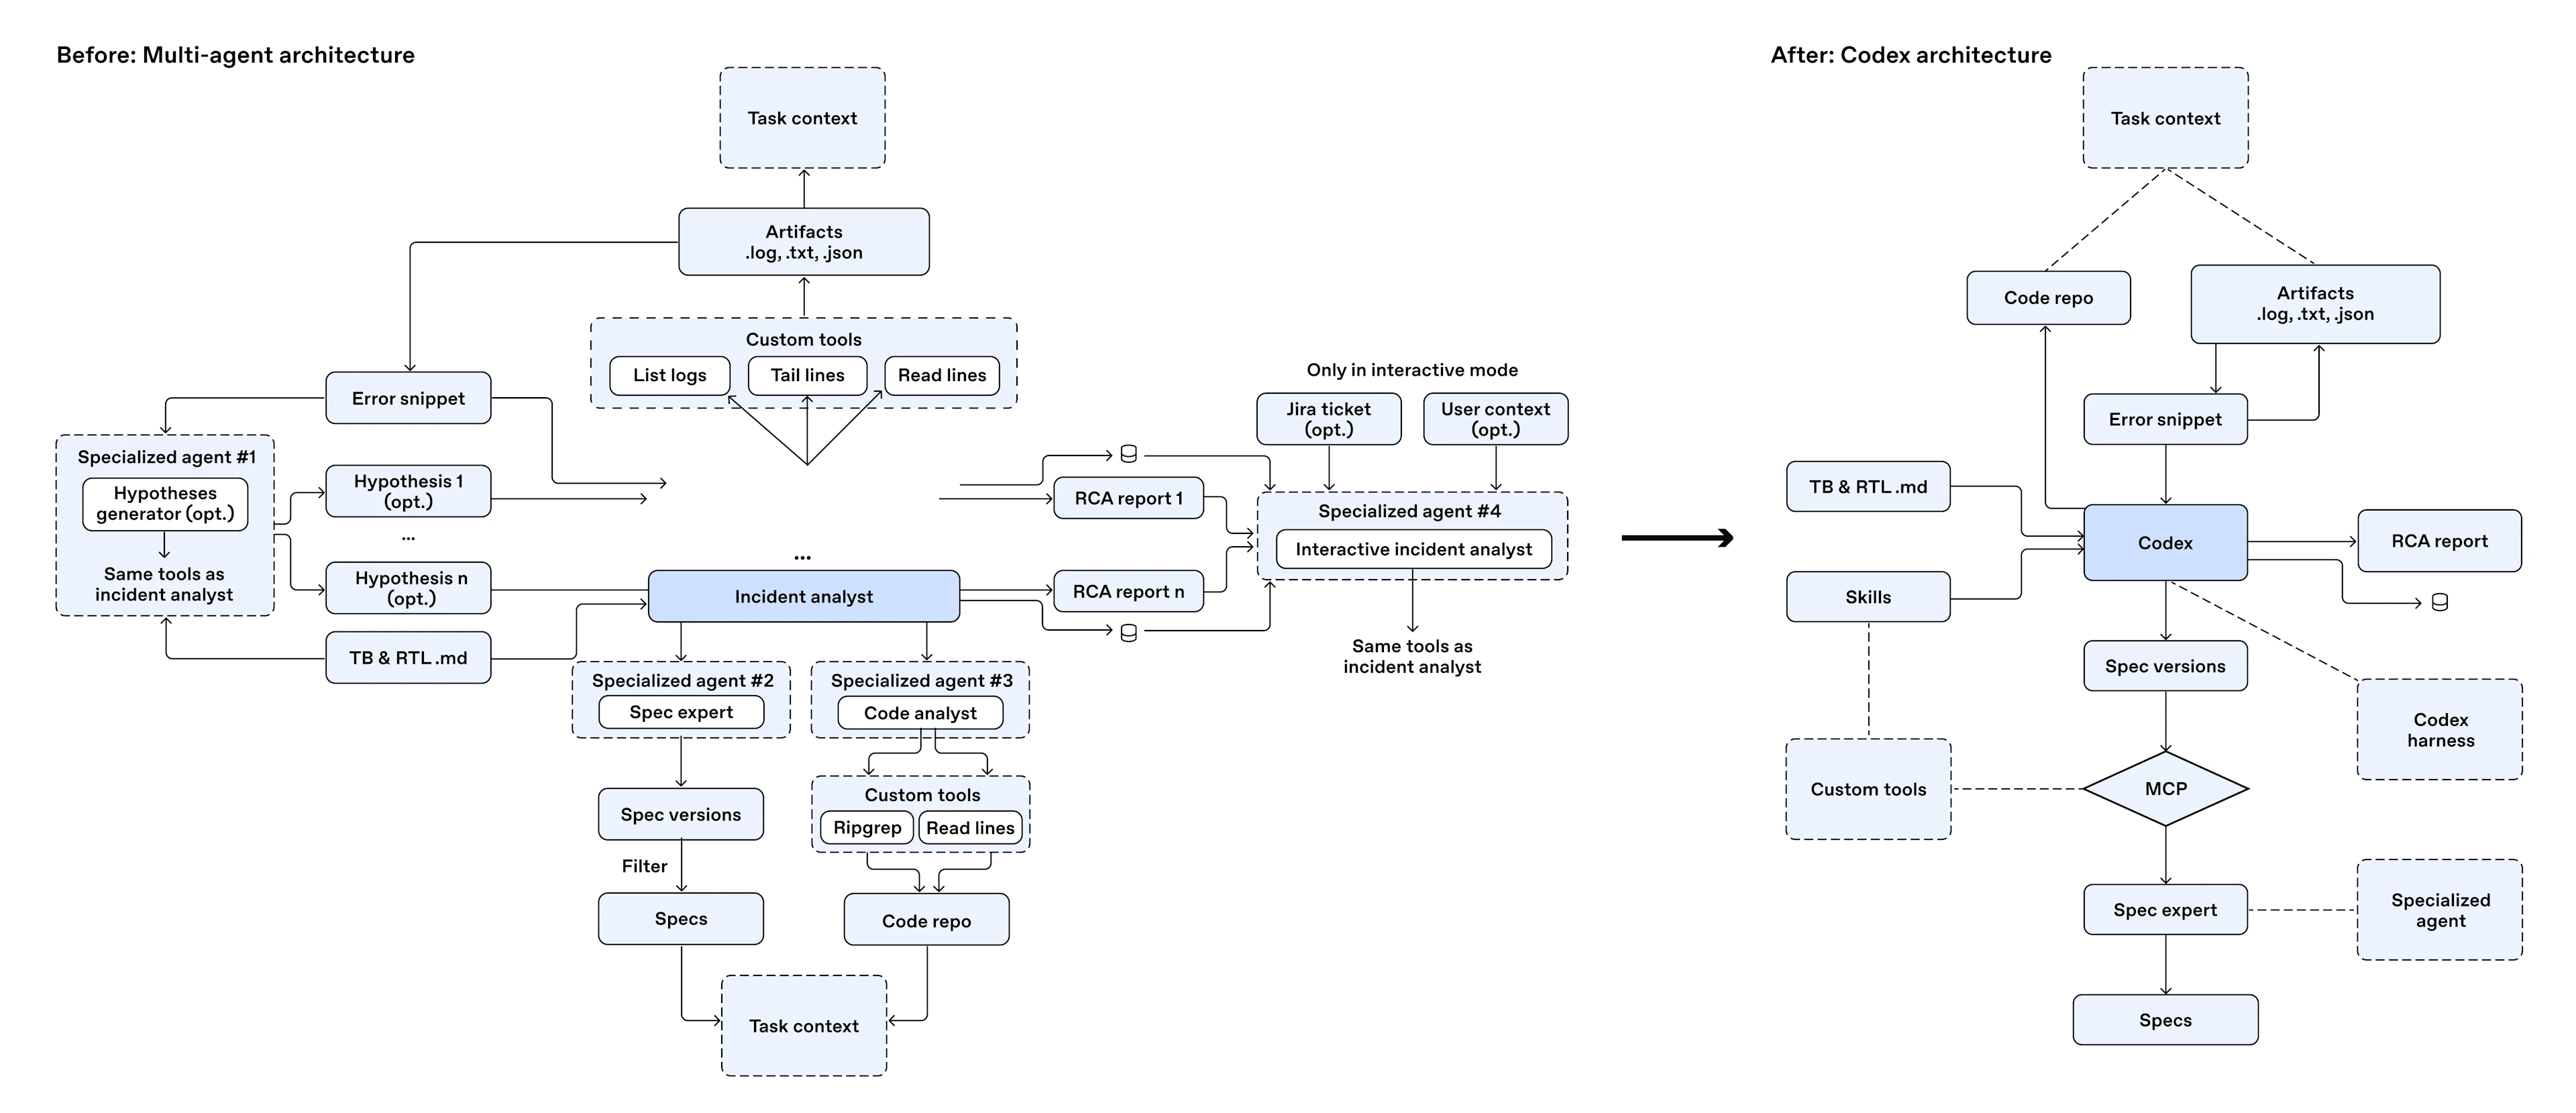
到那时,Codex 的能力已经成长起来。一名 FDE 尝试围绕它重建自己的应用,随后与团队一起把这些用例迁移到一个以 Codex 为核心的通用 harness 上。
定制应用变成了构建在 Codex 通用 primitives 之上的 plugin 和 skill。Codex 也成了统一的界面,让我们得以下线此前为各个用例单独写的 terminal UI 和 CLI。
我们从每个项目里去掉了大约 90% 的定制代码,这改变了我们构建、维护和扩展这些工作流的方式:
我们可以从 Codex 的集中式改进中获益,减少每个单独用例所需的胶水代码 关键功能被打包成 skill 和 plugin,让它们更容易在彼此之间共享,也更容易由 AI CoE 集中管控。这意味着从一个团队扩展到下一个团队可以简单到只是换上新的 connectors/MCP servers、搭建新的 eval(这方面我们同样有一个 skill),然后就能跑起来。 2026 年 8 月的一个例子里,初次部署花了两个月,把方案扩展到第二个团队只用了一天。随着我们规模化,后续团队上线得更快——这一趋势一直在延续:2026 年 8 月的一个用例,初次部署花 2 个月,第二个团队只花 1 天。
那是一种让自己变得“过时”的方式。我们为了上生产所做的工作,已经确立了什么是重要的。随着底层产品不断改进,我们可以替换掉自己定制实现的很大一部分,同时保留它交付的价值。
这就是顺序为什么重要。LLM 让我们构建得很快。把这份速度用来把有价值的东西交到用户手里,弄清楚在实践中什么站得住脚,然后把跑得通的放大。
同样的原则适用于所有合作。
OpenAI Presence——我们面向企业语音和 chat agent 的产品——就是从真实的客户部署中成长起来的。这项工作始于 Swarm,历经 Agents API 演进,如今已有一个客户用 AI 处理它超过一半的电话量。
把这些部署推上生产,教会了我们哪些问题需要定制方案、哪些构件可以被其他团队复用。我们把这些构件带进 Presence,让开发者更容易自动化受监管的工作流,而不必重建底层基础设施。每一次部署都帮助塑造了这个产品,也让下一个客户拥有更好的起点。
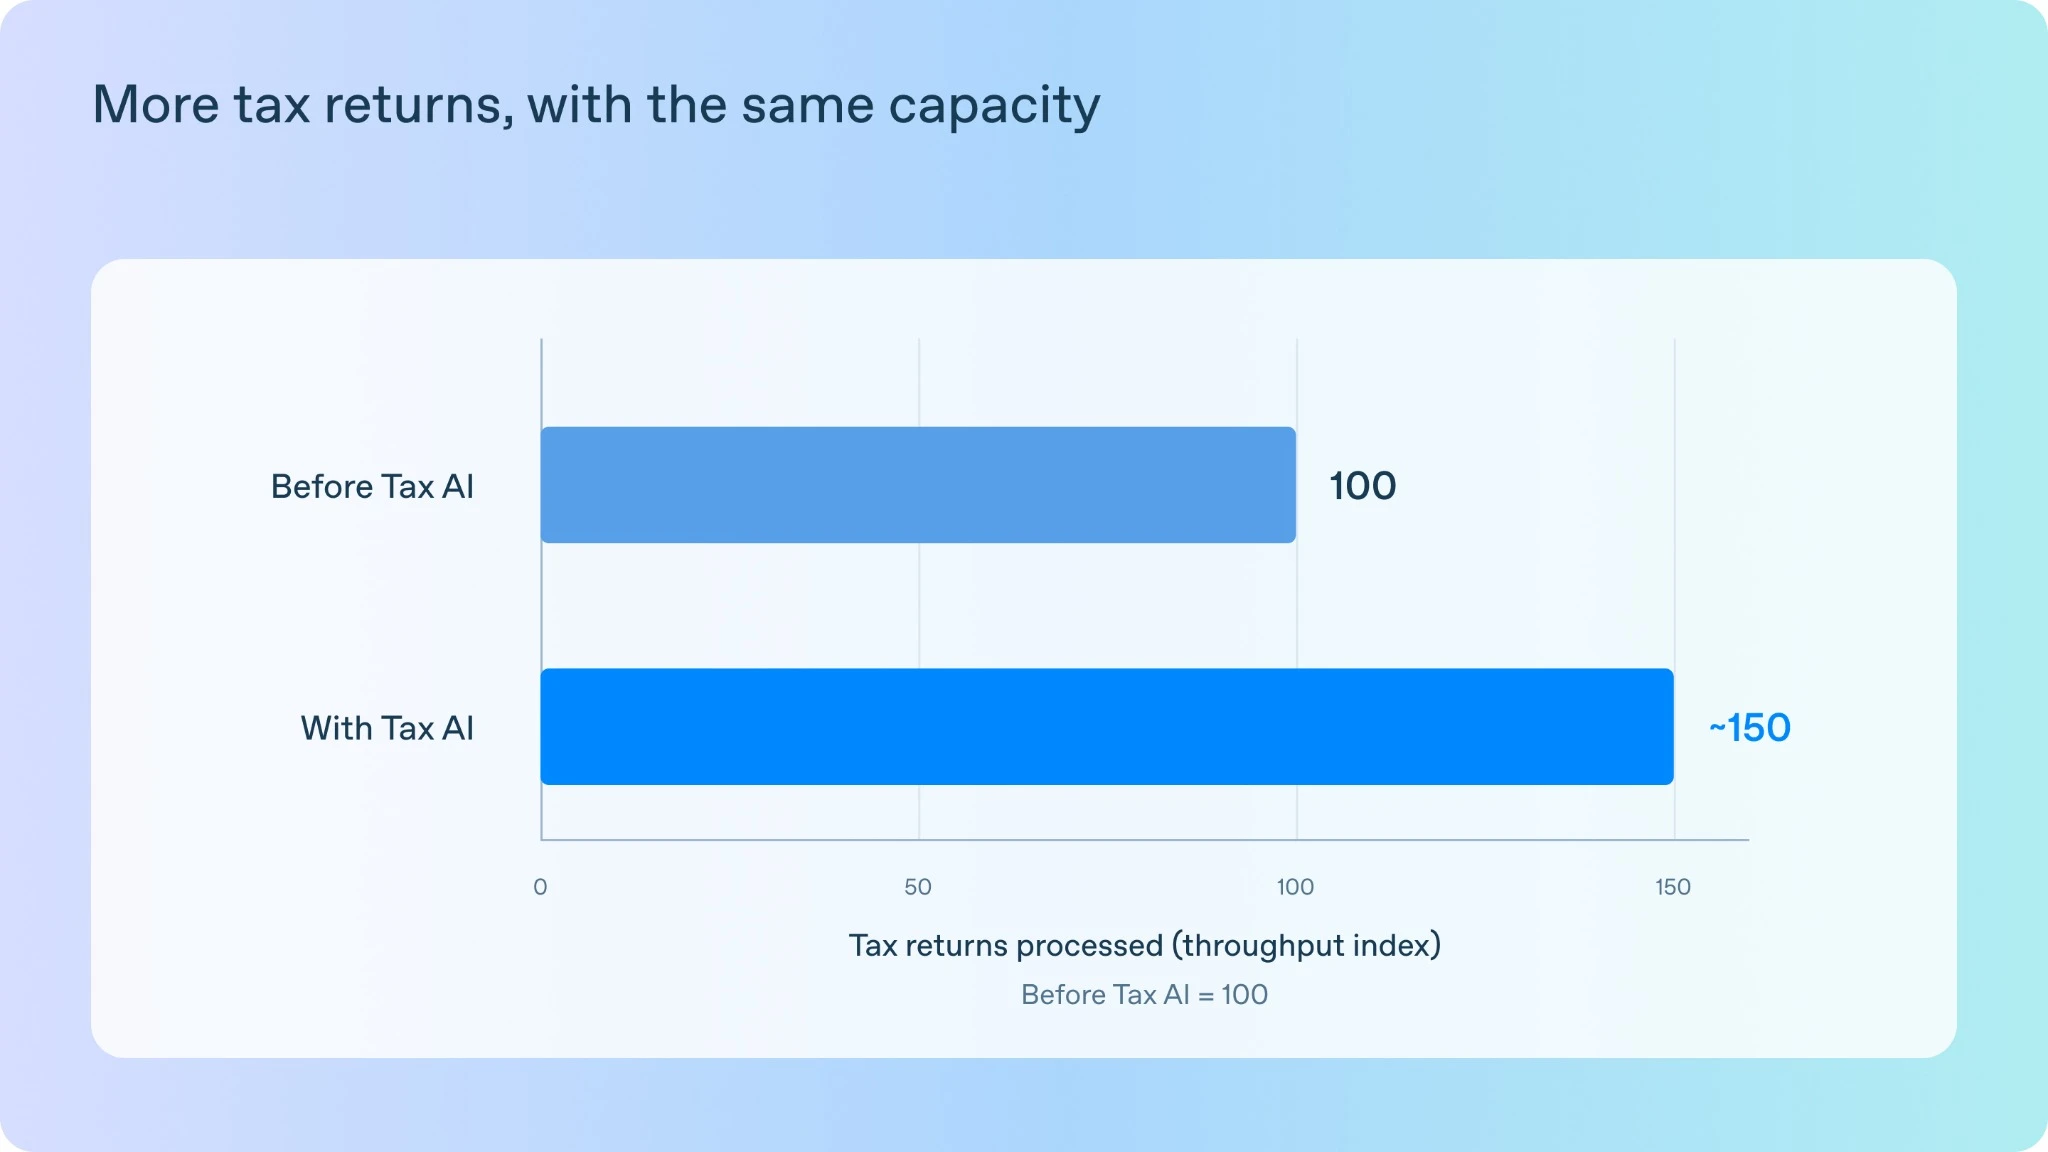
在 Thrive Holdings 这个项目里,OpenAI 的 FDE 和研究人员与工程师、会计师并肩工作,为 Crete 的会计师事务所打造 Tax AI。在试点期间,Tax AI 处理了 7,000 份报税表,把吞吐量提升了约 50%。
最难的挑战之一是自动化出租物业的报税表,这需要六周的工程和执业人员复核,才达到 90% 的精确率和召回率。这项工作沉淀出了可复用的模式,让 Tax AI 更容易扩展到其他复杂的税表。
这些团队现在正把同样的方法应用到记账、审计和 IT 支持上——构建能通过执业人员反馈和真实使用不断自我改进的系统。
智能缺口一冒出来就把它补上
有时候是更好的产品让我们能简化自己搭出来的东西,但有时候是模型本身还做不成这件事。
如果我们只构建今天的模型已经能实现的东西,我们就发现不了 Research 接下来需要弥合的那些智能缺口。因此,我们很多重要的合作一开始就顶着这些极限去做,客户、FDE 和 Research 都承诺一起把这些问题啃下来。
我们此前已经为一家大型电信客户开发了一套客服平台,他们想把它扩展到语音。
语音占他们客服量的九成左右。这类场景比 chat 更难兜住(contain),而且在把口音、语气以及 latency/准确率做到生产级这方面带来了一连串新的技术挑战。把它做对,会对他们的业务产生实质性的差别。
在 scope 阶段,我们的模型在我们用来判断它能否上生产的关键 eval 上得分约 60%。我们已经触及了它能力的边界。客服场景里的 function calling 和指令跟随都需要改进。
我们把这一点讲给了客户,并把 Research 拉进了这项工作。FDE 与客户一起搭建平台、定义模型需要做什么;Research 则着手弥合能力差距,用一版接一版的 model snapshot 让我们对照客户的需求检验进展。
六个月里,关键 eval 上的表现从约 60% 提升到 80%,再到 90% 以上,达到了生产所需的水平。
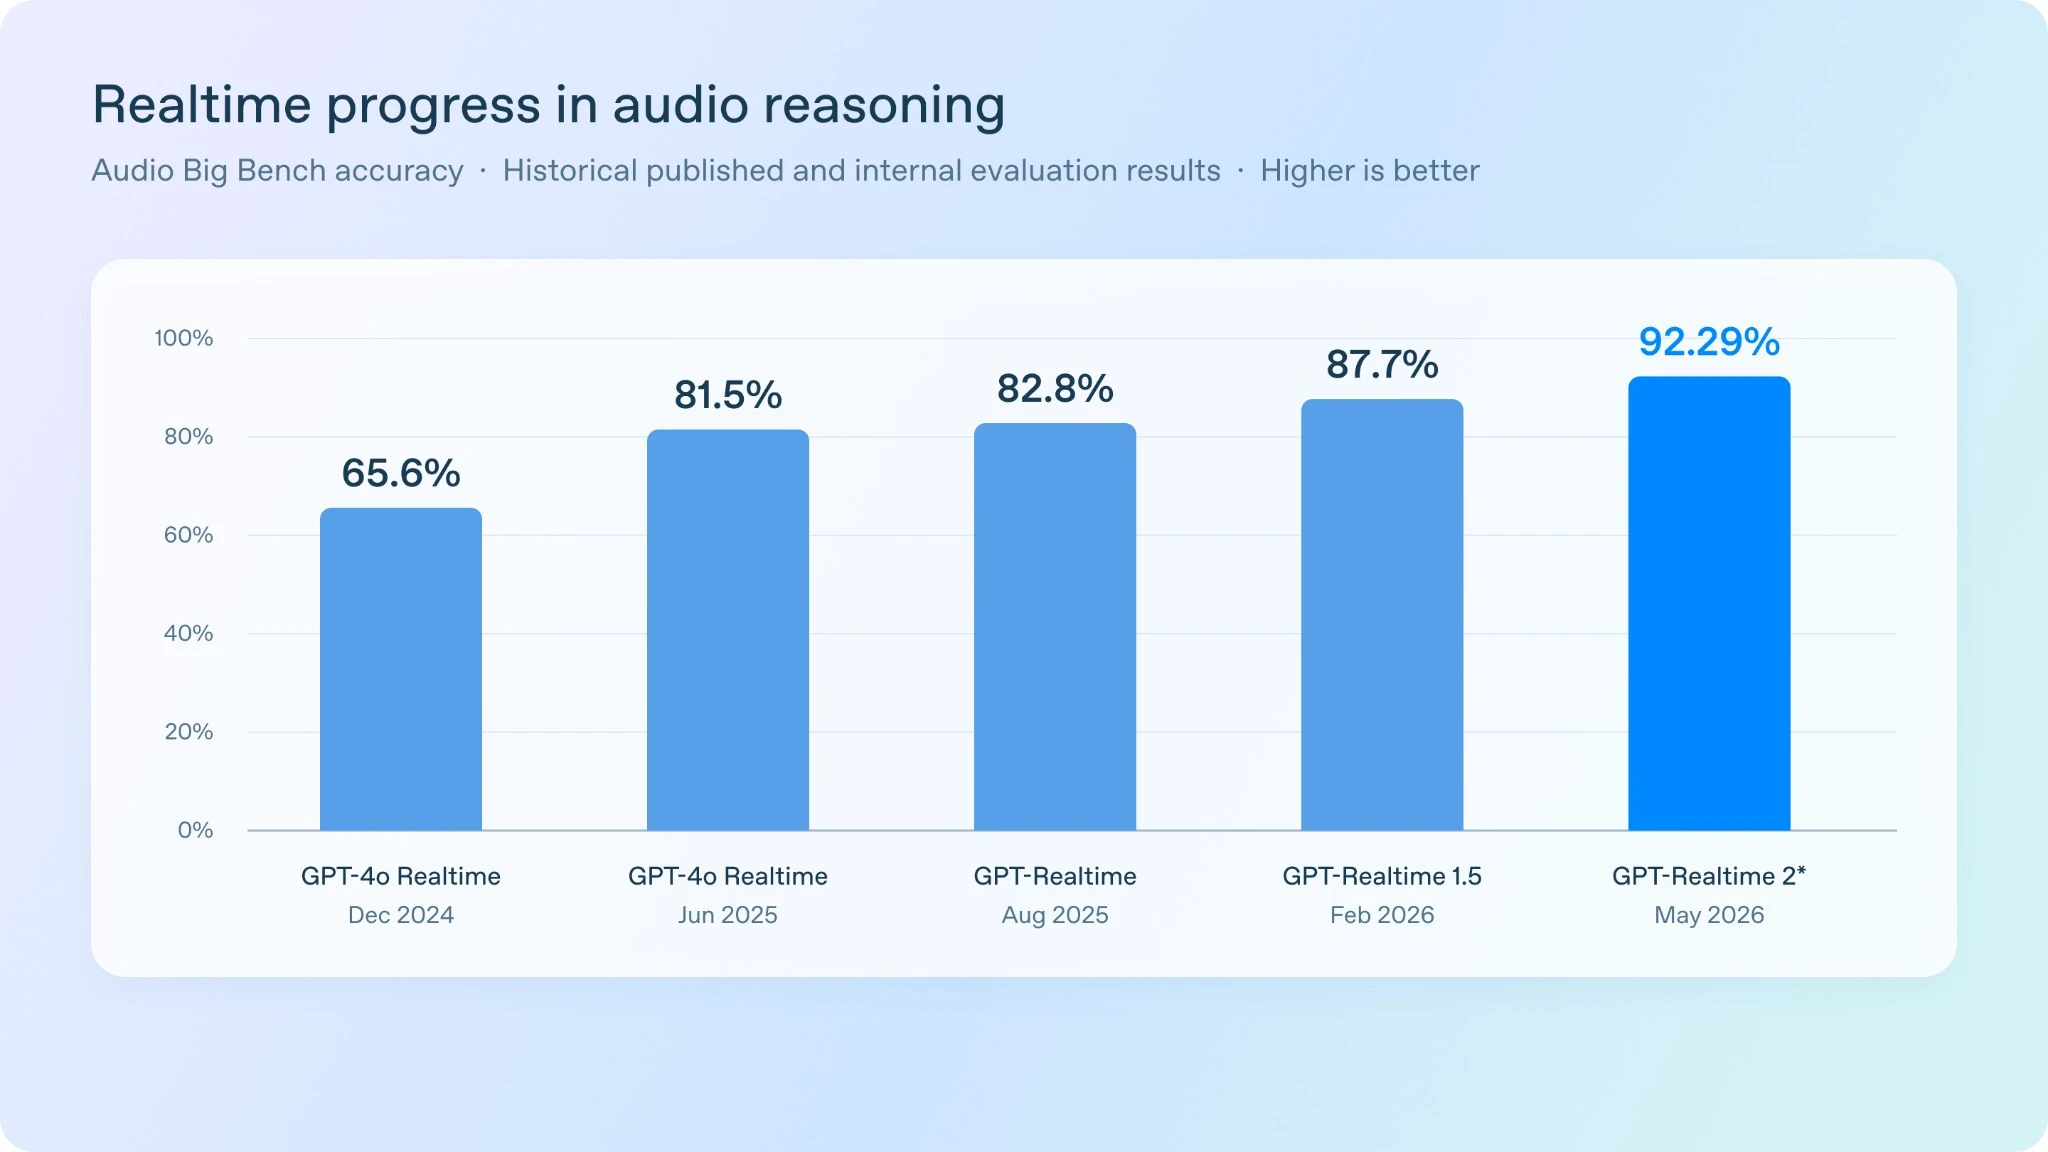
由此得到的语音模型现在支撑着那位客户的部署、其他定制客服部署,以及通过 Presence 交付的托管部署。在一个客户的业务里碰到的问题,帮助确定了能够服务许多其他客户的改进。
每一环都很关键。客户承诺一起攻克一个模型尚不能解决的问题;FDE 保持足够贴近现场,去界定那个问题、搭建平台,并从头到尾推动这次合作;Research 则提升了底层模型能力。
这就是让自己变得“过时”的另一种版本:帮助把一个今天的模型无法解决的问题,变成未来模型能够交付的能力。我们工作的回报,超出了我们在任何一个客户身上花费的时间。
去找更难的问题
我加入 OpenAI,是为了让 AI 在人们的日常工作中真正有用。这一点至今仍在指引着团队。我常跟团队说,在 LLM 开发的多数情况下,Occam's Razor 是适用的——最简单的方案就是最好的。在一家由其前沿研究定义的公司里,在一个被夸大其词浸染的行业里,我们想做的东西是能可靠跑起来、让现场的人可以依靠的。
目标是让每一次合作都能改进接下来的东西:一个更易部署的产品、一个能处理更难任务的模型,或者让下一个客户少做一些定制工作。
如果你有一个想要解决的难题,我们很乐意与你合作。如果你想帮助解决这些难题,我们欢迎你的加入。
那么,当 Codex 能接手我们花几个月搭建的工作时,我们做什么?
去找更难的问题。
2026
作者
Colin Jarvis