在线AI教程 / AI部署
[Amazon Bedrock] 通过 vLLM 中的双向 KV 传输改进多轮代理工作负载的 TTFT
人工智能 通过 vLLM 中的双向 KV 传输改进多轮代理工作负载的 TTFT 多轮代理工作负载建立在累积的上下文之上,作为代理推理、调用工具并合并早期结果。每次新的回合,客户端都
人工智能
通过 vLLM 中的双向 KV 传输改进多轮代理工作负载的 TTFT
多轮代理工作负载建立在累积的上下文之上,作为代理推理、调用工具并合并早期结果。每次新的回合,客户端都会重新发送对话历史记录,包括系统指令、先前的提示、工具结果和模型响应,从而导致不断增长的上下文被重复处理。在[预填充解码(P-D)分解](https://docs.vllm.ai/en/latest/features/disagg_prefill/)中,每个请求都被拆分到专门的节点上:预填充节点处理提示并构建其键值(KV)缓存,然后解码节点检索这些KV块并生成响应。
然而,传统的分解服务仅在一个方向上传输 KV 缓存:从预填充到解码节点。这种单向流程会导致多轮工作负载效率低下。首先,生成响应后,解码节点保存提示和新生成的令牌的 KV 缓存条目。当处理下一轮时,预填充节点无法检索这些条目,因此它必须重新计算先前响应令牌的 KV 投影。其次,解码节点维护会话状态,而预填充节点则不维护会话状态,从而增加了预填充节点上活动会话的缓存逐出概率。在完全缓存未命中时,预填充节点必须重新计算整个对话历史记录的 KV 投影,包括系统指令、先前的用户请求、工具结果和模型生成的响应。随着对话的增长,这种冗余工作会消耗更多的加速器容量并增加第一个令牌 (TTFT) 的时间。
当您构建会话助理和代理应用程序时,较长的交互历史记录可能会增加延迟,并通过重复的预填充计算消耗加速器容量。在这篇文章中,我们展示了双向 KV 缓存传输如何让预填充和解码节点跨轮重用先前计算的上下文,这提高了加速器利用率并帮助应用程序随着对话的增长维持响应式 TTFT。
在我们使用 Amazon Elastic Compute Cloud (Amazon EC2) P5en 实例进行 1P1D 部署的多轮基准测试中,双向 KV 传输将 Qwen3-32B 的 TTFT 降低了高达 1.6 倍,将 zai-org/GLM-5-FP8 降低了高达 3.3 倍(请参阅性能数据部分)。结果因工作负载和配置而异。这些实例与 AWS Elastic Fabric Adapter (AWS EFA) 连接,这是一种跨 AWS 中的服务器使用的低延迟远程直接内存访问 (RDMA) 网络。在支持的实例类型上,AWS EFA 支持 GPUDirect RDMA 和 Neuron Direct RDMA,以便在预填充和解码节点上的 GPU 或 AWS Trainium 设备内存之间直接移动 KV 块。
我们最初在与 EFA 连接的 AWS Trainium 实例集群上构建并验证了该功能,并将其作为与加速器无关的功能贡献给 vLLM。此处显示的结果来自具有 EFA 的 Amazon EC2 P5en GPU 集群,表明这些优势也同样适用于 GPU。这篇文章解释了双向 KV 传输架构、路由器元数据流、KV 块保留和重新计算控制、性能结果以及如何重现基准测试。
双向KV传输
双向 KV 传输是一种机制,其中解码节点在后续对话轮次中将先前计算的 KV 返回到预填充节点。这避免了在预填充节点上重新计算共享上下文,并由可配置的 KV 重新计算阈值控制。它减轻了前面描述的两种计算冗余场景。为了使其工作,KV 必须在产生它的转弯处幸存下来,并在 KV 缓存感知路由器的协调下沿相反方向行进。
用于双向传输的 NIXL KV 连接器增强功能
我们扩展了 NVIDIA Inference Xfer Library (NIXL) KV 连接器,让预填充节点使用远程 KV 块,类似于解码节点已经使用预填充节点提供的 KV 块的方式。这不是一个微不足道的更改,因为两种节点类型在架构上不同:预填充节点计算新提示令牌的 KV 表示,并可以提供完整的提示 KV 块。解码节点缺乏生成完整 KV 表示的能力(或效率),只能服务于之前缓存的 KV 块。因此,预填充和解码节点仍然具有自己的角色和逻辑来计算远程和本地 KV 块的元数据。然而,实际的 KV 传输机制(NIXL READ)对于“P->D”和“D->P”方向是通用的。
下图首先以蓝色显示现有流程。路由器将请求发送到预填充节点,预填充节点计算提示 KV 并返回其块元数据,路由器将请求和元数据转发到标准 P→D NIXL READ 的解码节点。编号的红色路径说明了双向 KV 传输添加:(1) 解码节点在生成后保留合格的 KV 块,(2) 在流响应中返回其元数据,(3) 路由器缓存该元数据以用于下一个预填充请求。然后,预填充节点 (4) 在应用本地缓存匹配后检查远程可重用 KV,(5) 当可重用令牌计数满足阈值时对异步接收进行排队,以及 (6) 在计算剩余后缀之前执行 D→P NIXL READ。
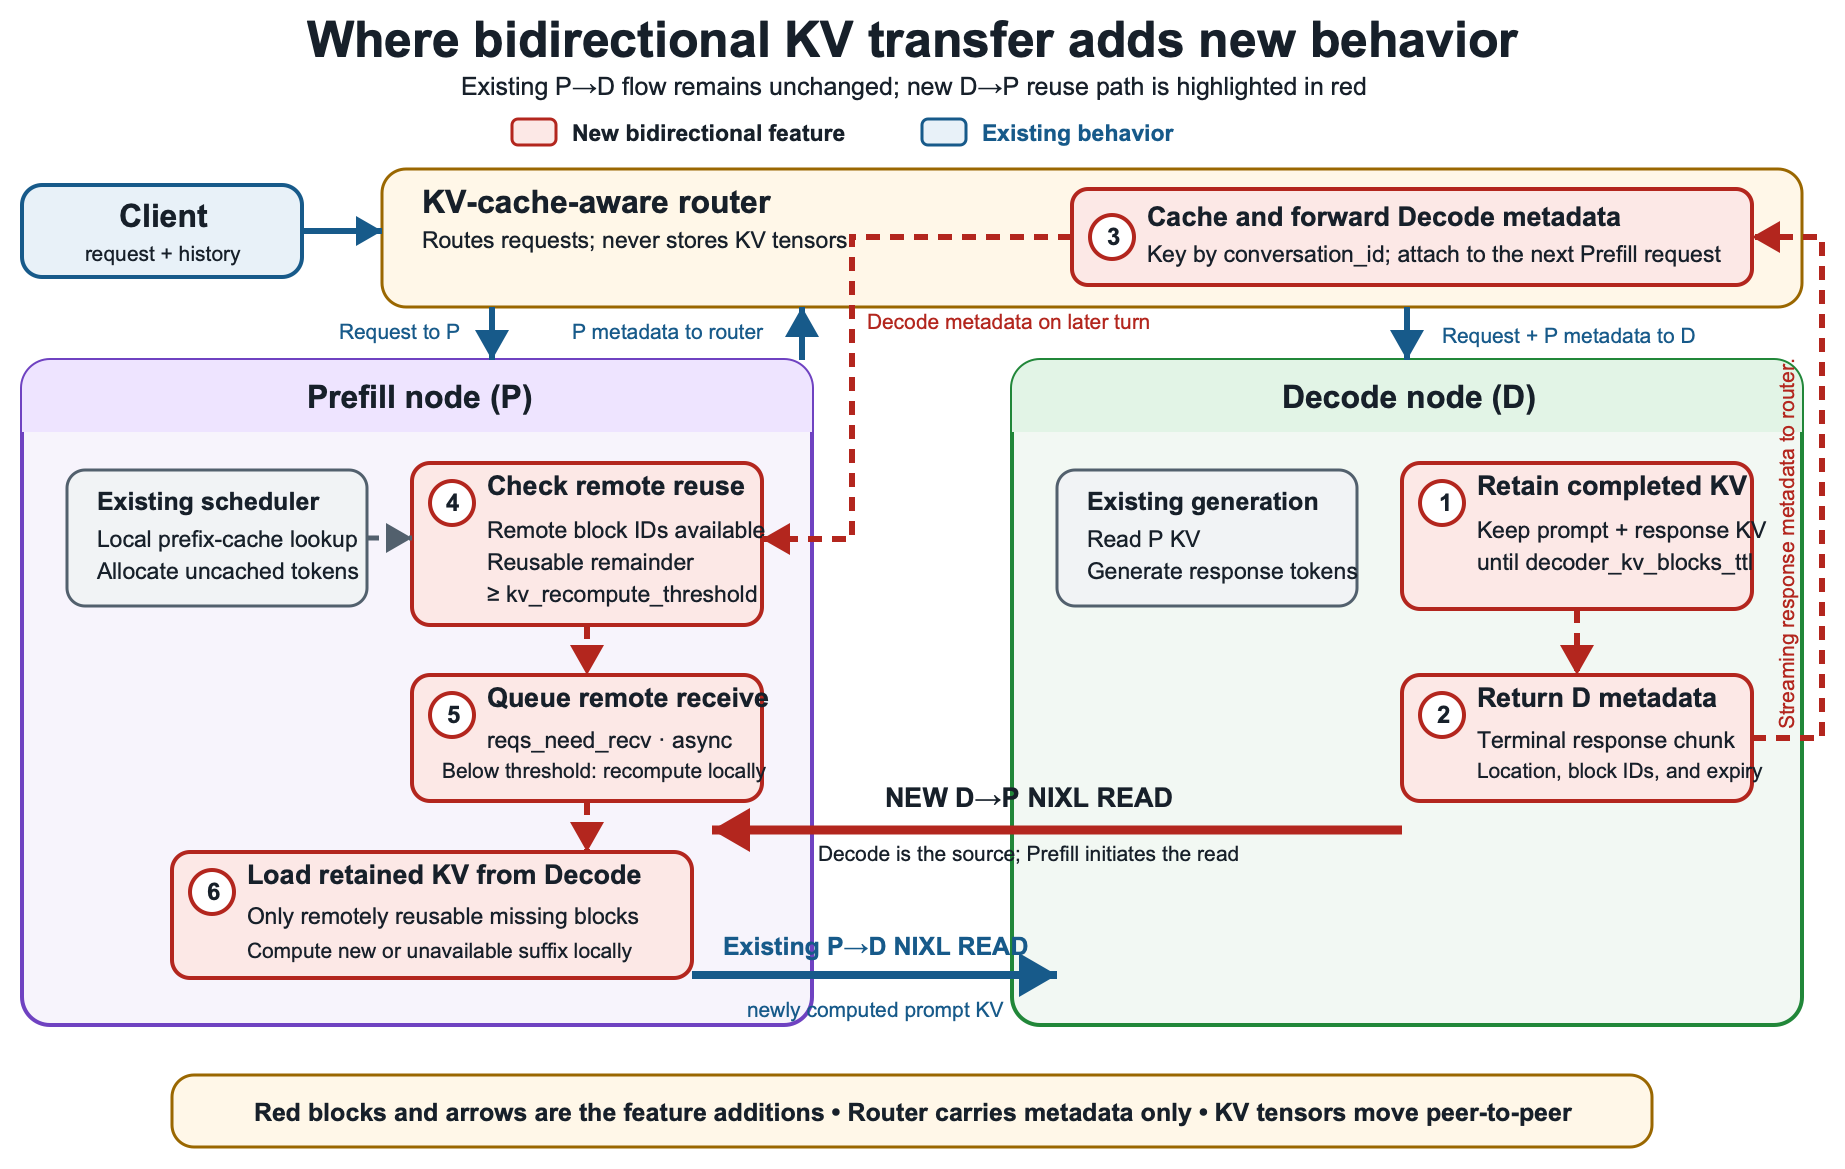
图 1:标准预填充到解码流程(蓝色)和双向 KV 传输添加(红色)
KV 缓存感知路由器
vLLM 包括对双向 KV 传输的连接器端支持,而协调跨会话的 KV 重用需要一个 KV 缓存感知路由器。 vLLM GitHub 提供了一个示例代理,它实现了本文中使用的流程,可以根据您的环境进行调整。
KV 缓存感知路由器是客户端、预填充和解码节点之间的轻量级、有状态的控制平面组件。它维护从客户端提供的“conversation_id”到解码的“kv_transfer_params”的内存映射。路由器仅存储块位置元数据,而不存储 KV 张量,并从响应流中获取该元数据,而不是单独查询解码节点。
下图显示了路由器如何跨会话管理 KV 元数据。在第一轮中,缓存查找未命中,请求遵循标准 P→D 流程。然后路由器从响应流中保存解码的元数据。在稍后的回合中,路由器使用“conversation_id”检索元数据,以便预填充可以重用解码中的 KV。然后,它会在生成后刷新下一轮的元数据。
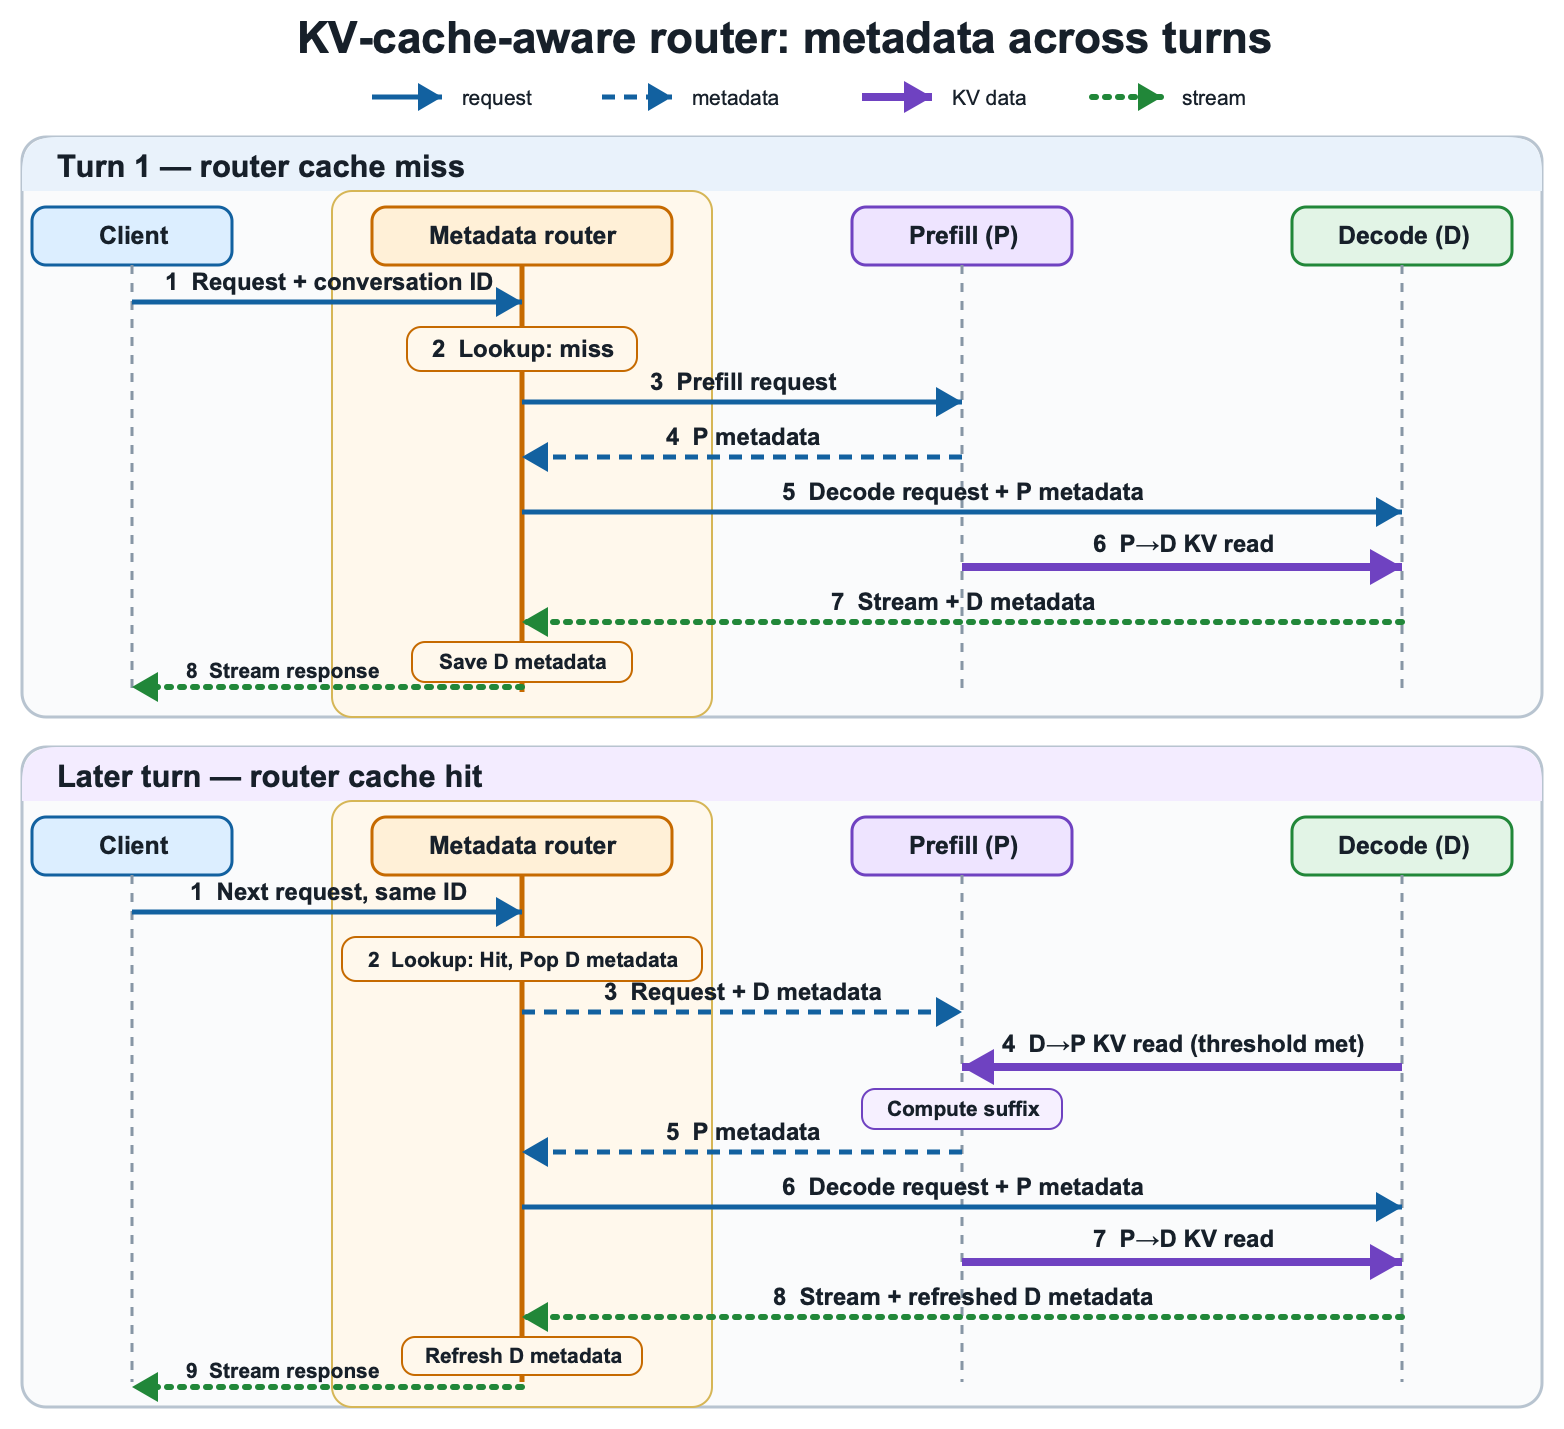
图 2:跨会话轮次的 KV 缓存感知路由器元数据流
块保留 TTL
通常,解码实例在生成完成后立即释放请求的块。在双向 KV 传输模式下,它会在可配置的生命周期(“decoder_kv_blocks_ttl”,默认 480 秒)内保存它们,并发布它们的位置和到期时间。对话的 KV(提示前缀和生成的响应)将在下一轮保持可用。对于在生存时间 (TTL) 到期之前到达的轮次,预填充节点会重用 KV。较晚到达的产品会恢复到正常的预填充状态。由于此 TTL 是固定的且不会更新,因此请将其调整为轮次之间的预期时间,以平衡 KV 重用与加速器内存使用。自然的下一个改进是将心跳更新的租约扩展到解码端。然后,解码实例可以在会话空闲时立即回收块,而不是在固定计时器结束时回收块。
KV重新计算阈值
KV 重用并不总是比本地重新计算更快。对于较短的可重用前缀,互连和协调开销可能超过重新计算令牌所需的时间。 “kv_recompute_threshold”设置(默认为 64 个令牌)控制此决策。当要计算的令牌计数低于阈值时,预填充节点重新计算,并在等于或高于阈值时从解码节点提取 KV。部署可以根据模型计算时间、KV 大小和互连性能调整此值。
性能数据
为了进行评估,我们在使用与 EFA 连接的 Amazon EC2 P5en 实例的 1P1D 部署中使用了 Qwen3-32B 和 GLM-5-FP8 模型。为了模拟预填充节点已逐出其本地缓存或路由器选择不具有会话 KV 块的不同预填充节点的场景,我们使用“--no-enable-prefix-caching”在预填充节点上禁用了前缀缓存。
在这两种模型中,打开双向 KV 传输可以减少多轮对话的预填充计算,并且好处通常会随着提示长度的增加而增加。关闭该功能后,预填充实例每轮都会重新计算整个增长的上下文,因此 TTFT 急剧上升。 Qwen3-32B 从 2k 时的 158 毫秒上升到 24k 时的 778 毫秒,GLM-5-FP8 从 2k 时的 500 毫秒上升到 20k 时的 2,334 毫秒。当它打开时,解码实例的保留 KV 将被重用而不是重新计算,从而使 TTFT 更加平坦。 Qwen3-32B 在相同范围内仅从 122 ms 上升到 460 ms(在最长提示下大约减少 1.6 倍),而 GLM-5-FP8 从 358 ms 上升到 702 ms,并且在长提示下比重新计算路径运行最多 3.3 倍。预填充持续时间细分解释了原因。
双向传输增加了少量的 KV 传输时间(Qwen3-32B 约为 30 ms 至 130 ms;GLM-5-FP8 约为 29 ms 至 110 ms),但它消除的预填充计算远远超过了 KV 传输时间。因此,传输开启时的总预填充持续时间(Qwen3-32B:128 ms 至 414 ms;GLM-5-FP8:316 ms 至 541 ms)远低于仅重新计算路径(Qwen3-32B:153 ms 至 744 ms;GLM-5-FP8:500 ms 至 2,331 ms)。较大的 GLM-5-FP8 模型显示出更大的绝对和相对差距,因为其较高的每个令牌重新计算时间使得 KV 重用随着模型和上下文的扩展而获得更多回报。
Qwen3-32B
下图绘制了 Qwen3-32B 的 TTFT 与提示长度的关系,比较了双向 KV 传输 ON 与 OFF 的情况。
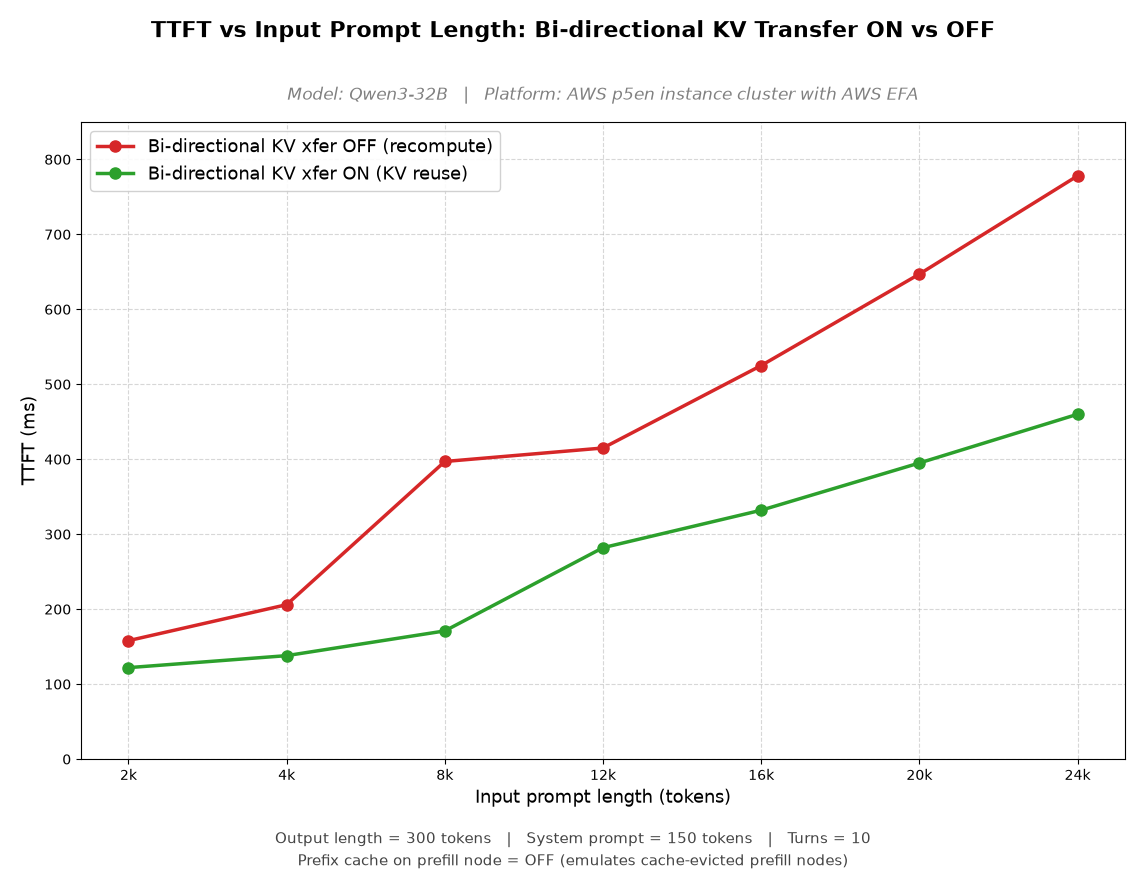
图 3:Qwen3-32B TTFT 与双向 KV 传输打开和关闭时的提示长度
下一个图表将相同运行的预填充持续时间分解为重新计算和 KV 传输组件。
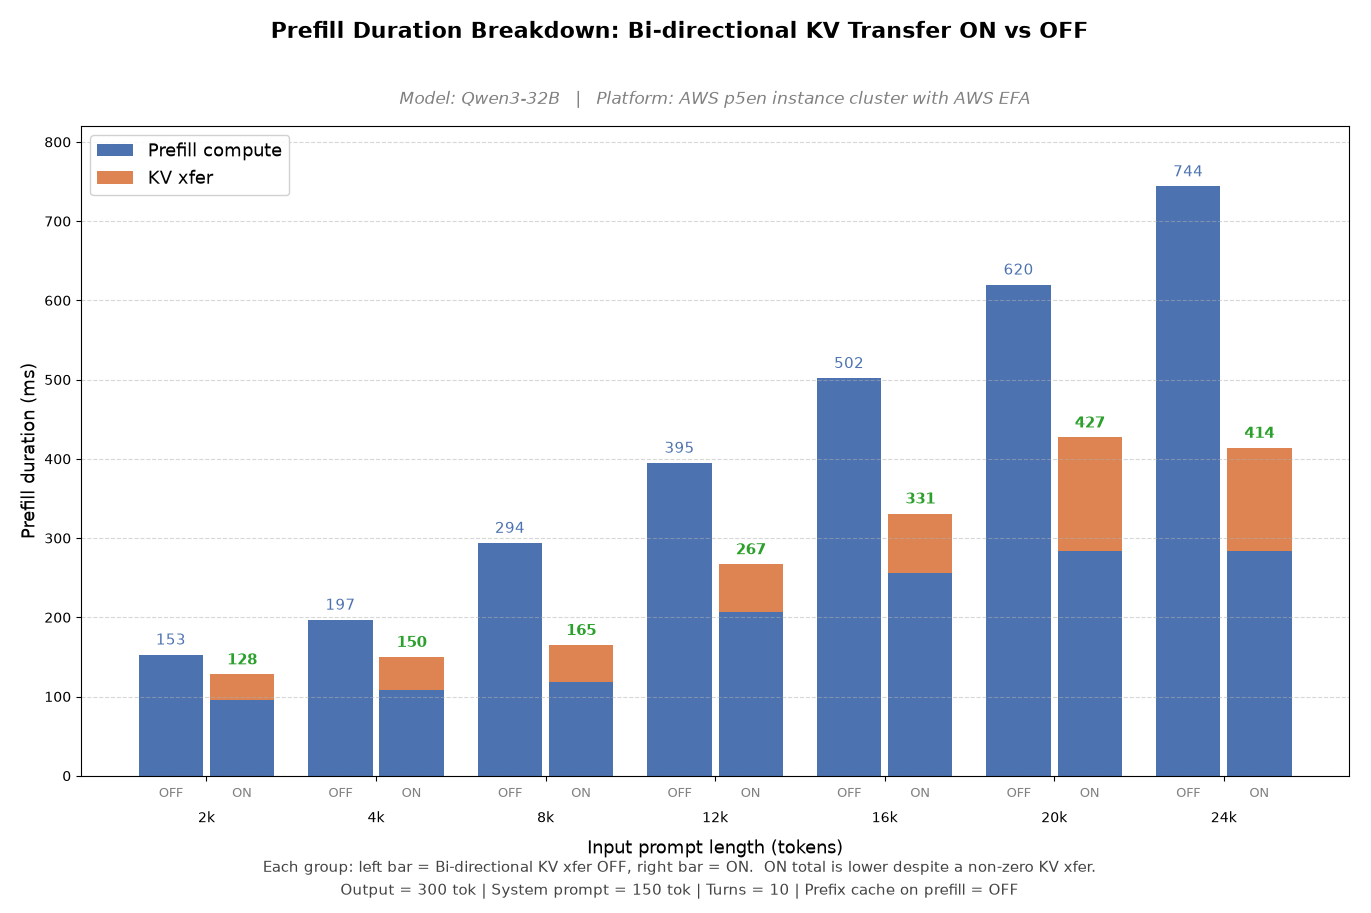
图 4:Qwen3-32B 预填充持续时间分为重新计算和 KV 传输组件
这些图表显示,TTFT 在功能开启时几乎保持平稳,而关闭路径则随着上下文的增长而急剧攀升,因为较小的 KV 传输时间远远超过了它所删除的重新计算时间。
zai-org/GLM-5-FP8
GLM-5-FP8 也有同样的两个视图。第一个图绘制了 TTFT 与提示长度的关系,其中功能为 ON 与 OFF。
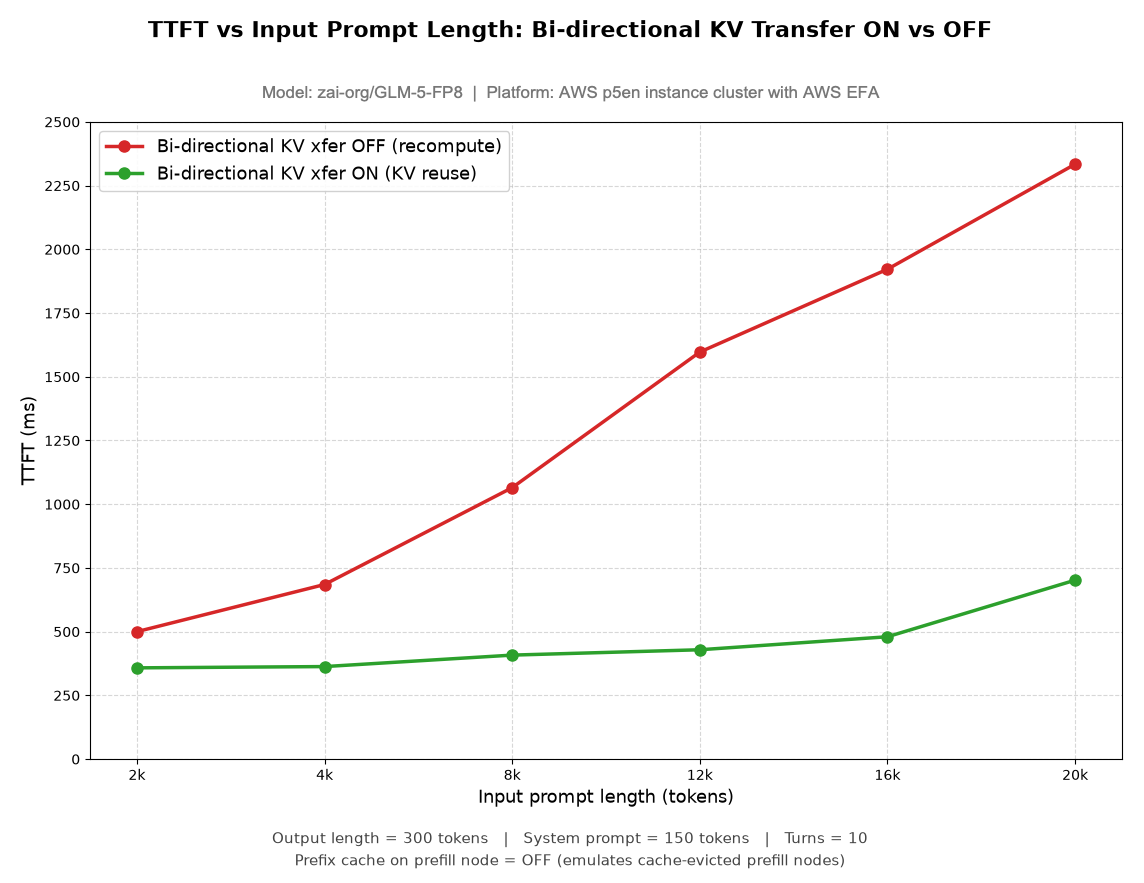
图 5:zai-org/GLM-5-FP8 TTFT,开启和关闭 KV 重用
第二个将预填充持续时间分解为其重新计算和 KV 传输部分。
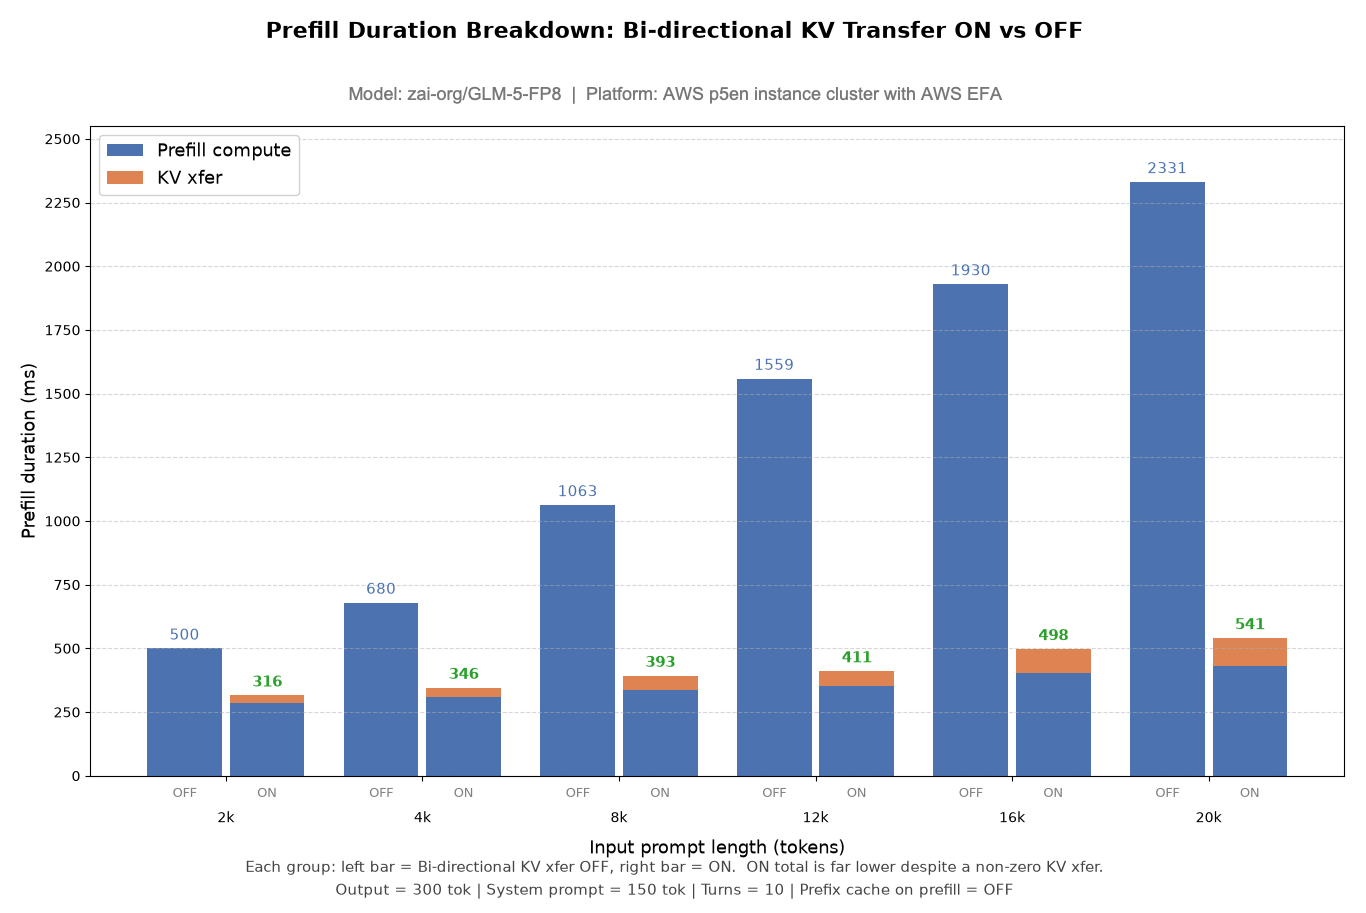
图 6:zai-org/GLM-5-FP8 预填充持续时间细分
GLM-5-FP8 显示出比 Qwen3-32B 更大的差距,在长提示下 TTFT 降低了约 3.3 倍,因为其较高的每个令牌重新计算时间使得 KV 重用随着上下文长度的增长而获得更多回报。
如何运行基准测试
要使用 Amazon EC2 P5en 实例和 EFA 重现我们的 1P1D 基准配置、一个预填充节点和一个解码节点,请按照 [重现我们的结果] 中的分步说明进行操作。指南](https://github.com/vllm-project/vllm-project.github.io/blob/main/_posts/2026-10-12-bi Direction-kvxfer-multiturn-agentic-workload.md#appendix-reducing-our-results)。该指南涵盖环境设置、启动 vLLM 预填充和解码服务器、运行基准测试以及收集结果。该功能可以在其他支持的配置上运行,但性能结果将根据硬件、型号、工作负载和网络配置的不同而有所不同。
## 结论
在这篇文章中,我们展示了双向 KV 缓存传输如何随着代理会话历史记录的增长而减少 TTFT。在 P-D 分解部署中,该功能允许预填充节点跨轮重复使用解码节点保留的 KV 块,从而减少重复计算。可配置的块保留和重新计算阈值确定何时发生重用。在使用与 EFA 连接的 Amazon EC2 P5en 实例的 1P1D 部署中,在测试的最长提示长度下,我们观察到 Qwen3-32B 的 TTFT 减少了 1.6 倍,zai-org/GLM-5-FP8 的 TTFT 减少了 3.3 倍。结果取决于工作负载和部署配置。要在您的环境中实现此功能,请将 vLLM v0.21.0 或更高版本与 NixlConnector 结合使用,在预填充和解码服务器上启用“双向 kv_xfer”,使用 kv 缓存感知路由器,并遵循 [GitHub 复制]指南](https://github.com/vllm-project/vllm-project.github.io/blob/main/_posts/2026-10-12-bi Direction-kvxfer-multiturn-agentic-workload.md#appendix-reducing-our-results)。
相关资源
AWS EFA 预填充解码 (P-D) 分类服务 多轮对话的基准 KV 缓存卸载
致谢
我们感谢 vLLM 社区对维护此功能的支持。
关于作者