在线AI教程 / AI部署
[Amazon Bedrock] 基于推送的 KV 传输可改进 TTFT 和 TPOT,以实现 vLLM 中的分类推理
人工智能 基于推送的 KV 传输,以改进 TTFT 和 TPOT,以实现 vLLM 中的分类推理 vLLM 是一个用于大型语言模型 LLM 的开源推理和服务引擎。 LLM 推理有两
人工智能
基于推送的 KV 传输,以改进 TTFT 和 TPOT,以实现 vLLM 中的分类推理
vLLM 是一个用于大型语言模型 (LLM) 的开源推理和服务引擎。 LLM 推理有两个不同的阶段:预填充(处理输入提示并构建键值 (KV) 缓存)和解码(使用该缓存一次生成一个令牌)。这些阶段具有不同的计算、内存和扩展特征。 预填充解码 (P-D) 分解 在单独的引擎实例上运行它们,允许每个阶段独立扩展和优化。这可以提高资源利用率、吞吐量和负载下的延迟。然而,它还需要在开始生成令牌之前将 KV 缓存从预填充实例传输到解码实例,这使得高效的 KV 传输对于首次令牌时间 (TTFT) 至关重要。
vLLM 执行此传输的方式之一是通过 NVIDIA Inference Xfer Library (NIXL) 连接器,它通过支持远程直接内存访问 (RDMA) 的互连移动 KV 块,例如 AWS Elastic Fabric Adapter (AWS EFA,AWS 中跨服务器使用的低延迟 RDMA 网络。在支持的实例类型上,AWS EFA 支持 GPUDirect RDMA 和 Neuron Direct RDMA。因此,NIXL 可以直接在 GPU 或 AWS Trainium 设备内存之间传输 KV 块,而无需通过主机内存进行暂存。 NIXL 连接器的默认模式是基于拉取:预填充实例完成计算提示 KV 缓存后,路由器将源元数据(包括预填充块 ID)中继到解码实例。然后,解码实例分配目标块,准备 NIXL 传输,并启动 NIXL READ 以从预填充实例中提取 KV 块。由于这些协调和设置步骤在预填充之后和解码开始之前按顺序发生,因此它们扩展了 TTFT 关键路径,如以下时间线所示。
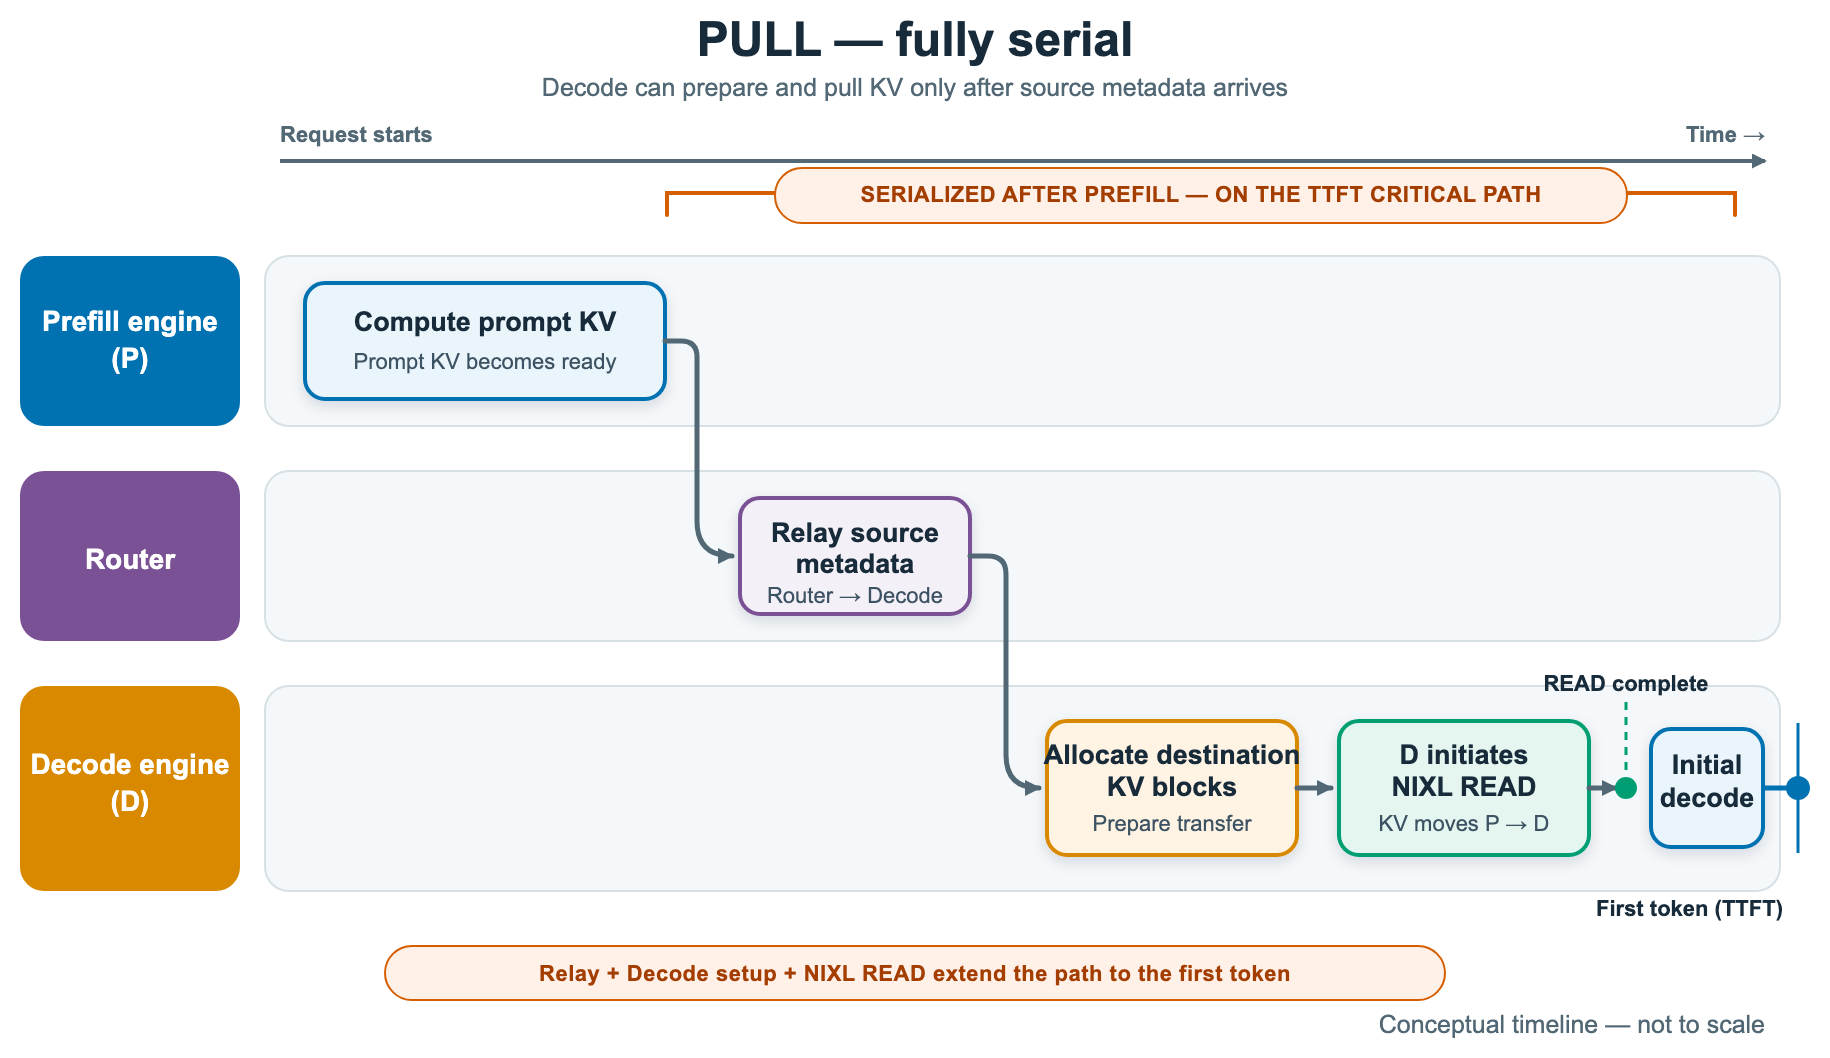
图 1:拉模式 KV 传输时间线,其中路由器中继、解码端分配和 NIXL READ 在第一个令牌的路径上串行运行
本文介绍了一种基于推送的 NIXL 连接器,该连接器可将预填充后的传输协调和设置移出关键路径。如果您使用 vLLM 运行分类预填充/解码推理,推送模式可以通过减少 TTFT 和 TPOT 来提高应用程序响应能力,特别是在高请求率时。
在我们使用与 EFA 连接的 Amazon Elastic Compute Cloud (Amazon EC2) P5en 实例进行 1P1D 部署的基准测试中,与拉取模式(请参阅性能数据部分)相比,Qwen3-32B 模型的推送模式可提供高达 3 倍的 TTFT 性能提升和每输出令牌时间 (TPOT) 提升高达 30% 的性能提升。结果取决于工作负载和配置。
我们在与 EFA 连接的 AWS Trainium 实例集群上构建并验证了该功能,然后将其作为与加速器无关的功能贡献给 vLLM。这里的结果来自具有 EFA 的 Amazon EC2 P5en (GPU) 集群,显示了 GPU 的收益。这篇文章解释了基于推送的架构、传输流、线程模型、性能结果以及如何重现基准测试。
基于推送的 KV 传输
本节介绍基于推送的设计:其架构、传输协议以及使 KV 传输远离关键路径的线程模型。
架构概述
基于推送的传输提高了 TTFT 和解码吞吐量,原因有两个:
它通过重叠生产者和消费者工作来消除拉模型的序列化。当生产者仍在计算 KV 时,解码实例提前注册其目标块。一旦生产者的区块准备就绪,传输就会开始,而不是在消费者端 ID 发现往返之后开始,从而从第一个令牌的路径中删除该往返。 它将传输设置时间移出解码实例。 该设置在预填充端和后台线程上运行。它准备 NIXL 描述符并提交传输,因此解码实例在其延迟关键的令牌生成阶段不会花费这些周期。
最终效果是解码实例上的 TTFT 更低,输出令牌吞吐量更高。
推送连接器协调三个参与者:解码实例预先注册其目标块,预填充实例匹配每个请求并发出传输,专用后台线程将 KV 写入引擎的前向传递循环。下图显示了这些部分如何组合在一起。
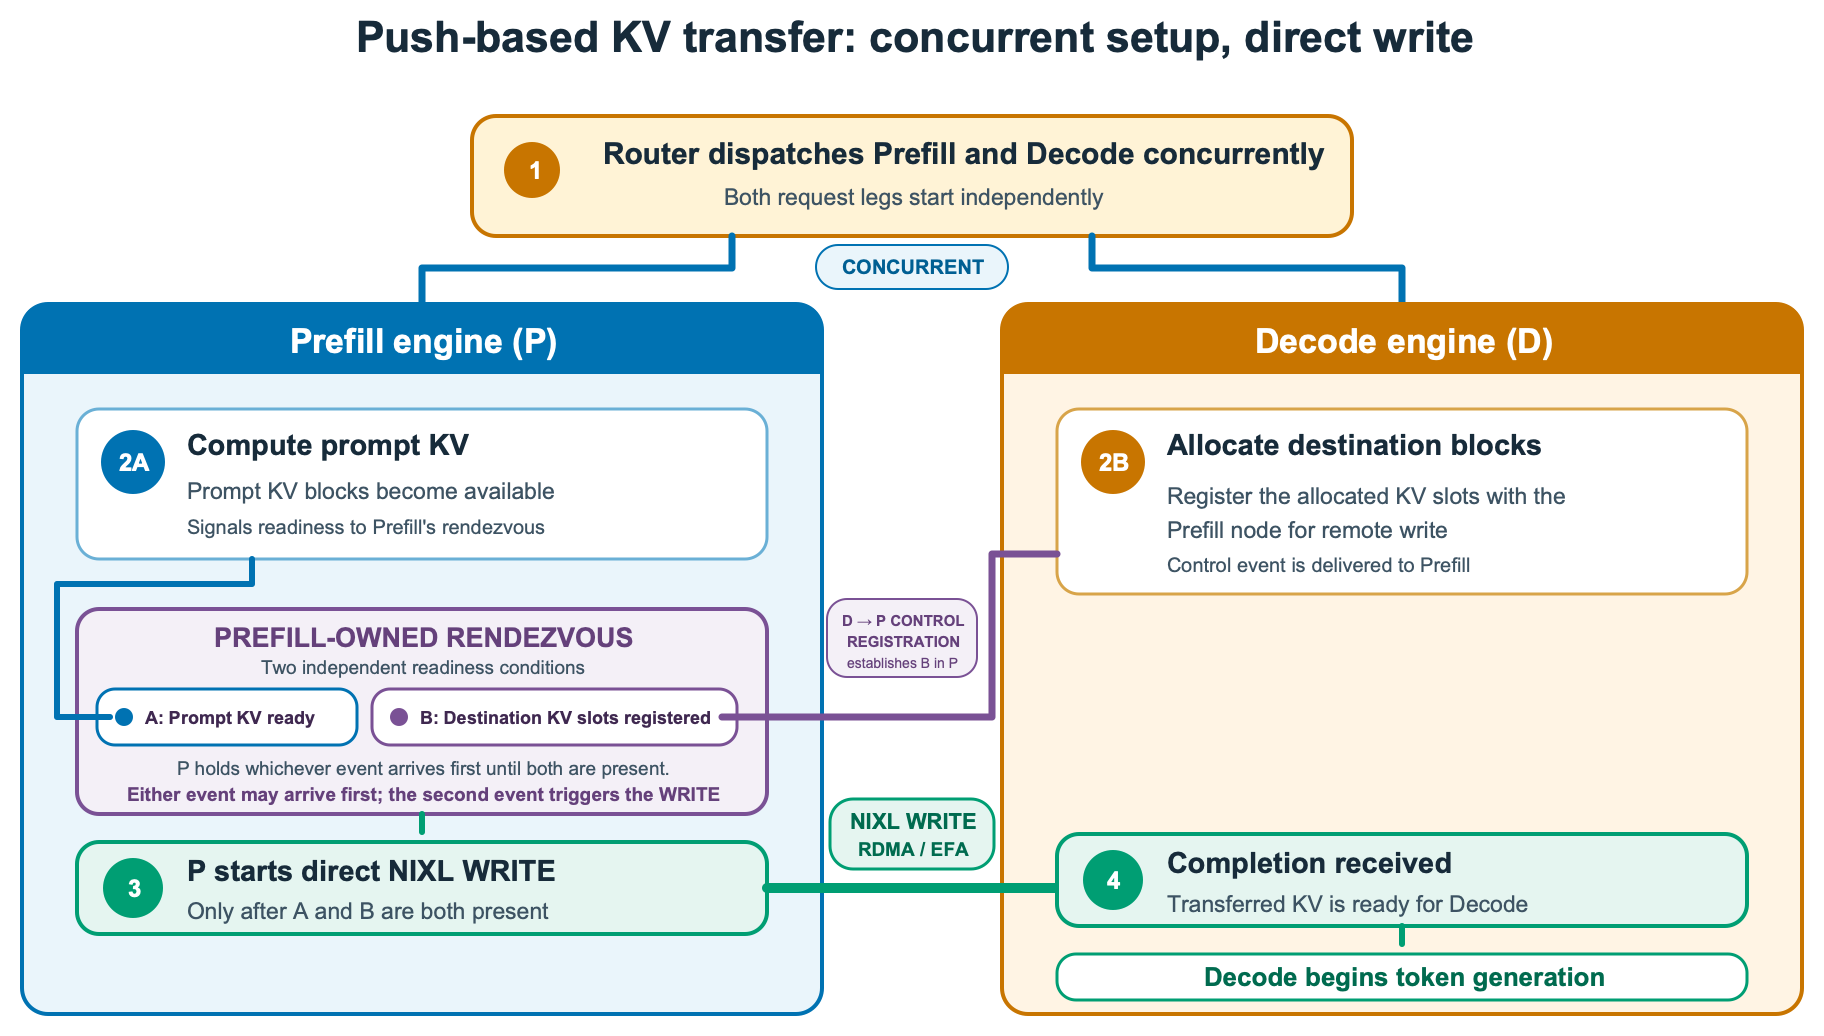
图2:基于推送的KV传输架构,展示了解码实例、预填充实例和后台传输线程如何协调
实施细节
该协议具有三个逻辑步骤。
1.注册(解码端)。 当解码实例为需要远程预填充的请求分配本地块时,它会准备一个注册,描述预填充实例应在何处写入 KV:它自己的身份和它刚刚保留的块位置。在同一引擎步骤中,工作人员将此注册作为 NIXL 通知传输到预填充实例。由于注册发生在分配时,因此连接器在预填充实例完成预填充之前就知道目标块。
- Rendezvous(预填充侧)。 来自解码器的注册和生产者上预填充的完成可以按任一顺序到达,并且连接器处理这两者。如果注册先到达,生产者将保留它,直到其自己的预填充完成。如果预填充先完成,生产者将保留请求的块,直到注册到达。无论哪个事件第二次发生都会触发传输。连接器按 ID 对请求以及重新发出请求的匹配帐户进行配对,从而正确关联抢占或重试的请求。
3.传输(预填充侧)。 一旦请求匹配,生产者就会建立与解码实例的连接(如果尚不存在)并发出 NIXL WRITE,将 KV 块直接复制到解码器的注册内存中,寻址每个目标张量并行等级。生产者和消费者可以使用不同的内部块布局。每一侧在传输时将块位置映射到其自己的物理布局,从而允许每侧有不同的块大小。每个 WRITE 都携带一个完成通知,一旦数据到达,NIXL 就会将其传递给解码实例。解码器对这些通知进行计数,每个写入其中的生产者等级一个。仅当所有预期通知到达后,它才将 KV 视为已收到,此时请求将继续进行解码。
线程模型
推送连接器通过在每个预填充工作线程上使用专用的后台传输线程,将模型执行与 KV 传输准备分开。在请求开始时,解码主循环分配其目标 KV 块并将它们注册到预填充实例,同时预填充主循环计算提示 KV 缓存。目标注册和提示 KV 准备就绪后,预填充主循环将 KV 块交给后台线程并快速返回到模型执行。
后台线程建立或重用 NIXL 连接,将请求的 KV 块 ID 映射到内存描述符,将连续块合并到更大的传输区域,并将 NIXL WRITE 提交到解码实例。当 NIXL 完成传输时,它会向解码实例发送完成通知,然后解码实例开始生成令牌。将描述符准备和传输提交远离延迟关键的主循环可以防止每个请求的工作延迟模型执行。下图显示了单个请求的主循环和后台线程切换。
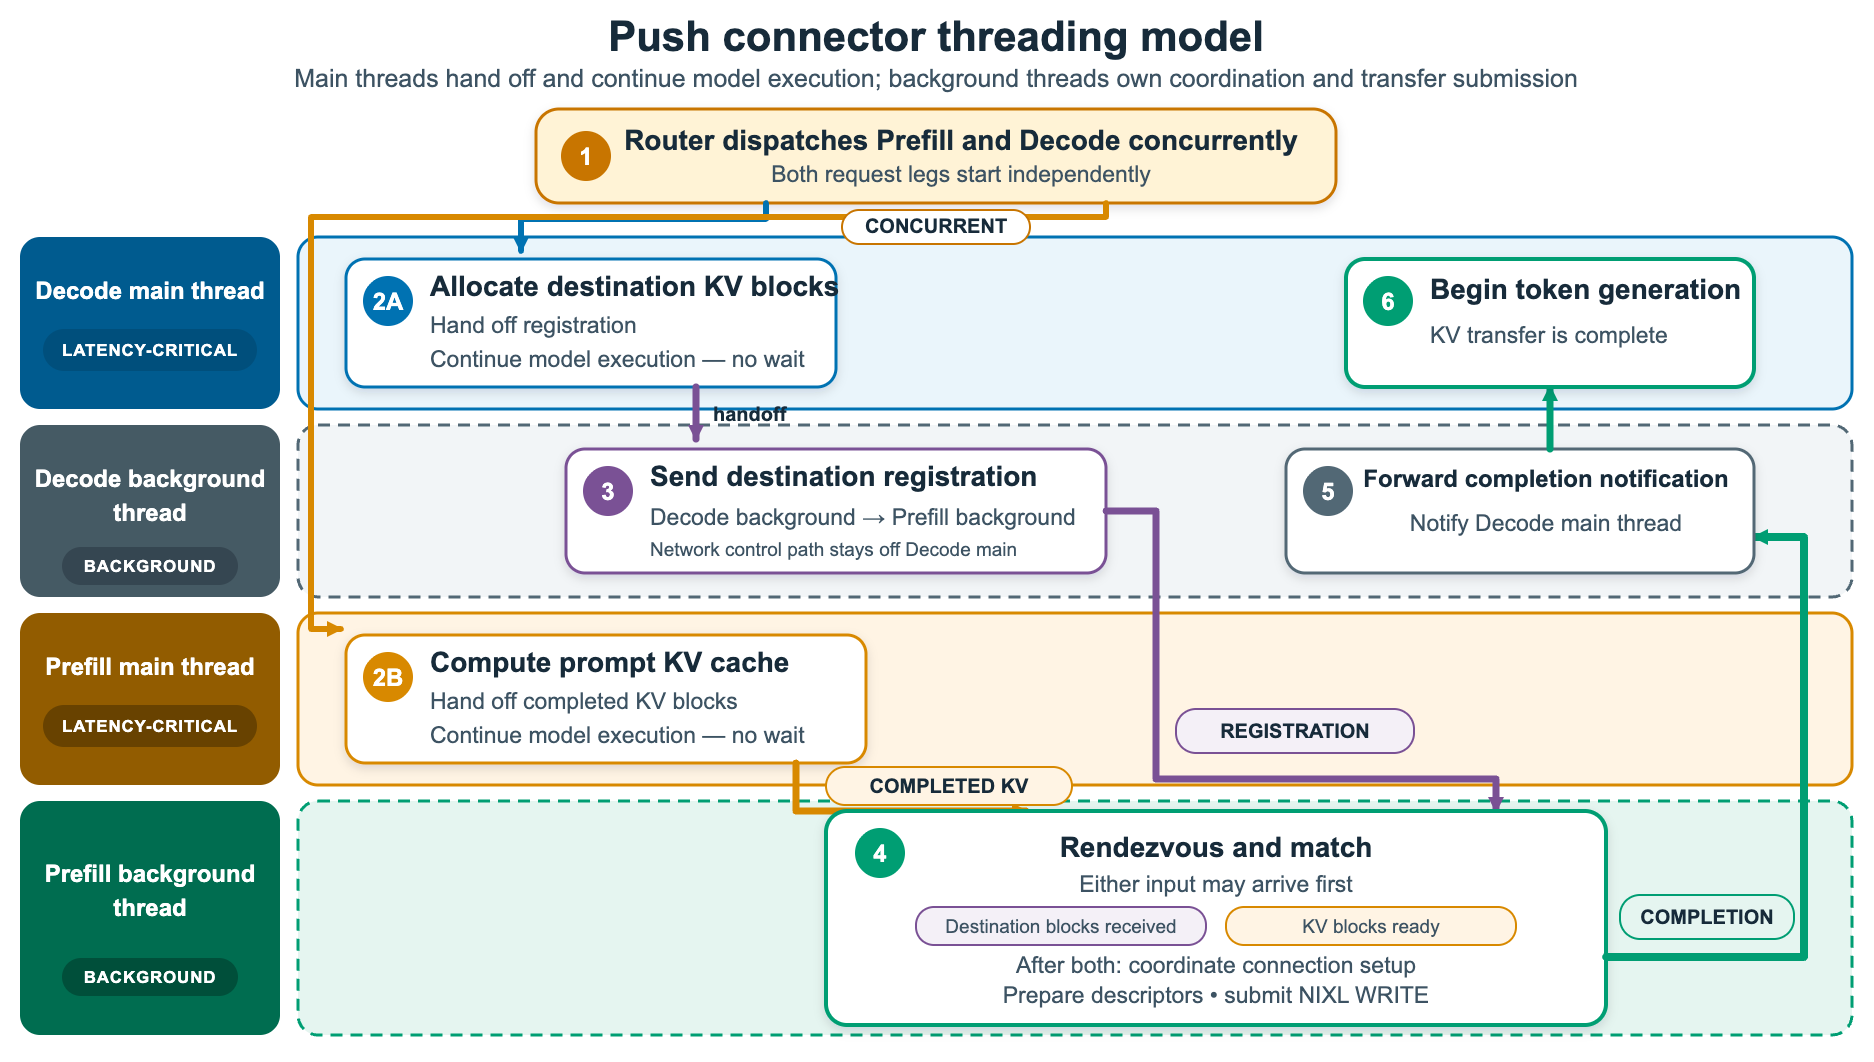
图 3:基于推送的线程模型中单个请求的主循环和后台线程切换
pull和push的时序对比
下图总结了前面几节中描述的拉式和推式传输流程,并强调了它们对 TTFT 的影响。尽管两种模式都使用相同的 NIXL 和 EFA/RDMA 数据路径,但拉取在预填充后执行元数据中继和解码侧设置,而推送则将解码侧设置与预填充重叠。因此,推送将这些操作从预填充后关键路径中删除,从而可以更快地开始解码。
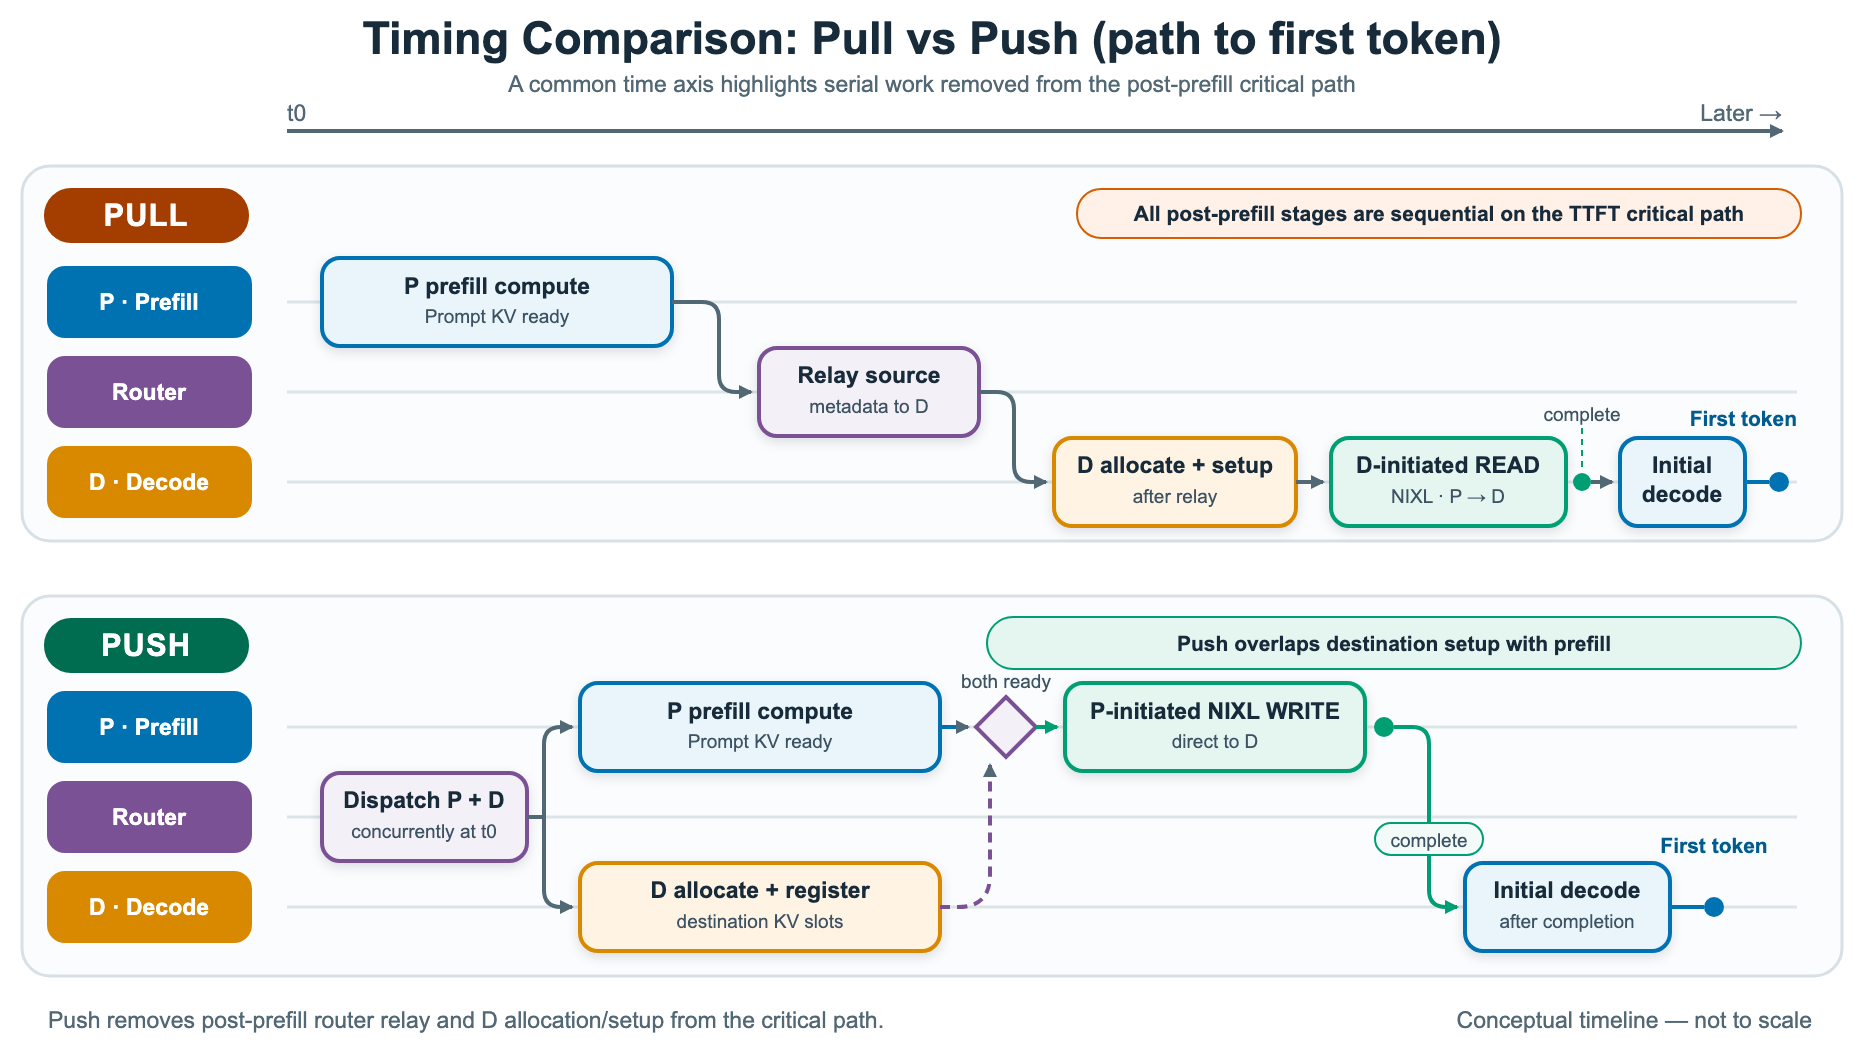
图 4:拉取和推送传输流比较,突出显示推送如何与预填充重叠解码端设置
这两种模式还涉及路由权衡。拉模式允许路由器在预填充完成后选择解码实例,这为负载感知路由和服务质量管理提供了更大的灵活性。推送模式较早选择解码实例,以便目标设置可以与预填充重叠。作为回报,在相当的负载下,预填充实例可以更快地释放其 KV 块,因为一旦提示 KV 和目的地注册准备就绪,传输就会开始。
性能数据
为了进行评估,我们在使用与 EFA 连接的 Amazon EC2 P5en 实例的 1P1D 部署上使用了 Qwen3-32B 模型。为了隔离 P→D 传输性能,我们将基准配置为使用“--no-enable-prefix-caching”禁用前缀缓存。此配置使解码节点针对每个请求从预填充节点检索完整的 KV 缓存。否则,重叠的提示可能会重用解码节点的本地缓存并绕过传输,这会产生误导性的比较结果。
下图比较了 TTFT 的推拉式 KV 传输。我们扫描输入长度 1k-16k,请求速率为每秒 1-8 个查询 (QPS)。在低负载和短提示下,两种模式的性能几乎相同。随着 QPS 和输入长度的增长,拉模式急剧下降,在 8 QPS 和 16k 时达到约 1,744 毫秒。推送模式的耗时要低得多,约为 540 毫秒,大约减少了 3 倍。间隙之所以出现,是因为拉模式在解码工作器上内联发布 NIXL 描述符,并在其引擎循环内同步,因此工作会停止令牌生成。推送模式将其移至后台线程,远离关键路径。
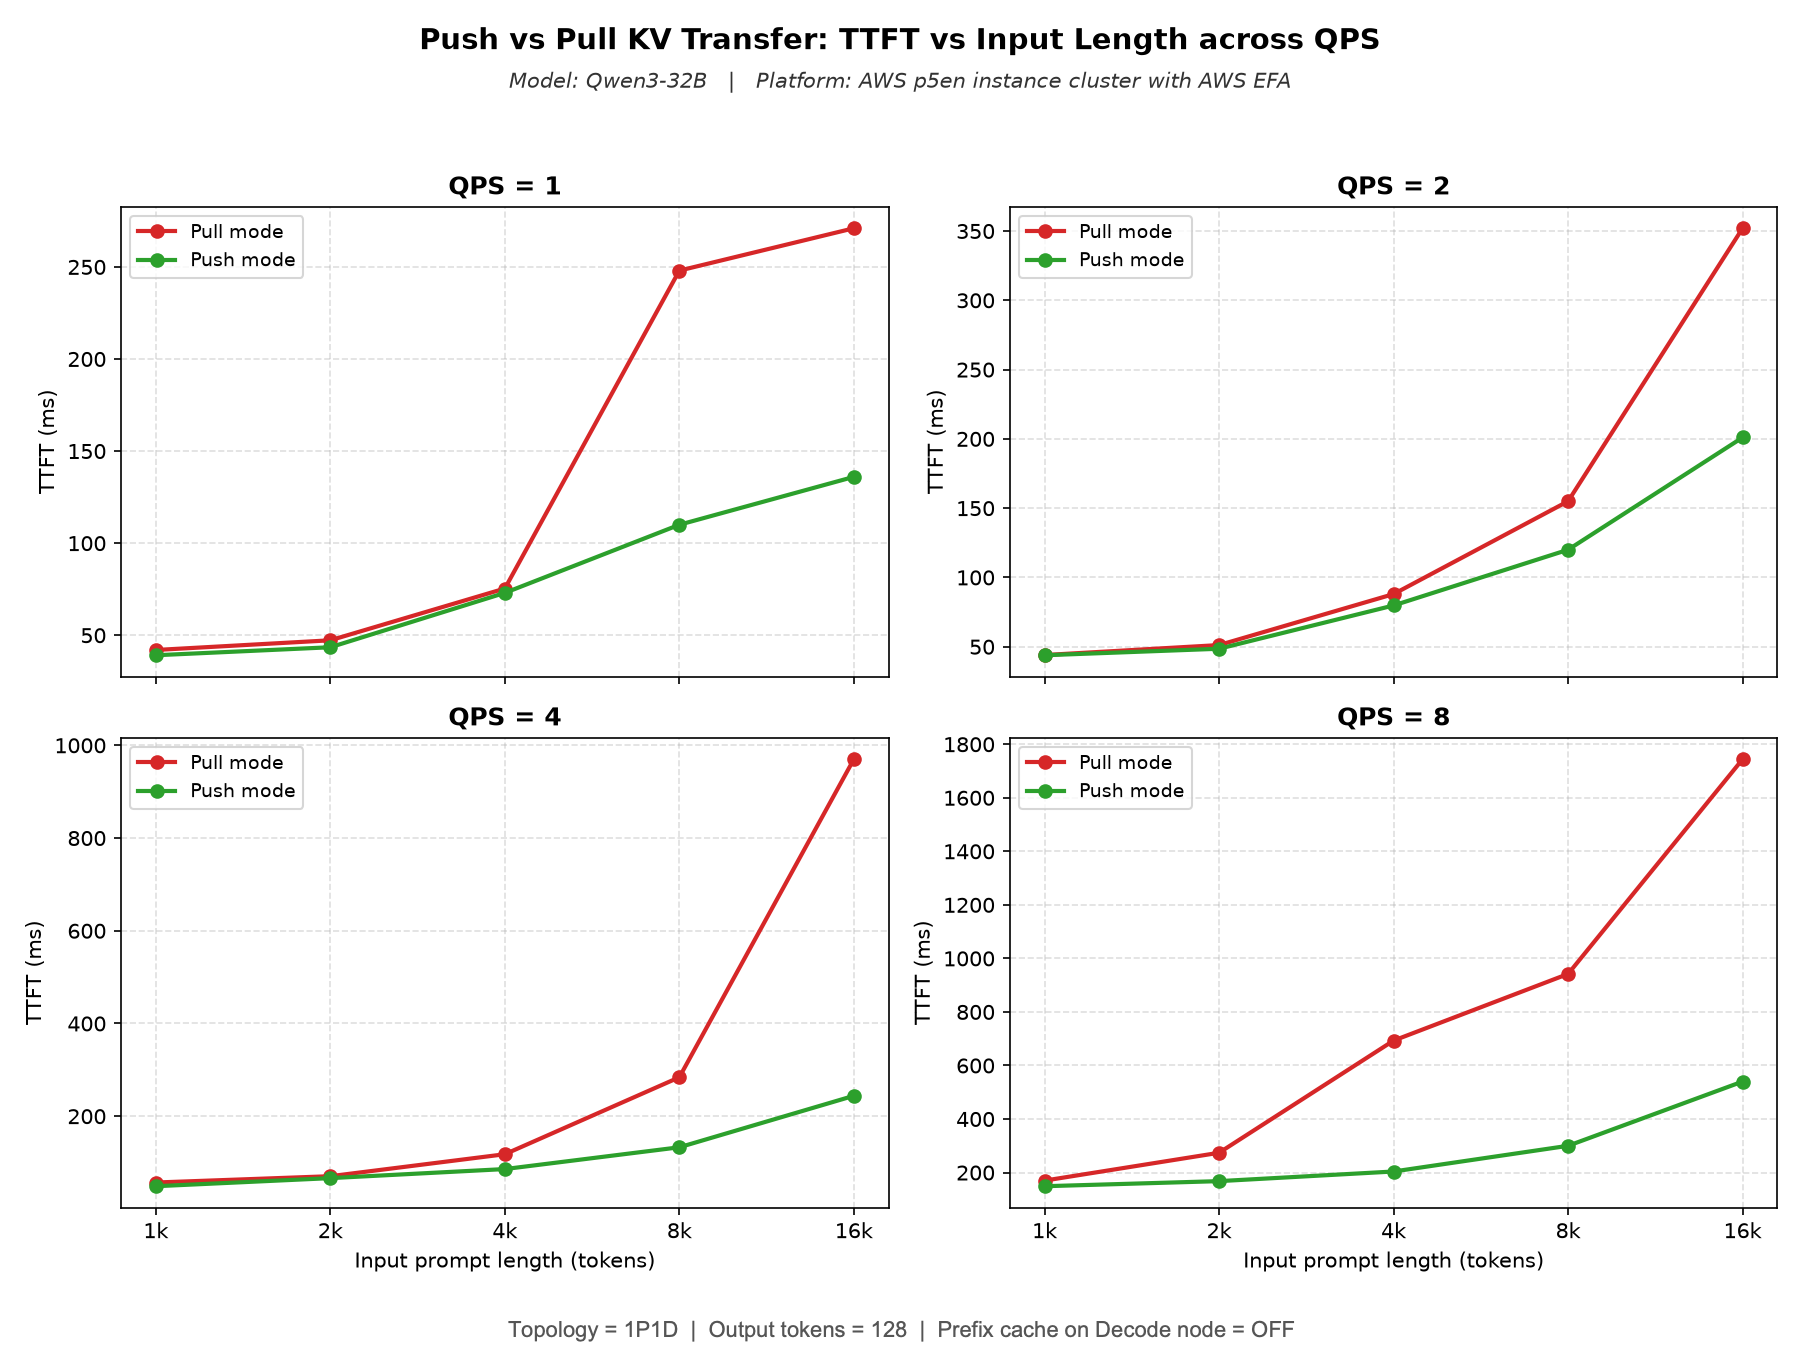
图 5:TTFT 的推式与拉式 KV 传输在输入长度和请求速率上的比较(1P1D 拓扑、128 个输出令牌、在解码节点上禁用前缀缓存)
该图显示了相同条件下的 TPOT。该图案镜像 TTFT。轻负载时,推力和拉力接近,约为 5.6–5.8 毫秒。随着负载和输入长度的增加,拉动在 4-8 QPS 和 16k 时攀升至约 10.4 毫秒,而推动则保持在 7 毫秒附近。原因是推送减轻了解码工作人员的描述符准备和传输提交的负担。令牌生成不会匮乏,因此即使在高并发和长上下文中,每个令牌的延迟也保持平稳。
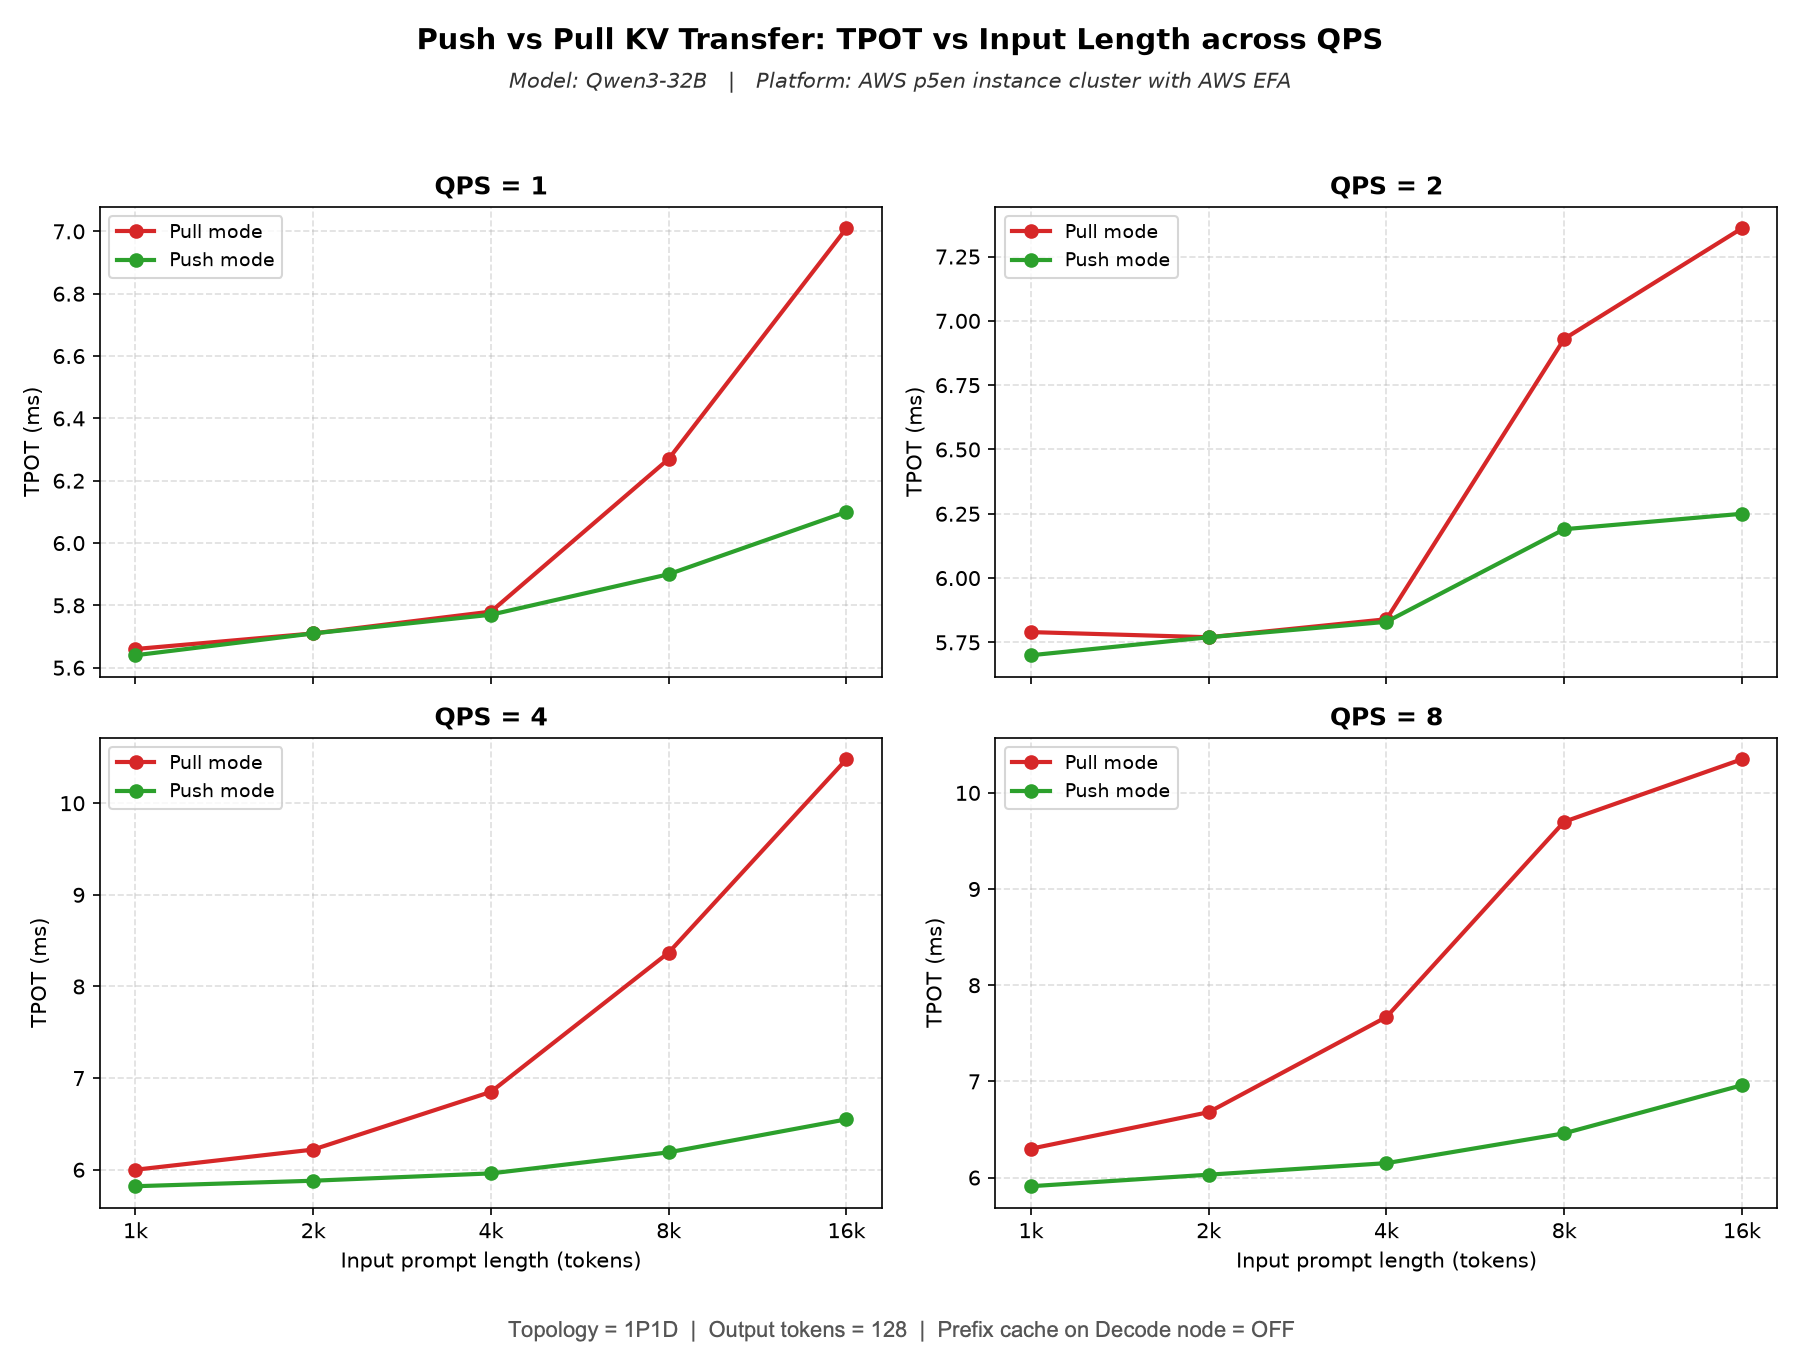
图 6:跨输入长度和请求速率的推送与拉取 KV 传输的 TPOT 比较(1P1D 拓扑、128 个输出令牌、在解码节点上禁用前缀缓存)
如何运行基准测试
要使用与 EFA 连接的 Amazon EC2 P5en 实例重现我们的 1P1D 基准配置、一个预填充节点和一个解码节点,请参阅重现我们的结果指南中的详细说明。该指南涵盖环境设置、启动 vLLM 预填充和解码服务器、运行基准测试以及收集结果。该功能可以在其他支持的配置上运行,但性能结果将根据硬件、型号、工作负载和网络配置的不同而有所不同。
结论
在这篇文章中,我们展示了基于推送的 KV 连接器如何将预填充计算与解码端块分配和注册重叠,从而从关键路径中删除后预填充路由器往返和解码端传输设置。这会减少 TTFT 和 TPOT,特别是在高请求率时。在我们使用与 EFA 连接的 Amazon EC2 P5en 实例进行 1P1D 部署的 Qwen3-32B 基准测试中,与拉取模式相比,推送模式的 TTFT 提高了 3 倍,TPOT 提高了 30%。结果因工作负载和配置而异。要使用推送模式,请将预填充和解码服务器配置为使用“NixlPushConnector”而不是“NixlConnector”。
当可以接受早期解码节点选择并且优先考虑较低的 TTFT 时,请选择基于推送的连接器。基于拉的连接器仍然更适合需要双向 KV 传输的工作负载(https://vllm.ai/blog/2026-10-12-bi Direction-kvxfer-multiturn-agentic-workload)或将解码实例选择推迟到预填充负载感知路由之后。 vLLM 支持基于推式和拉式的 KV 连接器,因此您可以选择最适合您的部署的方法。
作为未来的改进,我们正在探索将后台 NIXL 线程模型引入拉模式连接器,将 NIXL 设置移出关键路径,以便拉模式工作负载可以从相同的优化中受益。我们已经打开了一个 pull request 来探索这一点。
相关资源
vLLM 分类服务指南 AWS EFA 推送模式 NIXL KV 连接器
致谢
我们感谢 vLLM 社区对维护此功能的支持。
关于作者