在线AI教程 / AI上云
[Together AI] Polymorphic Inference:面向开放模型的自动调优推理
Polymorphic Inference:面向开放模型的自动调优推理 从今天起,你通过 Together AI endpoint 运行的许多模型,都已完全由 AI agent 优
Polymorphic Inference:面向开放模型的自动调优推理
从今天起,你通过 Together AI endpoint 运行的许多模型,都已完全由 AI agent 优化过:这是全球首个生产规模的 recursive self-improvement(RSI)推理系统。
作者:Simran Arora(SVP of Research, AI Systems)与 Dan Fu(Founding SVP of Research) 目录40+ 个被选定用于生产的模型……40+ 个被选定用于生产的模型……40+ 个被选定用于生产的模型…… 本文中的链接Together Compiler
摘要
在 Together AI,我们专注于让 AI 充裕地供给每一位个人用户和每一个组织。我们的研究团队——FlashAttention、ThunderKittens、ThunderAgent 等成果背后的研究者们——一直是我们推理卓越表现的关键驱动力。随着推理市场呈指数级增长,我们一直在思考如何放大自己的研究产能,为所有人带来充裕的智能。
这要求我们的思路从 Static Inference 转向 Polymorphic Inference——它是我们对新模型发布速度、模型架构多样性、快速变化的负载以及快速变化的硬件平台所作出的回应。在这篇博客里,我们会重点介绍 Polymorphic Inference 时代我们的研究议程——以及我们如何持续地用 AI agent,通过 Continuous Compilation 来优化它们自身的推理。
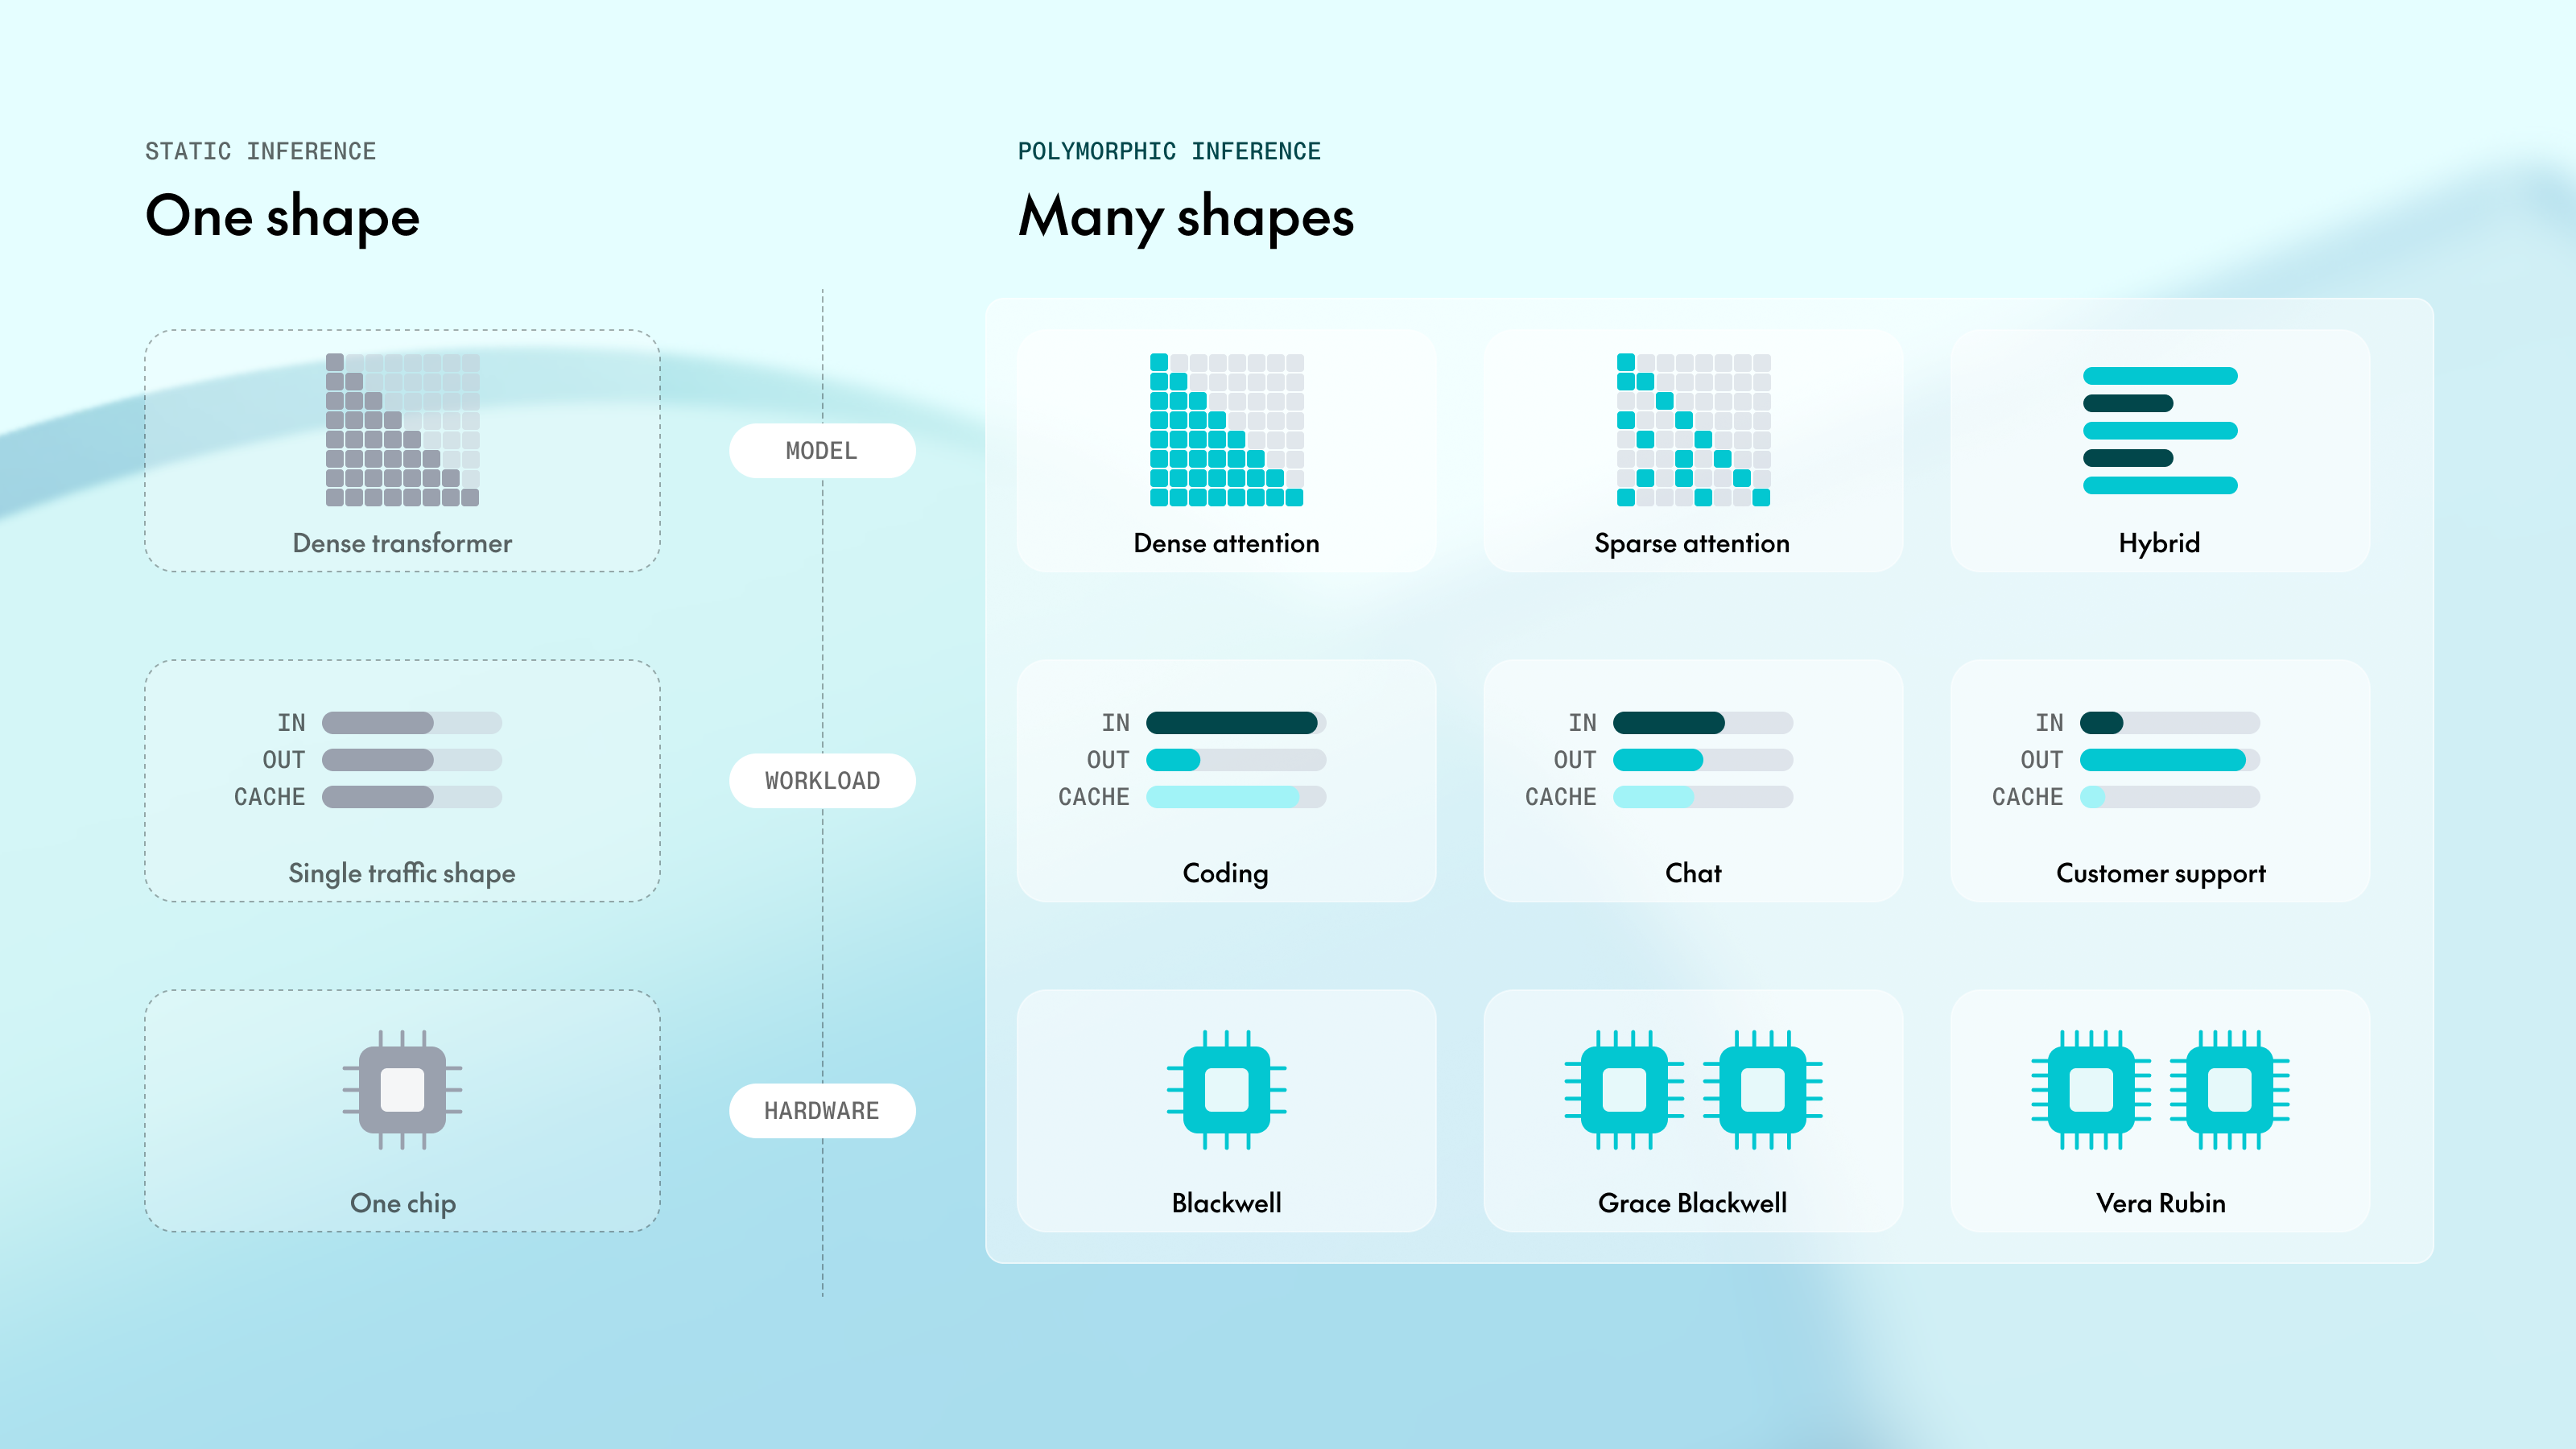
什么是 Polymorphic Inference?
过去一年里,开源模型的多样性,以及这些模型在生产环境中的部署方式,都出现了明显的阶跃式变化。我们认为这种阶跃式变化要求一种新的思路,我们把它叫作 Polymorphic Inference。
Polymorphic Inference(源自希腊语,指以“多种形态”进行的推理)是对我们在整个行业里看到的一系列变化的回应,对我们而言,它主要由几股趋势的交汇所定义:
模型发布的速度在不断加快。开源模型的推出节奏比以往更快——也远比以前多样——前所未有。OpenRouter 上 80% 的流量都流向了在最近三个月内发布的模型。 模型架构的多样性在不断增加。如今使用量排名前十的开源模型全都用着不同的架构(更不用说我们的合作伙伴所提供的众多闭源架构)。 流量形态在持续演化。我们每天都在服务新的用户、组织和地区,覆盖极为宽泛的负载形态和 SLA。harness 上的产品或算法改动、开源模型的 post-training,都可能改变流量形态(例如一次新的 post-train 让模型把更多 token 花在思考上,以此换取更高的质量)。 硬件变化得更快、更频繁。从 B200 到 GB300,我们见证了推理服务能力的大幅变化,正处于首批 Vera Rubin 部署落地的临界点上(更不用说 CPU 级优化、先进存储系统,以及其他替代性的推理芯片)。
Polymorphic Inference 就是我们对这些变化的回应——会随这些快速变化的环境而改变、而自适应的推理。
我们把它与开源推理爆发之前的世界状态对照——我们事后把那个阶段称为“Static Inference”时代。现代的 Polymorphic Inference 会呈现无穷多种不同的形态,而 Static Inference 则由闭源模型、传统 Transformer 架构、单一用户、单一硬件平台的推理所定义。
从 Static Inference 到 Polymorphic Inference
我们写这篇博客的动机之一,是眼下围绕推理系统的讨论仍然相当集中于遗留的 Static Inference 范式。
举例来说,网上典型的 vLLM、SGLang 或 InferenceX / AgentX 配方,都是用一份静态的、经过超参数调优的推理引擎配置启动的。为某一个场景优化过的 config,未必是另一个场景的最佳配置。 开源 kernel 在发布时常常假设了某些静态的流量形态与设计决策,而面对真实生产流量时这些假设可能失准。一个典型的例子是 MoE kernel:一枚在随机 token 上表现良好的 MoE kernel,未必能迁移到真实的生产场景。
这一点我们自己也要承担部分责任!很长时间以来,人们确实能写出在各种场景下都最优的 kernel。FlashAttention 是我们心头最亲近的所在,到今天它仍然是跑训练负载和许多 prefill 负载的最佳方式之一。
将近两年前,我们写过面向 AI 推理的 megakernel——那是围绕单一静态形态(例如 batch size 为 1 的 Llama 1B)煞费苦设计出的一枚单一 kernel。但通过去年把最早的一批 megakernel 投入生产、交付给我们客户的这段经历,我们学到了一个有意思的教训:对现代的 Polymorphic Inference 来说,megakernel 融合其实并不是正确的设计目标!在 Polymorphic Inference 时代,每一种变化——从模型架构(比如 MoE)到负载(大于 batch size 1 的动态负载)——都需要不同的技术路线。
为多样、快速变化的条件优化 Polymorphic Inference
在 Together,我们骨子里是系统和 AI 研究者——所以我们把这看作一个无比令人兴奋的时刻,值得为这个光明的新未来重新思考我们的研究议程。
那么,当你的生产流量变得愈发多样时,解法是什么?让 AI agent 来优化它们自己。这就是 OSS 模型的 RSI 时刻!
要实现 Polymorphic Inference,需要我们解决模型服务方式上的诸多技术挑战。理想的 Polymorphic Inference 体验,应当能够回应模型架构与负载格局的快速变化。
例如:
如果你的流量形态发生了变化——无论是产品改动还是用户行为改变——你就应当期待自己的推理系统能快速适应。 如果你正在一个新模型上部署负载——你就应当期待你的推理服务商尽快逼近人工精调的理想基线。 如果你已经有一款用户流量稳定的产品,并把它部署到新的硬件平台上——你就应当期待性能尽快逼近硬件的边界。
这些目标很宏大,但我们相信它们值得努力。对我们来说,实现这些目标的关键之一,是让 AI agent 帮忙优化它们自己。OSS 模型的 RSI 循环已经到来!
用 Together Compiler 实现 Continuous Compilation
作为迈向 Polymorphic Inference 目标的第一步,我们今天发布的项目之一就是 Together Compiler, 一条快速的、由 AI 驱动的性能优化 RSI 循环。如今,Together Compiler 正在我们许多顶级生产推理负载上驱动 Continuous Compilation 优化循环。
Together Compiler 把优化推理负载这一经典挑战,从传统的编译器翻译问题重构成了一个 agent 搜索问题。Together Compiler 识别出一组核心的关键优化模式,并把一群 agent 与一个高保真的 persistent engine 配对,以进行快速迭代。这项工作是 Together 的 Frontier Performance 团队数月努力的结果,其中 Reyna Abhyankar 与 Dylan Lim 的贡献尤为突出!
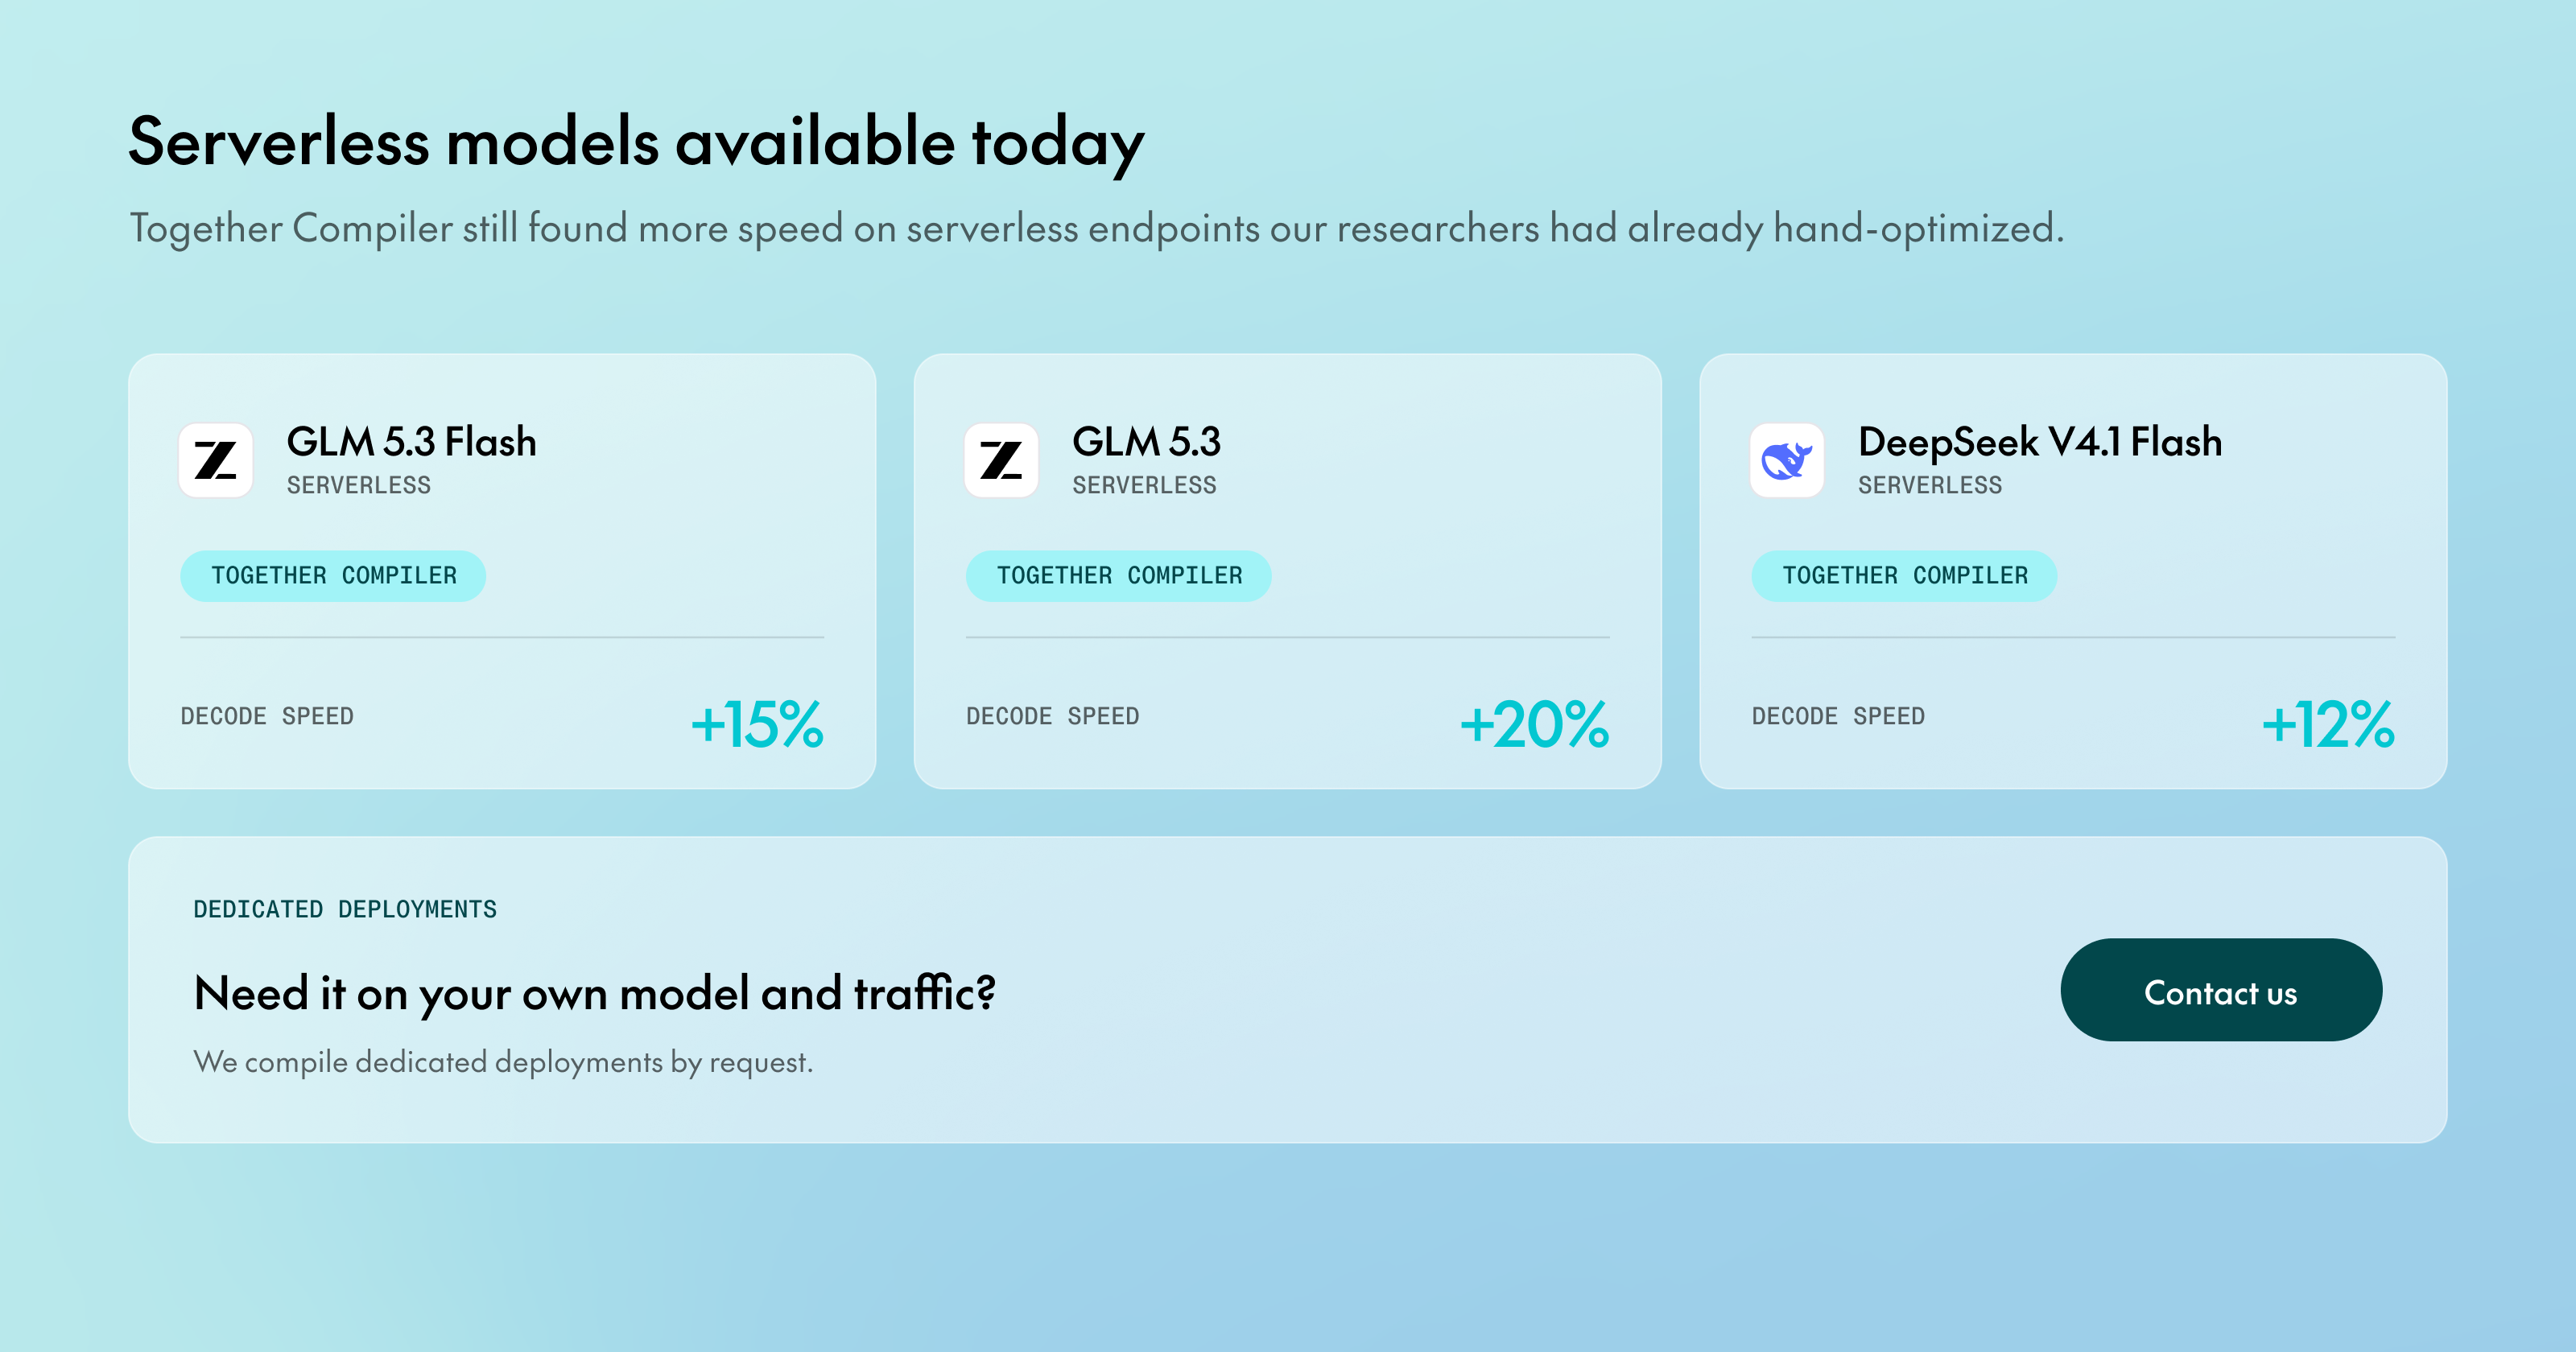
Together Compiler 如今已经在生产环境中运行,支撑着我们一些最受欢迎的 serverless endpoint,并在本就高度优化过的代码之上进一步找到了增益。
令人兴奋的是,Together Compiler 让我们能够快速适应快速变化的模型架构与流量负载。我们把这种能力称为 Continuous Compilation。过去,新的负载意味着一批全新手写的 kernel 和优化;而由 Together Compiler 驱动的 Continuous Compilation,意味着我们可以自动适应新的流量形态和负载。
Together AI 研究团队接下来会带来什么
在把 Together AI 扩展到每天服务数万亿 token 的过程中,我们学到了太多(十月初,我们甚至在 OpenRouter 上服务的 token 数首次超过了闭源模型实验室!)。这些经历塑造了我们在 Polymorphic Inference 时代的愿景和研究议程。以下是我们研究议程上几项工作的一点预告:
Together Compiler 的自助式 Continuous Compilation
性能优化需要成为负载部署本身的函数:模型、engine、流量形态以及客户的使用场景。很快,我们的客户就能一键使用 Together Compiler,针对自己独特的负载优化他们的 dedicated endpoint。
Together Compiler 今天已面向终端客户开放小规模 beta——想要提前体验请联系我们!
随形态而变的 speculative decoding
开源仓库中提出的推理引擎配置——VLLM、InferenceX、AgentX——都以一个固定的 speculative decoding draft model 和 lookahead 参数来启动 engine。Speculative decoding 需要按领域、按请求、按 token 自适应,并且要作为流量负载的函数来调整。
ThunderAgent Router:在异构部署之间做路由
Serverless 推理 endpoint 要服务海量用户,每个用户都带着自己的流量形态和 SLA。这种异构性要求我们在集群范围内,跨 worker、跨部署配置动态地路由请求。我们发表了 ThunderAgent 作为 ICML 2026 的 Spotlight 论文,分享了一些早期洞见,并在生产中把这些基础做了扩展。
Together Post-Training
如今有几家客户希望把开源模型 backend 接入自己的 AI 应用。这需要选一个开源模型,针对客户具体的 tool calls 和使用场景挑选并定制 harness,再对模型做 post-training,让它与这套 harness 良好配合。我们与 Moonshot、Minimax 等模型实验室保持着紧密的合作关系,这让我们能够帮助客户针对自己的使用场景定制开源模型,真正把智能技术栈握在自己手里。
TogetherLink:感知负载的模型路由
随着 OSS 模型不断进步,一个关键环节是把它们交到每个人手中。普遍的认知是,像 Opus 5.5 这样的闭源模型总是最好的。但正如 AI 的历史一再向我们展示的,把几个相当好的模型做 ensemble,只要组合方式得当,完全可以胜过一个单独的强大模型。这部分工作植根于我们在 Stanford 的 Hazy Research Lab 做 weak supervision 的源头(Ask Me Anything),也建立在我们自己关于模型组合的工作之上(Mixture-of-Agents,ICLR 2025)。
为所有人带来充裕的智能
推理是 AI Systems 中最迷人的问题之一,而我们所服务的规模让我们解锁了一整批全新的洞察。要实现让 AI 对每个人都充裕可得这一目标,在 Polymorphic Inference 时代,我们的推理系统就需要持续地为每一位用户、每一份负载做定制。我们很兴奋能帮着把这闭环扣上,在让 AI 系统真正做到 recursive self-improving 的进程中扮演一个小小的角色。
如果 Polymorphic Inference 背后的理念让你的组织、你的使用场景有所共鸣,请联系我们以获取提前体验——我们很乐意帮你应对这些新的复杂性。
最后——如果你想和我们一起携手应对 Polymorphic Inference 的挑战,请看看我们的招聘页面——我们正在招人!
相关文章