在线AI教程 / AI上云
[Amazon Bedrock] 端到端管理 Amazon Bedrock 成本:FinOps 和平台团队的手册
端到端管理 Amazon Bedrock 成本:FinOps 和平台团队的手册 生成式 AI 的成本管理,是构建应用的团队与为云支出负责的团队共同承担的责任。许多团队一开始会去比较
端到端管理 Amazon Bedrock 成本:FinOps 和平台团队的手册
生成式 AI 的成本管理,是构建应用的团队与为云支出负责的团队共同承担的责任。许多团队一开始会去比较各 model 的 token 费率,并要求应用团队精简 prompt。这些做法有帮助,但并不能回答使用量增长时财务和工程负责人会问的问题:是哪个团队花的这笔钱、花在哪个 workload 上,以及这笔支出是否在获批的预算之内?
Agentic workload 让这些问题更加紧迫。一个对话式助手通常每个用户回合发起一次 model 调用。而一个 agentic 工作流——比如会规划改动、读取文件、调用工具并反复迭代的 AI coding assistant——每个任务会发起多次调用,且每次调用都携带更大的 context。因此 token 消耗量随着你授予该工作流的自治程度以及它携带的 context 大小而增长,而不是随着用户交互的次数增长。由于消耗量是 workload 设计与运营方式的函数,生成式 AI 的成本管理是一门架构与运营上的纪律。公开的平均值无法替代你自己的数字:用 AWS Pricing Calculator 和 Amazon Bedrock pricing page 来建模费率,并用本文第 2 步来测量你的 workload 实际消耗了多少。
解决办法不是换一个更便宜的 model,也不是缩短 prompt,而是一种运营模型:一个可重复的闭环——把每一美元都归属到某个负责人、让每一次 request 都可观测、在超支累积成问题之前对预算发出告警并强制执行、优化那些造成大部分浪费的平台默认设置,并按固定节奏审视整个系统。
在本文中,你将学习如何用五个步骤管理 Amazon Bedrock 成本。你会把每一美元归属到负责人、让每一次 request 可观测、用预算和强制手段控制支出、优化那些造成大部分可避免支出的平台默认设置,并运营一个把数据变成决策的审视节奏。这套方法由 AWS 的构建块搭建而成,你可以定制它并应用到自己的环境中。本文面向两类读者:负责归属、成本回收、预算和异常审视的 FinOps 从业者,以及负责日志、request 元数据、强制执行和路由默认设置的平台工程团队。
一张图看懂运营模型
五个阶段,作为一个闭环运行。归属:每一美元 Amazon Bedrock 支出在计费管道中都落到某个身份、团队和应用上。观测:每一次 request 都记录足够的 metadata,以说明是什么产生了这笔支出。强制:预算要有约束力,至少要能告警,在风险要求的地方施加硬性阻断。优化:平台默认设置(model 路由、缓存、token 上限)集中地消除浪费,而不是要求每个团队都小心翼翼。运营:一张精简的记分卡加上一个审视节奏,把数据变成决策。FinOps 主导第一和第五阶段,平台工程主导第二到第四阶段,审视则由双方共同进行。各阶段的排序是刻意安排的:每一阶段都依赖它前面的阶段,而跳过归属和可观测性、直接去做优化的团队其实是在瞎猜。
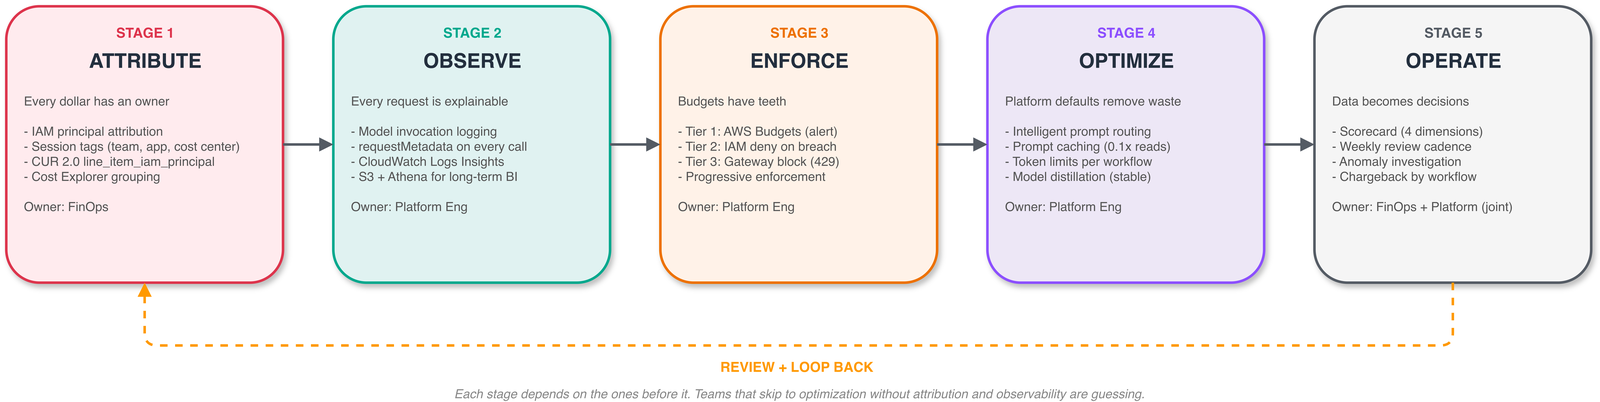
图 1:五阶段运营模型,作为连续闭环运行
第 1 阶段:把每一美元都归属到位
无法归属的,就无法管理,而下游的一切(成本回收、预算、强制执行、异常检测)都依赖这一阶段。其基础是 Amazon Bedrock 的细粒度成本归属(参见 Introducing granular cost attribution for Amazon Bedrock):Amazon Bedrock 会自动把推理成本归属于发起调用的 AWS Identity and Access Management (IAM) principal,覆盖所有 model,且无需管理任何资源。调用者的 ARN 会落在 AWS Cost and Usage Report (CUR) 2.0 的 line_item_iam_principal 列中,覆盖范围包括 IAM users、roles、federated identities 以及 API keys。
配置分四步:
在 CUR 2.0 的数据导出中开启 IAM principal 数据。 用团队、应用、成本中心等业务维度给你的 IAM principals 打标签。对于联邦访问,配置你的身份提供商,让它通过 OIDC 或 SAML claims 传递 session 名称和标签。 在 AWS Billing 中把这些标签激活为成本分配标签(通过控制台或 UpdateCostAllocationTagsStatus API)。 分析这些标签:它们会带着 iamPrincipal/ 前缀出现在 CUR 2.0 中(例如 iamPrincipal/team),并在激活后 24–48 小时内出现在 AWS Cost Explorer 的 IAM 类别下,可用于按团队、应用或成本中心进行筛选和分组。
这是发票级、按身份的归属,且无需任何自建基础设施。
共享角色问题
最值得关注的模式是共享角色问题,因为它是多数平台在无声无息中丢失归属的地方。一个通过单一 IAM 角色调用 Amazon Bedrock 的大语言模型 (LLM) gateway,会把每一美元都归到那一个角色上,从而彻底消除按用户的可见性。解决办法是按用户管理 session。gateway 为每个用户 assume 一次 Amazon Bedrock 调用角色,把该用户的身份作为 role session 名称、把其属性作为 session 标签传进去,然后把这些凭证缓存至多一小时(即每个用户每小时一次 AWS Security Token Service (AWS STS) 调用,而不是每次 request 一次)。
这需要两个角色:一个持有 sts:AssumeRole 和 sts:TagSession 权限的 gateway 执行角色,以及它所 assume 的 Amazon Bedrock 调用角色。结果是形如 assumed-role/BedrockRuntimeRole/gw-alex 的 line_item_iam_principal 条目,每条都带着其用户的标签:在共享 gateway 之后重新恢复了按用户、按租户的归属。
import boto3
sts = boto3.client("sts")
One call per user; cache the returned credentials up to 1 hour
response = sts.assume_role( RoleArn="arn:aws:iam::123456789012:role/BedrockRuntimeRole", RoleSessionName="gw-alex", # the user, not the gateway Tags=[ {"Key": "team", "Value": "sales-ai"}, {"Key": "application", "Value": "renewal-agent"}, {"Key": "costCenter", "Value": "CC-2041"} ] )
关于 application inference profiles 和 Projects 的说明
Amazon Bedrock 还提供了另外两种归属机制,各自适合不同的模式。Application inference profiles 是在 bedrock-runtime endpoint 上预先创建、按应用维度的资源,带有成本分配标签。你要为每个应用、每个 model、每个 AWS Region 各创建一个 profile,调用者引用该 profile 的 ARN——这适合应用和 model 集合小而稳定的团队。Projects and workspaces 服务于 bedrock-mantle endpoint(Responses API、Chat Completions API)。一个 project 不绑定到某个特定 model,所以单个 project ID 可以横跨许多 model,这适合 model 使用经常变化的团队。你在客户端初始化时传入 project ID,其标签会流向 CUR 2.0 和 Cost Explorer(参见 Manage AI costs with Amazon Bedrock Projects)。对于 Amazon Bedrock 上 OpenAI 兼容的 workload,Projects 就是归属路径。
对于 bedrock-runtime workload,我们推荐把「通过 session 标签实现的 IAM principal 归属」作为主要机制。它随你的身份系统一起扩展、无需预先创建资源,并覆盖所有 model 和 API 操作。当一小撮稳定的业务单元需要发票级的账单分离、又不想改动身份设计时,application inference profiles 很合适。对于使用 Responses API 或 Chat Completions API 的 bedrock-mantle workload,则使用 projects。
第 2 阶段:让每一次 request 都可观测
CUR 告诉你谁花了钱,调用日志则告诉你发生了什么。Amazon Bedrock 支持把 request 数据、response 数据和 metadata 进行 model invocation logging,输出到 Amazon CloudWatch Logs、Amazon Simple Storage Service (Amazon S3) 或两者皆可。用 Amazon CloudWatch 做快速运维查询,用 S3 加 Amazon Athena 做长期的商业智能 (BI) 访问。要把日志当作基础设施,而不是一个手动开关:用代码来置备日志组或存储桶,定义留存与加密策略,并在环境搭建阶段就验证投递。如果日志只存在于开发环境、或只存在于某个 Region,那么使用量一增长,你的成本计划就会变得支离破碎。
日志还能填补延迟上的缺口:CUR 归属大约有 24 小时延迟,而 CloudWatch 加上 OpenTelemetry 可以驱动近乎实时的仪表盘,在几分钟内显示按开发者的支出(Analyzing Claude Code usage with CloudWatch and OpenTelemetry 端到端地演示了这一点)。
用 request 元数据实现 workload 级归属
原始日志能回答身份级的问题。要回答 workload 级的问题(是哪个功能、工作流或租户产生了这些 token),要在每次调用上都打上 request metadata。Amazon Bedrock 会把这份 metadata 记录进调用日志,供后续分析:
下面的示例通过美国跨 Region 推理配置,使用 Amazon Bedrock 上的 Anthropic Claude Sonnet 5.5。完整 model 列表见 Supported foundation models in Amazon Bedrock。按 Region 的可用性见 Model support by AWS Region in Amazon Bedrock。
response = client.converse( modelId="us.anthropic.claude-sonnet-5-5", messages=[...], requestMetadata={ "application": "renewal-copilot", "workflow": "renewal-risk-summary", "tenant": "enterprise-sales", "agent": "renewal-agent" } )
Amazon Bedrock 不会强制校验 request metadata,一旦每个应用各行其是,各团队很快就会漂移到互不一致的 schema 上。平台团队应当在一个共享的 SDK wrapper 或 gateway 中集中注入强制性的 metadata,统一 key 集合,并把 metadata 覆盖率当作一项平台健康指标来对待。
诊断查询
有了日志和 metadata,CloudWatch Logs Insights 就能回答那些长期存在的问题。谁消耗的 token 最多:
fields , identity.arn as caller, modelId, input.inputTokenCount as inTokens, output.outputTokenCount as outTokens | stats sum(inTokens + outTokens) as totalTokens, count(*) as calls by caller, modelId | sort totalTokens desc | limit 25
把同一个查询改为按 requestMetadata.application 和 requestMetadata.workflow(而不是 caller)分组,就得到 workload 级的排行榜:一旦成本回收的讨论开始,产品和工程团队第一时间就会向 FinOps 索要这个视图。
注意: 上述查询中展示的字段路径仅为示例。请对照你自己的调用日志 schema 进行核验——它会因 model、API 操作和日志配置的不同而有所差异。
第 3 阶段:强制执行预算
有了归属和可观测性,强制执行就成了一个架构选择,而非一厢情愿。它有三个可行层级,选哪个取决于你的支出速度、对超支的风险容忍度,以及你的工具是如何连接 Amazon Bedrock 的。
层级 1:监控与告警(不阻断)
Amazon Bedrock 会自动把 principal 身份写入计费管道。你在其上叠加 AWS Budgets 来做阈值告警,并用第 2 阶段的 OpenTelemetry 仪表盘来弥补 CUR 那 24 小时的空档,以获得日常可见性。无需部署任何东西、使用 AWS 原生计费、且不给推理调用增加任何延迟。它对直接调用 Amazon Bedrock 的工具同样有效。但没有任何东西能硬性阻断支出,所以你只能在问题发生之后才看到它。它适合早期采用阶段——此时告警加人工干预已经足够。两份 builder 指南会带你走一遍:Limiting Bedrock usage and controlling costs,以及 Deep dive on managing Bedrock in Claude Code with AWS Budgets and Tags。
层级 2:IAM 标签强制(越界即拒绝)
一个聚合型的 AWS Lambda 函数根据调用日志数据,在 Amazon DynamoDB 中累计按用户的 token 与金额计数器。当某个用户突破其阈值时,该函数就把这个身份加入一份共享的 IAM 拒绝策略(拒绝 bedrock:*),直到每月重置或管理员手动覆盖为止。这套强制完全建立在 IAM 和 Amazon Bedrock 日志之上,推理路径中不引入任何第三方组件,对直接调用 Amazon Bedrock 的工具同样有效。AWS Solutions Library 里的 Guidance for Claude Code with Amazon Bedrock 提供了一个可部署的变体:它在发放凭证时,把每个用户的用量对照按用户、按团队的上限做检查,一旦用户超限就扣发凭证。由于该检查用的是客户端发出的用量遥测数据,其数字可能与 CUR 有出入。无论哪种形式,强制执行都是异步的:对 IAM 策略更新而言,阻断会在越界调用之后数秒到数分钟生效;对凭证检查而言,则在下次凭证刷新时生效。这条管道由你的平台团队负责。这一层级适合那些确实需要强制手段、能容忍这种延迟,又想把第三方软件挡在数据路径之外的团队。
层级 3:Gateway 强制(同步阻断)
gateway 位于推理数据路径之中,同步地强制执行预算:一旦某个用户或团队超过其上限,立刻返回 HTTP 429。你能得到亚秒级阻断、按用户的 model 允许列表、token 速率限制,以及集中强制执行的路由规则。代价是:数据路径里多了一个组件,它必须被部署、扩缩并做安全评审;客户端也必须配置成经由该 gateway 发送 request。
对于 Claude Code 和 Claude Desktop 的规模化部署,官方推荐是 Claude apps gateway for AWS。它随 CLI 二进制文件一同分发,以单个无状态容器运行,后端由 PostgreSQL 支撑。它开箱即用地提供 OIDC 身份、集中管理的策略、OpenTelemetry 遥测、跨多 Region 的 Amazon Bedrock 路由,以及按用户/群组/组织的支出上限。对于横跨多个 provider 的混合 model workload,通用型 gateway 仍是正确选择:通过 Amazon Elastic Container Service (Amazon ECS) on AWS Fargate reference architecture 使用 LiteLLM,或采用 Build a proactive AI cost management system for Amazon Bedrock, Part 2 中描述的 serverless 替代方案。
如何选层级
有两个因素起决定作用。
连接方式: 如果开发者不经任何代理直接调用 Amazon Bedrock,那么只有层级 1 和层级 2 可行。
支出速度: 如果每月支出已经达到数百万美元,那就立刻着手建设强制手段。如果靠告警还能再守住一个季度,就先投入第 1、第 2 阶段,等数据提出要求时再加上强制执行。
多数组织应当分阶段推进:先在层级 1 做观测,再逐级上抬。把这三个层级都当作过桥而非终点:Well-Architected Agentic AI Lens 已经把 agent 成本治理固化为一项一等架构关注点,而第 1 阶段打下的归属基础,正是任何托管式强制手段将要坐落其上的地基。
第 4 阶段:优化默认设置
Amazon Bedrock 的大部分浪费并非源于个人的疏忽,而是源于无人设定的平台默认值。影响最大的两个杠杆都由平台掌控。
Model 路由
并非每个任务都需要前沿 model。常规补全(样板代码、linting 建议、小型重构)可以跑在更小、更便宜的 model 上,把质量留给复杂推理——通过同一 model 家族内的 intelligent prompt routing,或在 gateway 层设置路由规则(完整演练见 Reduce costs and latency with Amazon Bedrock Intelligent Prompt Routing and prompt caching)。哪些工作流可以「降档」是个经验问题:把第 2 阶段的 workload 排行榜拉出来,对排名靠前的条目在更便宜的 model 上跑一次质量评估,把通过的流量路由过去。对于 agentic coding 的规模化部署——样板代码占了调用量的大头——让超过一半的调用落到更便宜的 model 上,是一个可达成的目标。
Prompt 缓存
prompt 缓存奖励稳定、重复出现的前缀。截至 2026 年 10 月,公开的 Amazon Bedrock pricing 对 US East (N. Virginia) 的 Anthropic Claude models 定价如下:在 5 分钟存活时间(TTL)下,一次 cache 写入按基础 input 费率的 1.25x 计费(1 小时 TTL 则为 2x);一次 cache 读取,Claude Sonnet 4.6 和 Claude Haiku 4.5 按基础 input 费率的 0.1x 计费,Claude Sonnet 5.5 和 Claude Opus 5.5 按 0.05x 计费。请对照你的 model 和 Region 查看定价页,因为这些倍率因 model 而异,且可能变动。盈亏平衡的算术比团队以为的更友好:在 5 分钟 TTL 下,一次复用就已抵回了写入成本;而对一个稳定前缀发起十次调用,其花费大约只有未缓存价格的五分之一(在 0.1x 读取费率下约为 22%,在 0.05x 下约为 17%)。唯一亏本的情形是那些从未被重新读取的写入——在 5 分钟 TTL 下它们多花 25%,在 1 小时 TTL 下则翻倍。因此平台仪表盘应按每个工作流跟踪 cache 读取量与 cache 写入量的比值:读取占比偏低,说明前缀其实并不稳定(通常是某个时间戳或 session ID 被嵌在了缓存点之前)。
可以从调用日志中直接筛出候选对象:
fields requestMetadata.workflow as workflow, modelId, input.inputTokenCount as inTokens | stats count(*) as calls, avg(inTokens) as avgInputTokens, sum(inTokens) as totalInputTokens by workflow, modelId | filter calls > 50 and avgInputTokens > 2000 | sort totalInputTokens desc | limit 25
注意: 上述查询中展示的字段路径仅为示例。请对照你自己的调用日志 schema 进行核验——它会因 model、API 操作和日志配置的不同而有所差异。
应用级优化
第三类节省(用即时检索取代塞满的 context、压缩长对话、把稳定且高流量的工作流蒸馏到更小的 model 上)属于应用团队,而非平台。平台的职责是让这些节省变得可见:发布按工作流的 token 排行榜、按 model 和工作流设定 token 上限,并让那些拥有昂贵工作流的团队清楚地看到自己所处的位置。
第 5 阶段:运营这个闭环
前四个阶段产出数据,这一阶段把数据变成决策。平台团队运行一个常设的健康仪表盘,包含四个信号:
Model 组合: 哪些 model 被调用、调用得多频繁——这是路由纪律的直接度量。 失败 request 率: 错误、限流和超时。每次重试都会增加延迟,而一个在客户端超时、却在服务端仍完成了的 request,可能被计费两次——一次是那次被放弃的调用,一次是重试。 缓存有效性: 第 4 阶段提到的读取与写入之比。 Metadata 覆盖率: 生产环境中带有完整 metadata 的调用占比。每一次未被覆盖的调用都是一个归属盲区,会在不知不觉中拖累其他所有数字。
当某个信号发生漂移,纠正措施应当是一次策略变更(路由规则、token 上限、metadata 强制),而不是一封要求团队「注意点」的邮件。
资金闭环
FinOps 用同一份数据来跑资金闭环。当归属干净利落时,异常检测就从一场慌乱的全体动员变成一条调查流水线:某个被打了标签的团队或应用出现激增,触发的是去第 2 阶段排行榜里查一查,而不是开作战室。成本回收则直接由 CUR 中按团队和应用的分组来运行。
记分卡
下面的阈值只是起点,并非定方。在把它们采纳为策略之前,请先用你自己的部署数据和定价层级加以校准。
维度指标绿黄红 单位经济性每次成功结果的成本≤ 预算1–1.5x 预算>1.5x 预算 按开发者成本每位开发者的每日支出<$100$100–$300>$300 Model 路由路由到高性价比 model 的调用占比>50%30–50%<30% 缓存效率cache 读取命中率>60%30–60%<30%
绿色意味着该 workload 运行在其经济性边界之内;黄色意味着路由或缓存的纪律正在松懈;红色意味着支出正集中到高价位 model 或未缓存的 context 上,而第 3、第 4 阶段的控制手段就是纠正路径。请按固定节奏审视这张记分卡(对高速消耗的部署每周一次,其余每两周一次),并把它当作 FinOps 与平台共同的决策界面。
结语
在本文中,你学习了如何构建一个五阶段运营模型,把 Amazon Bedrock 支出从失控带到完全受治理的状态:
用 IAM principal 标签、session 标签和 CUR 2.0,把每一美元归属到负责人。 通过 model 调用日志以及打上印记的 request metadata,观测每一次 request。 在与你风险相匹配的层级上强制执行预算:仅监控、越界即 IAM 拒绝,或同步的 gateway 阻断。 用 intelligent prompt routing 和 prompt 缓存优化平台默认设置,集中地消除浪费。 运营一张记分卡和一个审视节奏,把遥测数据变成策略决策。
注意那张记分卡的第一行:每次成功结果的成本,而不是每次调用的成本。这个区别,正是本手册交棒的地方。这里所讲的一切都能让 Amazon Bedrock 支出变得可见、可归属、有上限且高效,但一个工作流完全可能效率完美、却并不值得运行。要判断这一点,就得把 agent 与它所替代的人工流程做对照衡量——这是产品与分析的纪律,而非 FinOps 的纪律。成本平台所贡献的是地基:干净的归属和按工作流的成本数据,恰恰就是结果衡量要 join 的那些输入。
把五个阶段建起来,你就能端到端地回答:是谁花的、为什么花、以及它是否受到管控。这正是管理 Amazon Bedrock 成本的含义,也是每月账单例行审视与一套运营模型之间的分野。
要上手,先为第 1–3 阶段部署 Guidance for Claude Code with Amazon Bedrock 这一参考架构,然后依据 cost attribution best practices 文档来配置你的标签策略。
关于作者