在线AI教程 / AI上云
[Amazon Bedrock] Bayer Crop Science 如何利用 AWS Unified Operations 在 Amazon Bedr…
Artificial Intelligence Bayer Crop Science 如何利用 AWS Unified Operations 在 Amazon Bedrock Ag
Artificial Intelligence
Bayer Crop Science 如何利用 AWS Unified Operations 在 Amazon Bedrock AgentCore 上构建智能体式决策引擎
植物育种决策所依赖的数据横跨基因组学、田间试验、影像、环境条件和模型输出。Bayer Crop Science 针对这些数据、跨不同作物、区域和团队运行数百种机器学习(ML)模型配置,每一次运行都需要可重复且受到治理。为满足这一要求,Bayer 构建了 Connected Decision Engine(CDE),一个用于部署、编排、监控和复用 ML 工作流的系统。CDE 为育种人员、分析师、研究人员、数据科学家和数据工程师提供了一致的方式来运行分析,同时保留执行历史和运营控制。
随着采用范围扩大,瓶颈从运行工作流转为理解它们。解释一个结果意味着要从 API、文档、元数据存储、仪表板和日志中拼凑上下文。想知道某个工作流为何失败、某个模型做了什么,或某个结果来自哪里的用户,仍然必须知道该去检查哪个系统。为弥合这一差距,Bayer 构建了 Agentic Decision Engine(ADE),一个位于 CDE 之上的多智能体自然语言界面。一个监督者智能体把每个问题路由给相应的专家智能体,专家从相关系统检索上下文,用户无需浏览整个运营技术栈就能得到答案。在第一阶段,ADE 能在没有工程师介入的情况下解决约 80% 的用户问题。
ADE 运行在 Amazon Bedrock AgentCore 上,这是 AWS 的一项服务,可用于借助任意框架或模型大规模构建、连接和优化智能体。AgentCore 让团队能够专注于智能体行为,而不必自行构建和运维智能体托管、会话隔离和工具访问层。促使他们做出这一选择的,是 AgentCore 的三项能力:隔离每个用户会话的托管运行时;通过 AgentCore Gateway(Amazon Bedrock AgentCore 的一项能力)实现的、由 AWS Identity and Access Management (IAM) 约束的工具访问,把身份验证和授权留在智能体代码之外;以及框架无关的设计,让团队可以带入自己的 LangGraph 编排和自选模型。
为准备上线并在之后运营 ADE,Bayer 与 AWS Unified Operations 合作。此次合作提供了一名专属技术客户经理(TAM)和一名生成式 AI 领域专家工程师(DSE),他们从设计到生产始终作为 ADE 团队的延伸来工作。TAM 作为 Bayer 的战略顾问,带着对 Bayer 运营模式和业务优先事项的既有理解。DSE 带来 AWS 上的生成式 AI 领域专业知识。在每周三次的技术例会上,团队一起评审并做出设计决策。DSE 建立了对 ADE 工作负载和 Bayer 团队工作方式的实际认知,因此技术指导既反映 AWS 服务行为,也反映 Bayer 的具体情境。本文沿着这段历程展开:ADE 的架构、构建过程中做出的五项设计决策、为生产准备平台所做的工作,以及上线后如何运营。
架构概述
ADE 分为四层:用户体验、智能体编排、专家智能体,以及这些智能体调用的工具和数据源(图 1)。用户通过 React Web 前端访问 ADE,请求在到达智能体之前会经过一个面向 Microsoft Entra ID 的身份代理。GitHub Actions 构建智能体容器镜像,推送到 Amazon Elastic Container Registry (Amazon ECR),并部署到 AgentCore runtime(Amazon Bedrock AgentCore 的一项能力)。
Amazon Bedrock AgentCore runtime 承载智能体,由于该运行时与框架无关,团队可以直接在其上运行自己基于 LangGraph 的编排。团队选择 LangGraph,是因为它具有显式的基于图的控制流,以及面向多步工作流的检查点机制。LangGraph 负责编排工作流,以 Supervisor Agent 作为入口点,它会对每个请求进行分类、选择专家,并在问题跨领域时合并结果。数据平面按职责分离。Amazon DynamoDB 存储 LangGraph 检查点状态。Amazon Aurora PostgreSQL 存储会话记录、用户反馈和分析数据。Amazon ElastiCache 以生存时间(TTL)缓存智能体响应。Amazon Simple Storage Service (Amazon S3) 中的领域内容使用 Amazon Titan Text Embeddings V2 做向量化,并索引到 Amazon OpenSearch Serverless 中,用于检索增强生成(RAG)。Amazon CloudWatch 采集运行时和应用遥测。AgentCore Gateway 把后端 API 以 Model Context Protocol (MCP) 工具的形式暴露给智能体,并把身份验证和授权留在智能体代码之外。
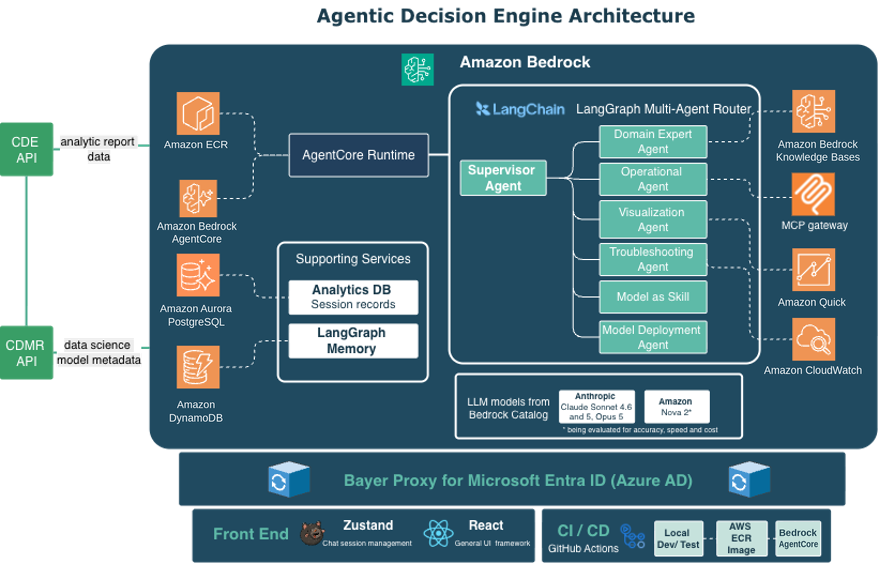
图 1:Amazon Bedrock AgentCore 上的 Agentic Decision Engine 架构
ADE 在生产中运行 22 个专家智能体,每个都限定在一个领域,拥有自己的工具和数据源。例如,Domain Expert Agent 通过 RAG 回答概念性问题。Operational Agent 从 CDE 检索实时工作流状态和结果。Troubleshooting Agent 分析运营遥测。Visualization Agent 生成图表或返回已有仪表板。一个客户特定的 Models as Skill 模式把模型代码和文档转换为存放在中央注册表中的技能定义,因此智能体可以依据模型的实现来回答模型相关问题,而不是依赖泛化的模型知识。
当一位育种人员问“我的表型分析工作流昨天为什么失败了?”,监督者会对意图进行分类,并把请求路由到 Troubleshooting Agent。该智能体通过 AgentCore Gateway 读取 CloudWatch 中该工作流的遥测和 CDE API 中的状态,定位失败点,并通过监督者返回诊断结果(图 2)。育种人员不需要直接翻日志。借助 Troubleshooting Agent,过去需要花一个多小时手动翻日志并等待工程师支持才能得到的诊断,现在不到 10 分钟就能完成。
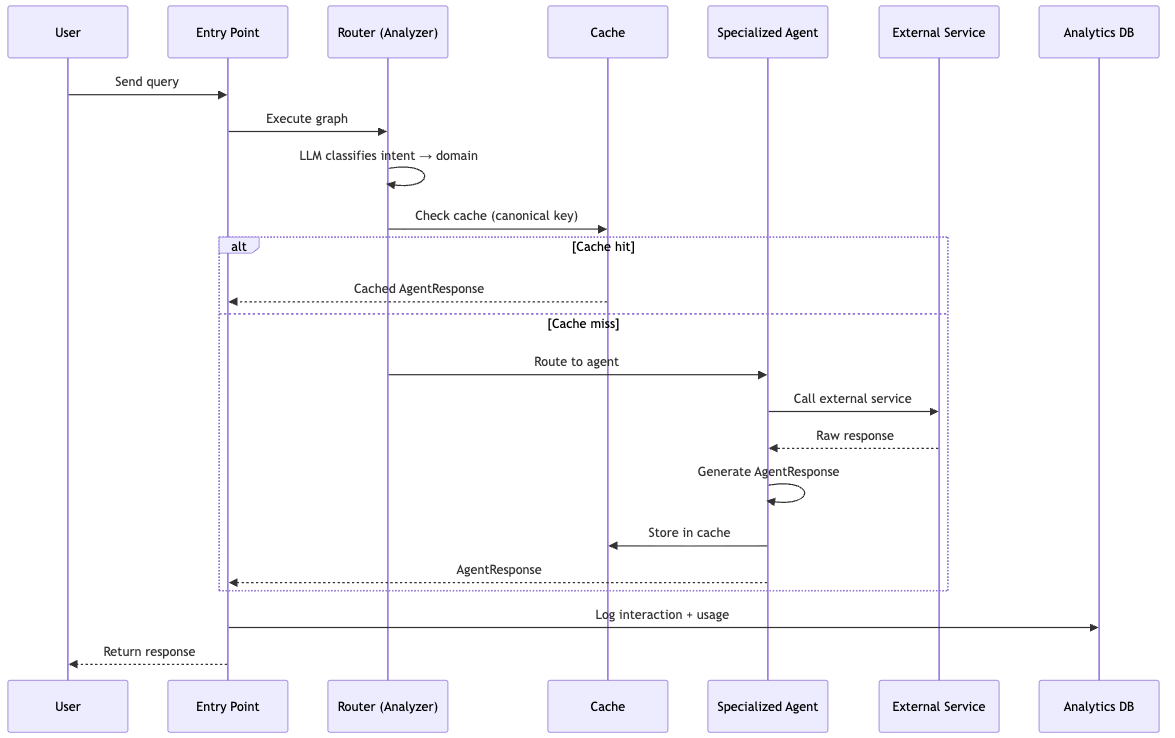
图 2:ADE 请求流程:意图分类、缓存查找、专家路由与响应
通往生产之路上的五项设计决策
Unified Operations 的 TAM 和 DSE 作为工作团队的成员参与了以下决策,而不是事后才被当作升级渠道。这让 Bayer 在拍板之前就能对照 AWS 服务行为检验每项设计,同时保留对架构和最终决定的所有权。
- 把编排状态外置,但不把运行时当作无状态
AgentCore runtime 提供隔离会话,可在会话生命周期内跨多次调用保留执行上下文。该上下文并不是多步工作流的持久存储。ADE 把 LangGraph 检查点写入 DynamoDB,使图在扩缩容事件、重启或会话边界之后能够恢复,而不依赖某一个执行环境始终可用。
原则: 用运行时会话承载当前执行,并把恢复或重建工作流所需的状态持久化到持久化服务中。
- 分离企业身份、网关访问和下游授权
Bayer 以 Microsoft Entra ID 作为用户身份标准,而 ADE 的各项服务之间使用 AWS 原生机制相互授权。团队没有强行让一个 token 跨越每个信任边界,而是为每个边界分别赋予自己的机制。
Entra ID 仍然是用户身份的来源。AWS Identity and Access Management (IAM) 为服务之间的调用授权。AgentCore Gateway 的出站授权负责访问下游 CDE 服务。一个请求拦截器 AWS Lambda 函数执行自定义校验,并传递下游工具所需的授权属性。团队与 DSE 一起梳理了每一跳的 token 契约。
原则: 智能体系统中的身份故障集中在用户身份、智能体身份和工具身份之间的转换处。在每一跳定义签发方、受众、声明、作用域和凭证生命周期,而不是把一个对某个边界有效的 token 复用到下一个边界。
- 把模型选择视为接口契约
在构建过程中,团队评估了一个启用了推理模式的较新模型版本。对该版本而言,ADE 所依赖的工具调用与结构化输出的组合,与其智能体的实现方式不兼容。DSE 确认了这一限制,团队在本次发布中保留了当前模型。
原则: 对于使用工具的智能体,模型选择受完整接口的约束:工具调用、结构化输出、流式行为、推理特性、延迟、配额可用性,以及特定模型的请求语义。较新的模型并不自动就是可直接替换的选项。
- 在工具面反过来控制提示之前先控制它
CDE 管理着 500 多种模型配置。为每个 API 单独建一个 MCP 服务器会增加部署、身份验证和版本管理的开销。ADE 改为向 AgentCore Gateway 注册 OpenAPI 规范,由后者把 REST 操作暴露为 MCP 工具。新增或变更 API 变成一次 schema 与网关配置变更,而不是一次新的服务器部署。
工具 schema 和描述也会消耗输入 token,并与用户的请求和检索到的上下文竞争。ADE 按专家智能体限定工具范围,而不是把完整目录交给每个智能体。对于更大的目录,AgentCore Gateway 支持语义化工具搜索,因此智能体可以在每一轮不必加载整个目录的情况下找到相关工具。
原则: 按智能体限定工具目录。每一个工具定义都会增加 token,并扩大模型的决策空间。
- 把复杂能力从工具提升为智能体
可视化最初是由其他智能体调用的一个工具。随着它不断增长,它需要自己的数据检索、图表选择逻辑、重试、错误处理,以及关于是生成图表还是返回已有仪表板的判断。团队把它移入一个专门的 Visualization Agent。该智能体在 AgentCore Code Interpreter(Amazon Bedrock AgentCore 的一项能力,提供沙箱化的代码执行环境)中使用 matplotlib 和 Plotly 按需生成图表,并通过 Amazon S3 与其交换数据。当预构建仪表板是更好的答案时,该智能体会返回已有的 Amazon Quick 或 Power BI 资产。
原则: 工具执行有界的操作。当某项能力开始拥有状态、重试、规划、策略或呈现决策时,就把它建模为智能体。
为生产准备 ADE
随着构建工作迈向发布,重点从设计转向可运维性:检测智能体故障、归因推理成本,以及加固部署。
可观测性:衡量任务失败,而不只是异常
监督者架构会把一个用户请求变成一串模型调用、工具调用和智能体交接。即使每个 HTTP 请求都成功,最终答案也可能是错的。ADE 直接遇到了这个问题:应用异常处理程序捕获了智能体错误,并返回被监控计为成功的响应。与 DSE 一起复现该问题后,团队在失败路径内部增加了自定义 CloudWatch 指标,并针对智能体特定状况设置告警:工具调用错误、限流、模型超时,以及结构化输出校验失败。跟踪和调用日志会跨监督者和专家跟踪每一个请求。
原则: 区分传输成功与任务成功。智能体可观测性应显示任务是否完成、是哪个智能体或工具改变了结果,以及响应是否使用了预期的来源。
成本归因:把计费归因与请求级遥测结合起来
一个 ADE 请求可能调用多个模型和工具,因此账户级的 Amazon Bedrock 支出无法解释单位经济性。团队与 DSE 一起设计了归因方法,使用三种回答不同问题的机制。Amazon Bedrock 应用推理配置文件把计费的模型用量归因到某个应用或工作负载。请求元数据和模型调用日志把 token 用量与特定的智能体、功能或请求关联起来。IAM 主体归因增加了一个身份维度。三者结合,使团队能够估算每次交互的成本、找出昂贵的智能体,并判断是提示、检索上下文还是工具定义推动了 token 使用。在实践中,依赖 MCP 工具和多次工具调用的 Visualization 与 Operational 智能体消耗的 token 最多。
同一套遥测还在上线准备期间暴露出一个工作负载:它具有大量重复的输入前缀,且没有任何提示缓存活动。对于受支持的模型,把稳定的指令和工具定义放进可缓存的前缀中,可以减少重复的输入处理,从而降低延迟和 token 成本。对 ADE 来说,缓存稳定的提示前缀把输入 token 成本削减了 20–30%。
安全与上线准备
IAM 角色按每个智能体的职责限定范围。Troubleshooting Agent 可以读取诊断所需的运营数据,但不能修改工作流。Domain Expert Agent 可以查询其检索索引,但不能调用无关的 CDE API。如今在生产中,ADE 的智能体响应受以下措施治理:最小权限、按智能体限定的只读工具访问、对智能体响应做结构化输出校验,以及让答案基于检索到的 CDE 数据和遥测,而不是开放式生成。Bayer 还计划评估 Amazon Bedrock Guardrails,作为这些控制之上的一层,补充 CDE 多轮工作流中已在使用的自定义安全检查。
上线之前,Unified Operations 与 ADE 团队一起完成了一次关键工作负载评审,以及一次包含生成式 AI Lens 的 Well-Architected 评审。由于 DSE 已经了解该工作负载,两次评审都针对 ADE 的具体故障模式、容量风险和部署缺口,而不是泛泛的最佳实践。发现的问题包括:监督者和专家智能体之间的失败可见性存在缺口、容器镜像标签可变、镜像可追踪性有限,以及缺少漏洞扫描。团队以更强的告警、不可变的版本化镜像、Amazon ECR 推送时扫描,以及针对未使用镜像的生命周期策略作为回应。
DSE 还与团队一起评审了扩缩容和配额需求。负载测试验证了应用及其服务配额,并暴露出一种返回空响应的网络故障模式,团队在生产活动之前修复了它。到上线时,团队已与 Unified Operations 一起跟踪并解决了 35 个阻塞项。
上线、运营与后续步骤
Bayer 先把 ADE 发布给一个受控小组,而不是一次向整个组织开放。自上线以来,Bayer Crop Science 已有 100 多名用户使用 ADE,包括育种人员、分析师、研究人员、数据科学家和工程师。除 22 个专家智能体外,ADE 还暴露约 20 个 API 工具,并可在扩展时承载第三方智能体。通过 AgentCore Gateway 而非为每个 API 单独建服务器来暴露这些 API,把每个 API 的集成开销降低了 99% 以上。在第一阶段,ADE 已在没有工程师介入的情况下解决了约 80% 的用户问题。
CDE 仍然是分析业务受治理的执行层。ADE 在其上增加了一个自然语言层,因此用户可以询问工作流状态、结果、模型行为和失败情况,而无需了解每个底层系统的位置或界面。
此后,合作重点从上线准备转向持续运营。DSE 继续与团队会面,因此问题分诊和运营评审都从对 ADE 的既有认知出发,而不是重新上手。ADE 的关键 CloudWatch 告警(包括前面提到的智能体特定告警)已接入 AWS Incident Detection and Response。当告警触发时,AWS Incident Management Engineers 会在 5 分钟内介入,并从工作负载的上下文出发,而不是从头开始。在安全方面,AWS Security Incident Response 的工程师在潜在或正在发生的安全事件期间为团队提供支持,因此 ADE 在运营和安全问题上都具备 AWS 的监控与响应覆盖。
由于智能体之间的通信已经就位,Bayer 下一步关注的是混合云智能体互操作性。团队正在探索如何让运行在不同环境中的智能体无需手动配置即可相互发现和通信。
结论
Bayer 并没有用 ADE 替换它的分析平台,而是让 CDE 更容易查询和运维。大部分生产工作都在提示之外:持久状态、身份边界、工具范围限定、任务级可观测性、成本归因和上线准备。Bayer 拥有架构以及其中每一项决策。通过与 AWS Unified Operations 的专属 DSE 和 TAM 合作,团队在设计阶段就对照 AWS 服务行为检验了这些决策,并把同样的上下文带入了生产。
要了解更多,请探索 Amazon Bedrock AgentCore、Amazon Bedrock 成本归因、AWS Well-Architected 生成式 AI 指导 以及 AWS Unified Operations。
作者感谢 Sijie Shi、Jorge Gomes、Naveen Reddy、Iago Fonseca、Mateus Silva 和 Sushimitha Jarugula 对 ADE 的设计、开发和上线所做的贡献。
关于作者