在线AI教程 / AI上云
[Amazon Bedrock] Deepgram 如何使用 AWS Trainium 大规模优化语音 AI
人工智能 Deepgram 如何使用 AWS Trainium 大规模优化语音 AI 随着语音成为人工智能的一流模式,Deepgram 的模型涵盖了语音到文本、文本到语音和语音代理
人工智能
Deepgram 如何使用 AWS Trainium 大规模优化语音 AI
随着语音成为人工智能的一流模式,Deepgram 的模型涵盖了语音到文本、文本到语音和语音代理。现在,他们每年为超过 200,000 名开发人员和 1,400 个组织处理数万亿个音频令牌。客户通过 Deepgram API 使用它们或在自己的环境中运行它们,包括在 Amazon SageMaker AI 上。
对于 Deepgram 来说,服务效率决定了系统在给定的基础设施预算下可以处理多少音频。大容量批处理工作负载给预算带来了沉重压力,因此加速器每个小时的使用效率越高,Deepgram 可以在同一队列上提供的音频就越多。这使得推理效率自然成为目标,Deepgram 转向 AWS AI 芯片来提高它。他们与 AWS 合作,将其 Nova-3 语音转文本模型引入 AWS Trainium2,用于离线批量工作负载,例如联络中心分析和医疗转录。
此次合作始于 Deepgram 交付 Nova-3 作为标准 PyTorch 代码。在几个月的时间里,Deepgram 和 AWS 前向部署工程 (FDE) 团队将 Nova-3 移植到 PyTorch 重建中的 AWS Trainium2,并针对新硬件进行了调整。最终配置在单个 Amazon Elastic Compute Cloud (Amazon EC2) trn2.3xlarge 实例上运行八个模型副本。在 Deepgram 的离线、面向吞吐量的批处理工作负载上,该设置比 Deepgram 运行的计算选项每美元处理的音频多了 11-70%。我们在评估时使用实例定价来衡量这一点。这些收益有助于 Deepgram 高效扩展,持续交付更好的模型,并以更低的价格将其带给客户。这些优势可以扩展到在 Amazon SageMaker AI 上自己的虚拟私有云 (VPC) 中自行托管 Deepgram 模型的客户。在那里,Deepgram 和 AWS 继续提高设置的简易性、可靠性和可观察性。
在这篇文章中,我们将介绍 Trainium 上的完整推理优化工作:将 Nova-3 移植到 AWS Neuron 软件堆栈、随后的内核级调整、让 Deepgram 自己的模型服务器调用 Trainium 的数据并行 Rust 运行时,以及我们在批量转录上测量的吞吐量和成本结果。
使用原生 PyTorch 将 Nova-3 优化为 Trainium2
从标准 PyTorch 代码开始,我们使用了 TorchNeuron,它是 Neuron 编译器的原生 PyTorch 集成,它支持急切执行和“torch.compile”。我们首先在 Trainium2 上以 eager 模式运行 Nova-3,并检查哪些操作回退到 CPU,然后使用“torch.compile”进行编译。编译路径在 Trainium2 上运行每个模型操作,未检测到 CPU 回退。
我们使用“torch.compile”将编码器和解码器编译为单独的静态形状图。在整个过程中,我们检查了两个级别的数值准确性:针对 CPU 的层级输出一致性,以及端到端字错误率 (WER),它必须与 Deepgram 的参考值和目标保持一致。
从该工作基线开始,我们通过使用公共 NKI 库 (NKILib) 中的融合内核替换多个层来开始优化工作,NKI 库是使用神经元内核接口 (NKI) 编写的预构建参考内核的集合。内核涵盖了融合 QKV 投影、融合前馈网络 (FFN) 层和深度一维卷积等操作。
我们针对 Deepgram 的离线推理工作负载优化了吞吐量,进而优化了成本效率。吞吐量被报告为相对于基准配置的相对增益,而不是每秒处理的绝对音频,我们扫描批量大小 1-128 以找到吞吐量最大化的批量大小。
使用 Neuron Explorer 和 NAD 进行内核级调整
启用内核只是优化飞轮的第一步:启用 NKI 内核(自定义或来自 NKILib),分析工作负载,然后根据分析见解调整现有内核或将其替换为新内核。重复此循环,直到达到性能目标。在每个步骤中,Neuron 堆栈的不同部分都会加速工作:NKILib 提供直接替换内核,Neuron Explorer 是分析 Neuron 工作负载的首选工具,Neuron Agentic Development (NAD) 工具包通过其分析和内核编写技能加速分析分析和内核调整。
在我们的例子中,NKILib 内核帮助我们完成了大部分任务,并且分析显示了手写内核在哪些方面会做得更好。每次,NAD 分析技能都会将我们从 Neuron Explorer 分析带到根本原因,而 NAD 内核编写技能则帮助我们生成替换内核。
层我们发现并改变了什么增益 FFN参考内核的切片调度从片外存储器中为每个令牌切片重新加载全套投影权重,因此随着令牌计数的增长,内存带宽限制了吞吐量。我们手工调整的内核加载每个权重图块一次,在多个令牌图块中重复使用它,并通过片上计算管道权重读取。与批量大小为 96 的参考内核相比,延迟降低了 2.0 倍 深度卷积 1d实验性的 NKILib 内核将该操作定义为隐式通用矩阵乘法 (GEMM),这使得张量引擎的利用率很低。我们将其重写为矢量引擎上的广播乘法累加循环,达到引擎的充分利用,足以抵消矢量引擎较低的峰值吞吐量。与批量大小为 96 的参考内核相比,速度提高了 1.5 倍 Conv2d该模型的 conv2d 层遇到了编译瓶颈:超过批量大小 32,这些层阻止模型编译为单个图。由于 NKILib 没有 conv2d 内核,因此我们在 NKI 中从头开始编写一个内核。内核按照前面描述的飞轮经历了几次基于探查器的迭代,解锁了 32 以上的批量大小。批量大小≤32时,卷积模块上高达 50 倍
Rust 中的数据并行运行时
每个 Trainium2 设备都具有八个物理 NeuronCore,默认情况下公开为四个逻辑 NeuronCore (LNC2)。由于每个 Nova-3 模型实例都适合单个物理核心,因此我们将每个逻辑核心的物理核心数量减少到一个 (LNC1)。此配置允许我们在每个 Trainium2 设备上托管八个模型副本 (DP8)。输入同时处理,同时最大化每个设备的吞吐量。数据并行运行时由工作窃取队列驱动,每个副本一个线程。
Deepgram 的生产服务堆栈是用 Rust 编写的,因此将 Nova-3 移植到 Trainium2 需要的不仅仅是编译模型:它还必须在服务路径中没有 Python 或 PyTorch 的情况下运行。因此,我们构建了一个轻量级运行时,其中 Rust 通过共享工作窃取队列协调模型副本。 C 层直接通过 Neuron Runtime API(“libnrt”)加载并执行提前编译的 Neuron 可执行文件格式(NEFF)。该运行时直接与 Deepgram 的服务架构集成,并在每个测试的批量大小上准确地重现参考令牌序列。
我们针对多线程 (MT) 和多处理 (MP) Python 数据并行运行时对其进行了基准测试。与 MP 基线相比,Rust 运行时完全消除了 Python 解释器的开销。与 MT 基线相比,它进一步减轻了全局解释器锁 (GIL) 序列化,因此来自并发工作线程的调度调用不再在单个进程内发生争用。这些增益很重要,因为 Nova-3 对每个音频块执行一系列小型解码器调用,使主机端调度成为低批量大小的瓶颈。因此,吞吐量的改进是最大的,并且即使在吞吐量最大化的批量大小下仍然有意义。与多处理 Python 基准相比,Rust 运行时的吞吐量提高了 7.5%。
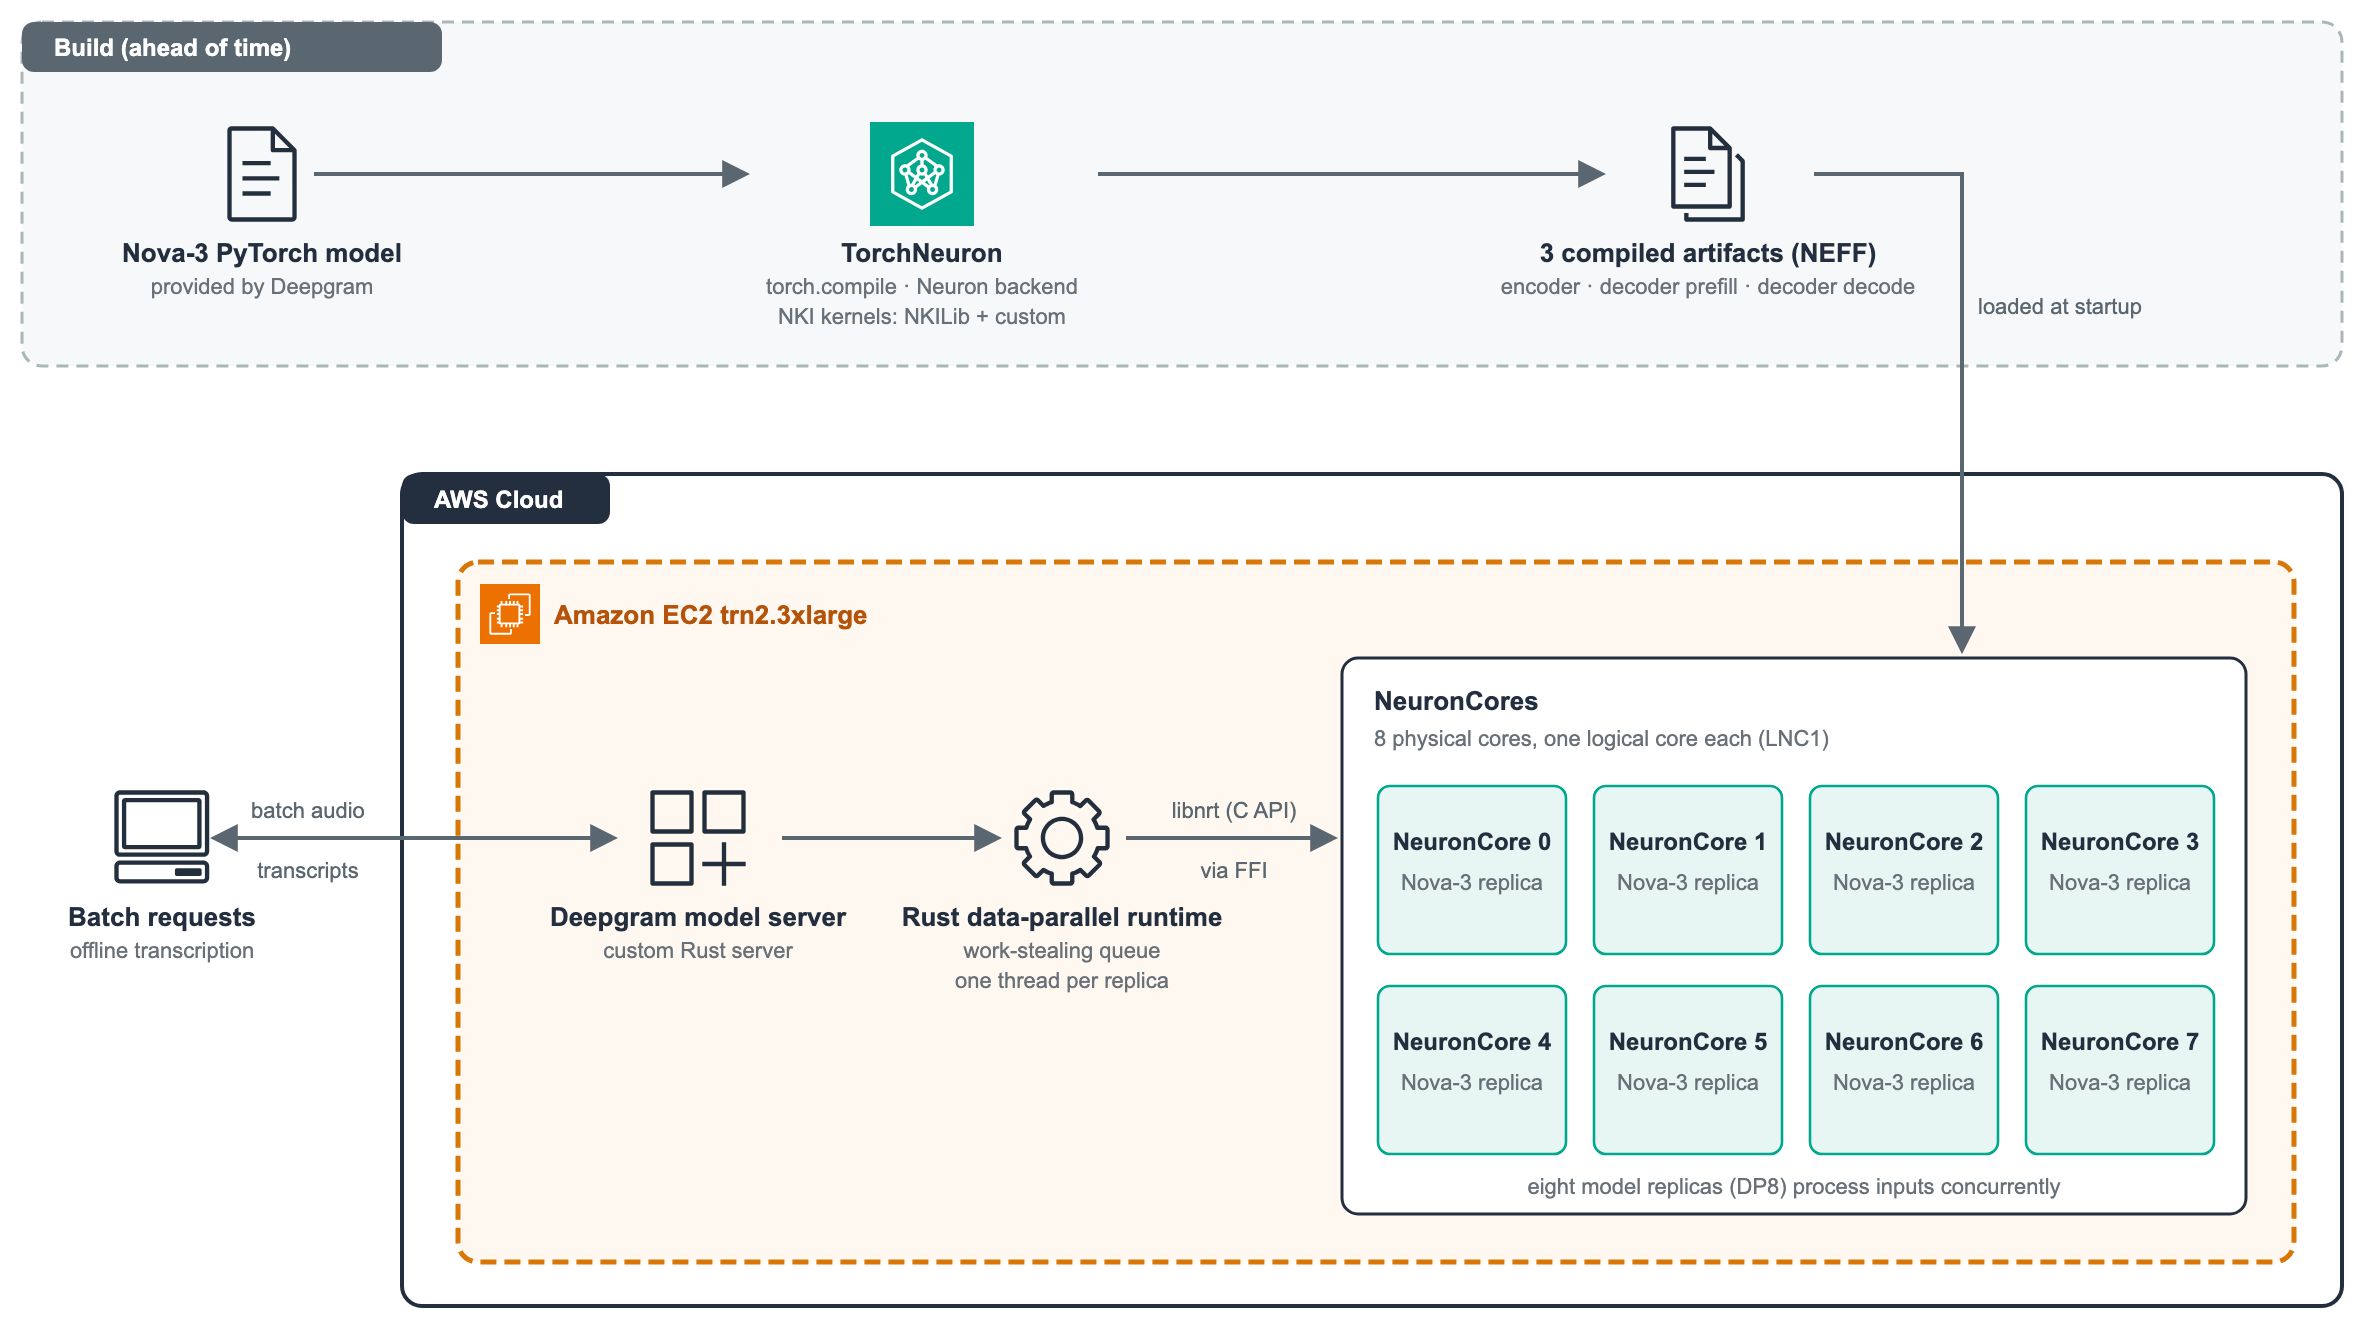
图 1:AWS Trainium2 上的 Deepgram Nova-3,提前编译并由 Rust 提供服务
节省成本的影响
我们以每美元处理的音频来衡量性价比。在 Deepgram 的离线、面向吞吐量的批处理工作负载上,单设备 Trainium2 设置 (trn2.3xlarge) 比 Deepgram 运行的计算选项多处理 11-70% 的音频。
## 结论
在本文中,我们演示了 Deepgram 和 AWS FDE 如何使用 TorchNeuron 将 Nova-3 语音转文本 PyTorch 模型移植到 Trainium 硬件,TorchNeuron 为 AWS Trainium 提供本机 PyTorch 框架集成。我们通过直接使用 NKILib 中的预构建内核替换层来提高性能。然后,我们使用 Neuron Explorer 评估性能,并使用 Neuron Agentic Development (NAD) 分析技能来查询分析数据并加速性能故障排除。基于这些见解,我们使用 NAD 内核编写技能改编了内核源代码。最后,我们为 AWS Trainium 构建了一个轻量级 Rust 数据并行运行时,从 Rust 调用 Neuron Runtime API。我们的设置证明了在离线、以吞吐量为导向的场景中节省了成本,验证了 AWS Trainium 作为 Deepgram 推理工作负载的可行且高效的选择。
要在您自己的模型上尝试此方法,请从 AWS Neuron 文档 开始,其中涵盖编译器、运行时和支持的框架。 神经元内核接口 (NKI) 指南 解释了如何编写本文中描述的内核,NKI 示例存储库 包含我们开始时使用的参考内核。 Neuron 开发人员工具文档 涵盖了我们在此使用的分析和代理工具,包括 Neuron Explorer 和 Neuron Agentic Development。有关实例大小和定价,请参阅 Amazon EC2 Trn2 实例。如需确定类似端口范围的帮助,请联系 AWS 前向部署工程。
关于作者