在线AI教程 / AI入门
[Amazon Bedrock] Amazon SageMaker AI 上的多轮强化学习:实践指南
人工智能 Amazon SageMaker AI 上的多轮强化学习:实践指南 大多数微调是教模型对单个 prompt 给出更好的回答。agentic 任务则不同。一个提交报销单或分
人工智能
Amazon SageMaker AI 上的多轮强化学习:实践指南
大多数微调是教模型对单个 prompt 给出更好的回答。agentic 任务则不同。一个提交报销单或分诊支持工单的 agent 会执行一连串动作,而每一步都取决于之前发生了什么。几乎不存在唯一正确的动作序列可供模仿,唯一可靠的反馈是整条序列是否成功。监督微调对此没有标签,而单轮强化学习无法为一个在结果出现前三步做出的决策分配信用。
Amazon SageMaker AI 上的多轮强化学习(Multi-Turn Reinforcement Learning,MTRL)正是用这种信号来训练模型。SageMaker AI 通过 AWS Lambda forwarder,把 prompt 发送到你在 Amazon Bedrock AgentCore 上托管的 agent,或你自己的基础设施(例如 Amazon Elastic Kubernetes Service(Amazon EKS)、Amazon Elastic Compute Cloud(Amazon EC2)或 AWS Fargate)上的 agent。这里的示例使用 AgentCore。agent 调用正在训练的 policy model,在你的环境中按任务所需的轮数行动,并在 episode 结束时上报一个 reward。你不需要指定正确的轨迹,只需指定如何对结果打分。
这篇博文以 Wordle 作为示例,这是一款玩家有六次机会猜出一个隐藏五字母单词的游戏。每次猜测之后,每个字母若位置正确就变绿,若在单词中但位置不对就变黄,若不在单词中则变灰。这个游戏适合 MTRL,因为规则很少,每次猜测都依赖上一次的反馈,而且结果可以被客观打分。Wordle 只是一个教学示例,前沿模型已经玩得很好。在实践中,你会用 MTRL 让一个规模小、成本低的模型擅长某项特定于你业务的多步任务,例如公开模型从未训练过的内部工作流。同一套流水线适用于那种场景。
在我们的这次运行中,MTRL 在默认 reasoning effort 下把 gpt-oss-20b 在留出单词上的解出率从 61% 提升到 84%,在它训练所用的 low effort 下从 15% 提升到 69%,训练 token 花费约 339 美元。本文会端到端走完这条流水线:把 agent 和 reward 部署到 AgentCore、准备数据集、训练、在 MLflow 中监控,以及在 serving settings 下评估。我们也会分享踩到的 reward 设计错误和训练失败。你的数据集、agent 和训练好的模型都留在你的 AWS 账户中,不会用于训练基础模型。所有代码都在配套的 aws-samples 仓库中。
方案概览
这个系统分为两半。SageMaker AI 负责任务(training job)和 policy model。AgentCore 托管 agent、Wordle 环境和 reward 函数。下图展示了它们如何连接。
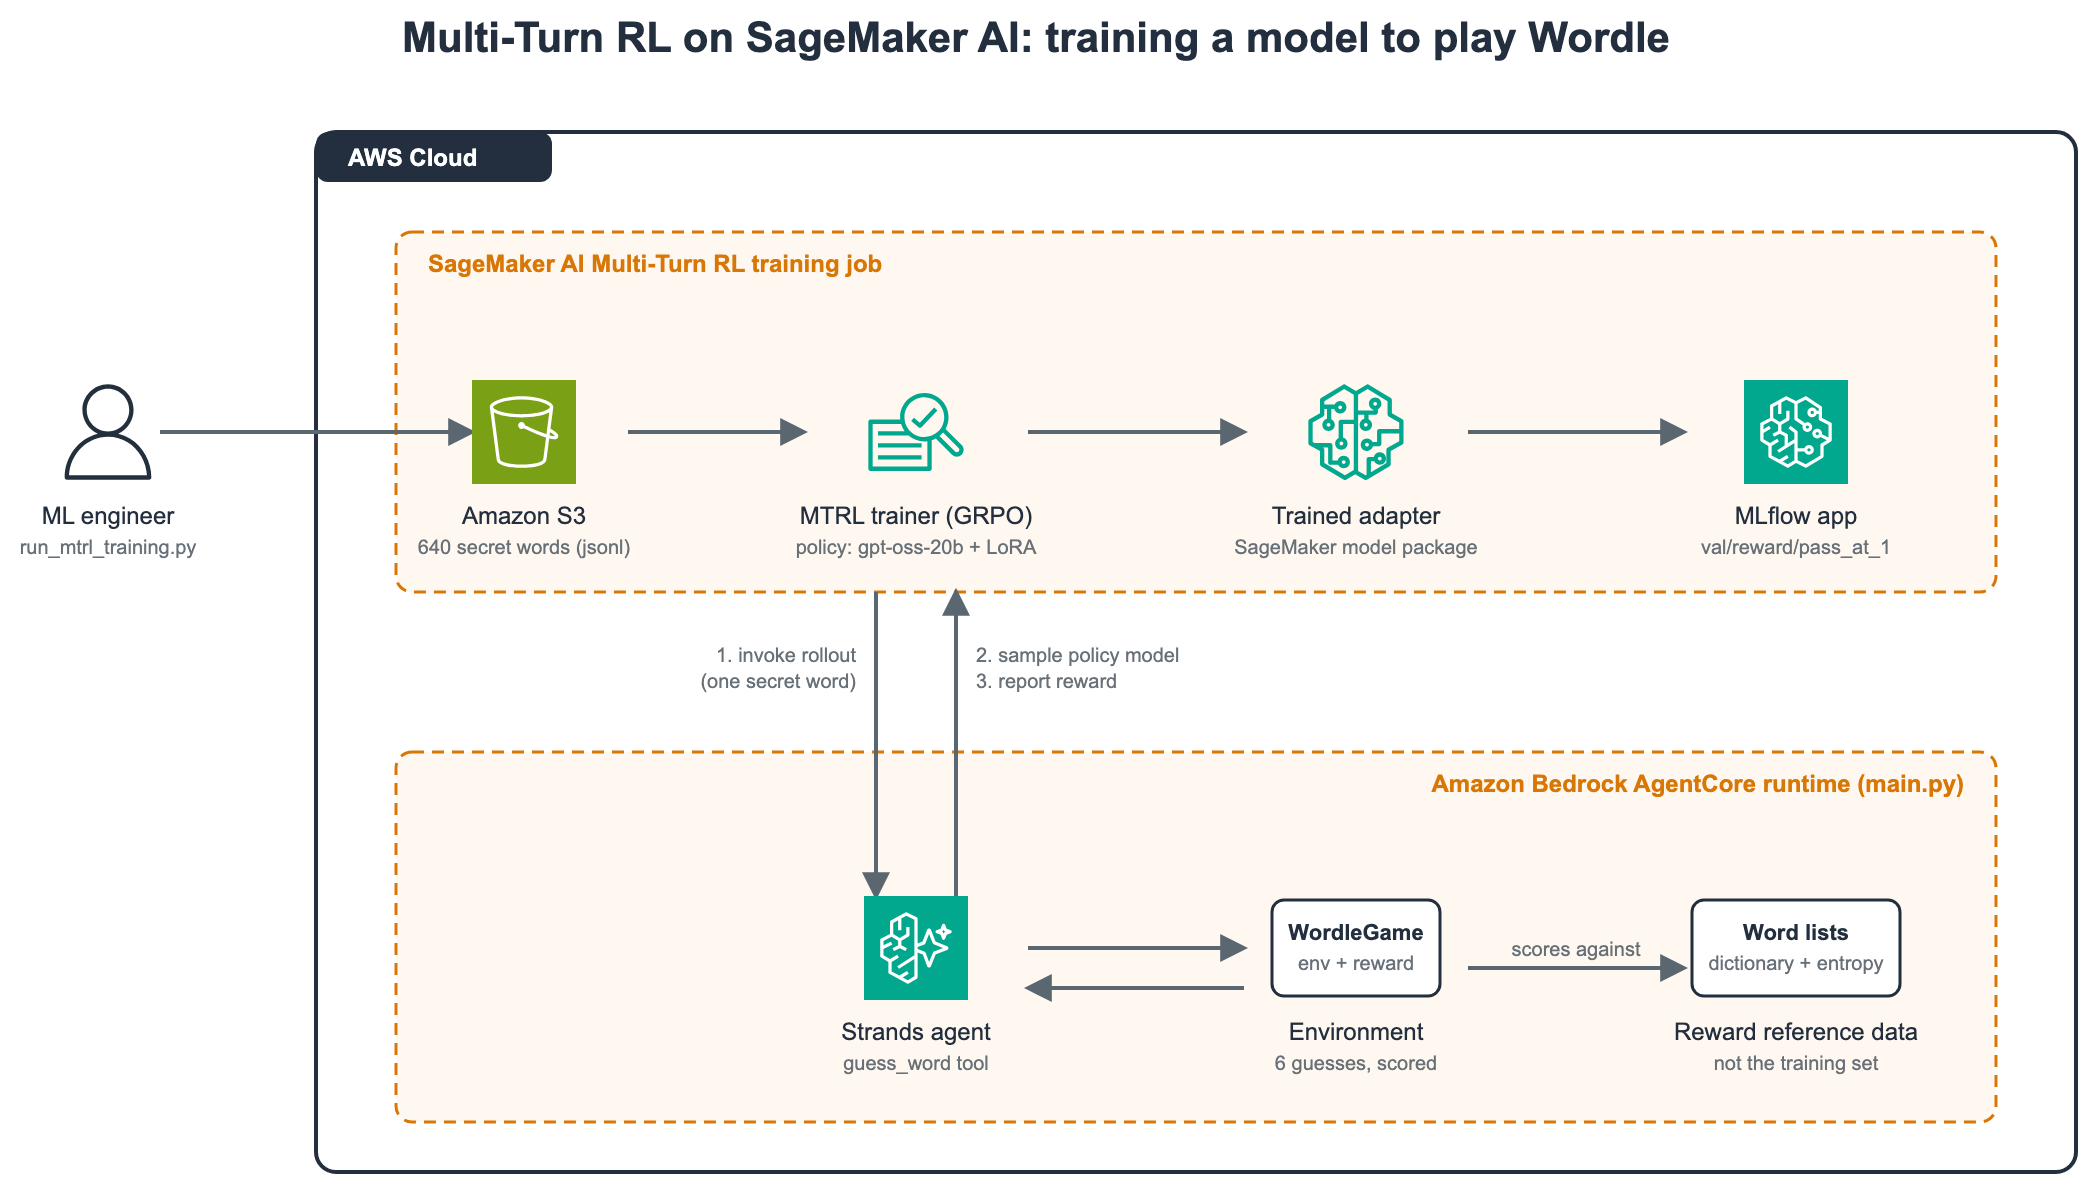
图 1:SageMaker AI 上的 MTRL,训练任务每次 rollout 调用一次 AgentCore 托管的 agent,以采样 policy model、进行游戏并上报 reward
每次 rollout,MTRL 服务都会带着一行训练数据(其中包含一个秘密单词)调用 Amazon Bedrock AgentCore 的 AgentCore runtime 能力。runtime 中的 Strands agent 通过 SageMaker Job Runtime 的 OpenAI 兼容端点调用 policy model。模型通过一个工具 guess_word 最多进行六次猜测,每次猜测之后,环境返回逐字母反馈以及对已知信息的摘要。游戏结束时,agent 返回一个 reward。Group Relative Policy Optimization(GRPO)利用同一个单词在多次 rollout 中 reward 的分布,来更新 policy model 上的 Low-Rank Adaptation(LoRA)adapter。
对接下来的内容来说,有三个设计要点很重要:
agent 和 reward 放在同一处。 一个部署到 AgentCore 的 Python 文件同时容纳环境、工具和打分函数。 数据集只携带秘密单词。 agent 打包的单词表由开源 SCOWL 单词表构建,仅用于打分。 reward 以结果为主导。 获胜根据速度支付 1.05–1.55,失败支付 -0.5,从未做出有效猜测则支付 -1.5。一个小的 shaping 项在每个档位内奖励好的策略。
支持的模型与 AWS 区域
MTRL 是无服务器的:你选一个基础模型,服务负责准备训练和采样所需的基础设施。在撰写本文时,它支持以下基础模型,每个都用 LoRA adapter 训练:
基础模型AWS 区域 Amazon Nova 2 LiteUS East (N. Virginia) (us-east-1), US West (Oregon) (us-west-2) GPT-OSS-20BUS East (N. Virginia) (us-east-1), US West (Oregon) (us-west-2) Gemma 4 31B (instruction-tuned)US West (Oregon) (us-west-2) Qwen 3.6 27BUS West (Oregon) (us-west-2)
我们选择 GPT-OSS-20B,因为它的每 token 价格是四者中最低的,而且 reasoning effort 可以按请求控制。当前列表见 MTRL 文档。
定价
你不需要选择实例,也不需要为集群定容。你按三个维度上的每百万 token 付费,价格取决于基础模型:
Prefill: policy model 处理的输入 token。在多轮任务中这部分会不断累积,因为每一轮都要重新读取历史。 Sample: policy model 生成的 token,包括 reasoning token。 Train: 在更新 LoRA adapter 的反向传播中处理的 token。
这次 100 步的运行共消耗 4.916 亿 prefill、1.597 亿 sample 和 6.433 亿 train token,在 12 小时 40 分钟内完成了 105,486 次 rollout。按撰写本文时 US East (N. Virginia) 区域(us-east-1)的 GPT-OSS-20B 目录价,这大约是 339 美元:
维度Token 数每 100 万 Token 价格费用 Prefill491,616,806$0.12$58.99 Sample159,737,098$0.30$47.92 Train643,308,554$0.36$231.59 合计1,294,662,458$338.50
Train 维度占了大头,并且随轨迹长度增长,因此更短的对局和更精简的推理能压低账单。AgentCore runtime 按 agent 使用的 vCPU 和内存单独计费。这次运行约 79 美元,依据是 runtime 在 us-east-1 目录价下的 Amazon CloudWatch 用量指标。DescribeJob 会在 BillableTokenUsage 下报告 token 计数。当前费率见 Amazon SageMaker AI 定价。
前提条件
要跟着本文操作,你需要以下内容。另请参阅 MTRL 前提条件。
Python 3.10 或更高版本、uv、Node 20 或更高版本,以及 AgentCore CLI(npm install -g /agentcore)。安装方法以及 CLI 所需的 IAM 权限见 Amazon Bedrock AgentCore 入门。 在启动任务的机器上安装 botocore 1.43.37 或更高版本。这是第一个包含 AgentRFT 的 CreateJob 操作的版本。 两个 AWS Identity and Access Management(IAM)角色,见第 1 步。 一个与 agent 同区域的 Amazon Simple Storage Service(Amazon S3)存储桶。训练任务也必须在同一区域运行,因为 CreateJob 会拒绝跨区域的 runtime ARN。
第 1 步:创建 IAM 角色
MTRL 使用两个角色,其中一个的信任策略在通用 SageMaker AI 文档里没有提到。
Agent runtime 角色。 agentcore deploy 会为你创建这个角色。它信任 bedrock-agentcore.amazonaws.com,并需要 AmazonSageMakerJobRuntimeAccess 托管策略,该策略让 agent 能够调用 policy model 并上报 reward。示例仓库中的 CDK stack 会自动附加这个策略。
训练任务角色。 这个角色需要你自己创建。它必须以 sts:AssumeRole 和 sts:TagSession 信任 job.sagemaker.amazonaws.com,并需要 AmazonSageMakerJobFullAccess 托管策略。
{ "Version": "2012-10-17", "Statement": [{ "Effect": "Allow", "Principal": {"Service": "job.sagemaker.amazonaws.com"}, "Action": ["sts:AssumeRole", "sts:TagSession"] }] }
注意: 信任主体是 job.sagemaker.amazonaws.com,而不是 sagemaker.amazonaws.com。如果使用通用主体,CreateJob 会以“Could not assume role”失败,而且这条消息要等重试之后才会写出正确的主体名。
第 2 步:把 agent 部署到 Amazon Bedrock AgentCore
克隆示例仓库,在 Wordle/agentcore/aws-targets.json 中设置你的账号和区域,然后部署:
git clone cd sample-multi-turn-rl-wordle/Wordle agentcore validate agentcore deploy
CLI 会为 runtime 的 Linux ARM64 平台构建 agent 的依赖,创建执行角色并附加 AmazonSageMakerJobRuntimeAccess 策略,然后通过 AWS CloudFormation 部署。我们建议用它,而不是在控制台上上传代码包——在控制台上很容易把约 700 MB 的编译依赖或策略附加弄错。请记下输出中供训练任务使用的 runtime ARN。
图 2:Amazon Bedrock AgentCore 控制台中状态为 Ready 的 Wordle agent runtime
runtime 从 agentcore.json 读取两个环境变量。REASONING_EFFORT=low 会把发往 policy model 的每个请求的 reasoning_effort 都设为 low。在我们的评估任务中,low effort 每局消耗的 sample token 比 medium 少 63% 到 83%。REASONING_PROMPT_HINT=true 还会把“Reasoning: low”加入 system prompt,这是 gpt-oss 在其 Harmony chat 格式中读取该设置的方式。这两个变量都不会给模型任何关于秘密单词的提示。
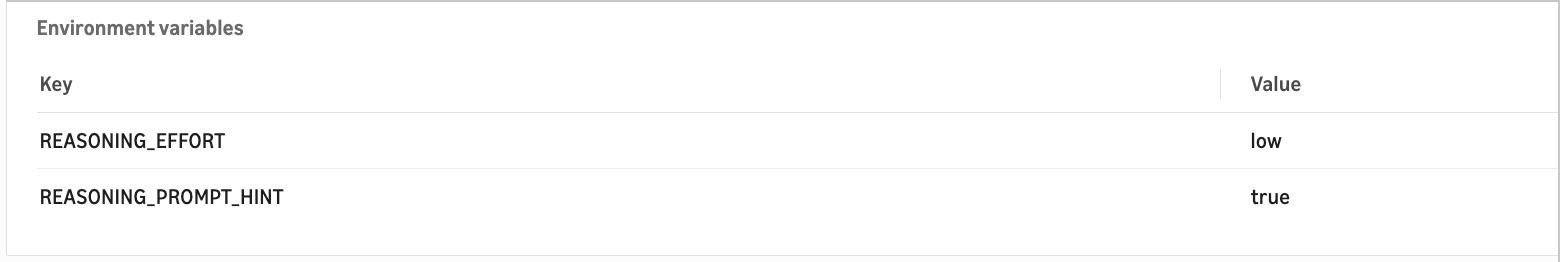
图 3:runtime 环境变量显示 REASONING_EFFORT 设为 low
agent 只有一个文件 main.py。简化之后,它的入口点如下所示。对你自己的任务,你需要修改任务解析、工具和 reward:
app = BedrockAgentCoreApp() .entrypoint # outermost: starts the HTTP server AgentCore invokes @sagemaker_rft_handler # reports the returned reward to SageMaker AI def handle_rollout(payload): prompt, answer = parse_task(payload["prompt"]) game = WordleGame(answer)
def guess_word(guess: str) -> str: """Submit a 5-letter Wordle guess and get feedback.""" return game.guess(guess)
agent = Agent(model=build_model(), system_prompt=SYSTEM_PROMPT, tools=[guess_word]) agent(prompt) return {"reward": game.final_reward()}
重要: sagemaker_rft_handler 装饰器本身不会启动 HTTP 服务器。要用 BedrockAgentCoreApp 和 .entrypoint 包住它,并让 entrypoint 装饰器在最外层。否则每次调用都会在 30 秒后超时。
第 3 步:验证 runtime
在消耗 GPU 时间之前,先用一个与训练服务发送格式相同的 payload 确认整条链路可通。仓库中包含一个,位于 Wordle/payload.json:
{ "prompt": "{\"prompt\": \"Guess the 5-letter word\", \"answer\": \"beach\", \"id\": \"smoke-test\"}", "metadata": { "jobArn": "arn:aws:sagemaker:us-east-1:111122223333:job/AgentRFT/smoke-test", "rolloutId": "r1" } }
这个假的 job ARN 预期会失败,而它失败的方式就是证据。先把 111122223333 换成你自己的账号 ID:如果 job ARN 指向另一个账号,服务会在检查任务是否存在之前就返回 403,看起来像是 IAM 配错了。在 Wordle 目录下运行:
ACCOUNT=$(aws sts get-caller-identity --query Account --output text) sed "s/111122223333/$ACCOUNT/" payload.json > /tmp/payload.json
aws bedrock-agentcore invoke-agent-runtime \ --agent-runtime-arn
在 runtime 的 Amazon CloudWatch 日志中,你会看到 agent 解析 prompt、向 Job Runtime 端点完成身份验证,并收到一个内容为“Could not find job”的 400 错误。这个失败说明解析、身份验证和错误上报都正常工作。命令本身会打印 {“reward”: -1.5},因为 agent 始终没有到达 policy model。如果返回的是内容为“not authorized to access this resource”的 403,说明 job ARN 仍然指向另一个账号。如果换成 30 秒超时,则说明 HTTP 服务器没有启动(见第 2 步的重要提示)。
第 4 步:准备数据集
MTRL 数据集没有目标响应、对话记录或标签。每一行都是让 agent 尝试的一个任务。下面是训练文件的前三行:
{"prompt": "{\"prompt\": \"Guess the 5-letter word\", \"answer\": \"riser\", \"id\": \"wordle_train_0000\"}"} {"prompt": "{\"prompt\": \"Guess the 5-letter word\", \"answer\": \"swoon\", \"id\": \"wordle_train_0001\"}"} {"prompt": "{\"prompt\": \"Guess the 5-letter word\", \"answer\": \"dirty\", \"id\": \"wordle_train_0002\"}"}
服务会读取 prompt 列(或第一列),并把该字符串原样传给你的 agent,不做解析。我们把这个字符串做成了包含三个字段的小 JSON 对象:
prompt: agent 展示给 policy model 的指令,每一行都相同。 answer: 秘密单词。只有环境和 reward 函数会用它。policy model 永远看不到它。 id: 行 ID,用于把日志中的某次 rollout 追溯到它的来源行。
示例仓库中的 make_dataset.py 从答案列表中抽取 640 个训练单词(五个完整的 128 批次)和 128 个验证单词,两者不重叠,因此验证解出率衡量的是泛化能力。服务也接受 Apache Parquet、JSON 数组和 CSV。把两个文件上传到 Amazon S3:
uv run python make_dataset.py aws s3 cp training-data.jsonl s3://
由于服务从不检查 prompt 字符串,生产任务可以把完整的消息列表、工具配置或 reward 规格打包进去。示例见 MTRL 文档,其中还包括如何保护该字符串中的敏感内容。
第 5 步:启动训练任务
启动脚本使用 sagemaker-train SDK 中的 MultiTurnRLTrainer 类。把它指向第 2 步的 runtime ARN、第 1 步的角色、第 4 步的数据集,以及一个用于记录指标的 MLflow app。MLflow app 是必需项,所以如果你还没有,先用 aws sagemaker create-mlflow-app 创建一个:
uv run python run_mtrl_training.py \ --model openai-reasoning-gpt-oss-20b \ --agent-runtime-arn
启动脚本会覆盖三个超参数,其余全部沿用 gpt-oss-20b 的默认值。它把 sampling_max_tokens 设为 8192,也就是服务允许的最大值,因为在默认值 4096 下,gpt-oss 常常在推理阶段、还没发出第一次工具调用时就把 token 用完了。它把 max_epochs 设为 20、max_steps 设为 100:640 行数据在默认 global_batch_size 128 下相当于每个 epoch 5 步,而在默认 group_size 8 下,每一步要打 1,024 局游戏。任务会依次经过 Starting、Downloading 和 Pending,然后进入 Training。开始训练后,你的 AgentCore runtime 就会开始收到 rollout 调用。
重要: 任务运行期间不要重新部署 agent。重新部署会重启 runtime,进行中的 rollout 收不到采样请求,服务会让整个任务失败。
第 6 步:在 MLflow 中监控训练
服务在每一步都会记录 reward、token 和轮次统计,并每隔 val_every 步运行一次验证。需要关注的指标是 val/reward/pass_at_1,即在留出单词中被解出的比例。每次解出至少得 1.01 分,因此能越过服务 1.0 的 success_threshold,被 pass@1 计入。下面的图表由本次运行的 MLflow 历史构建:
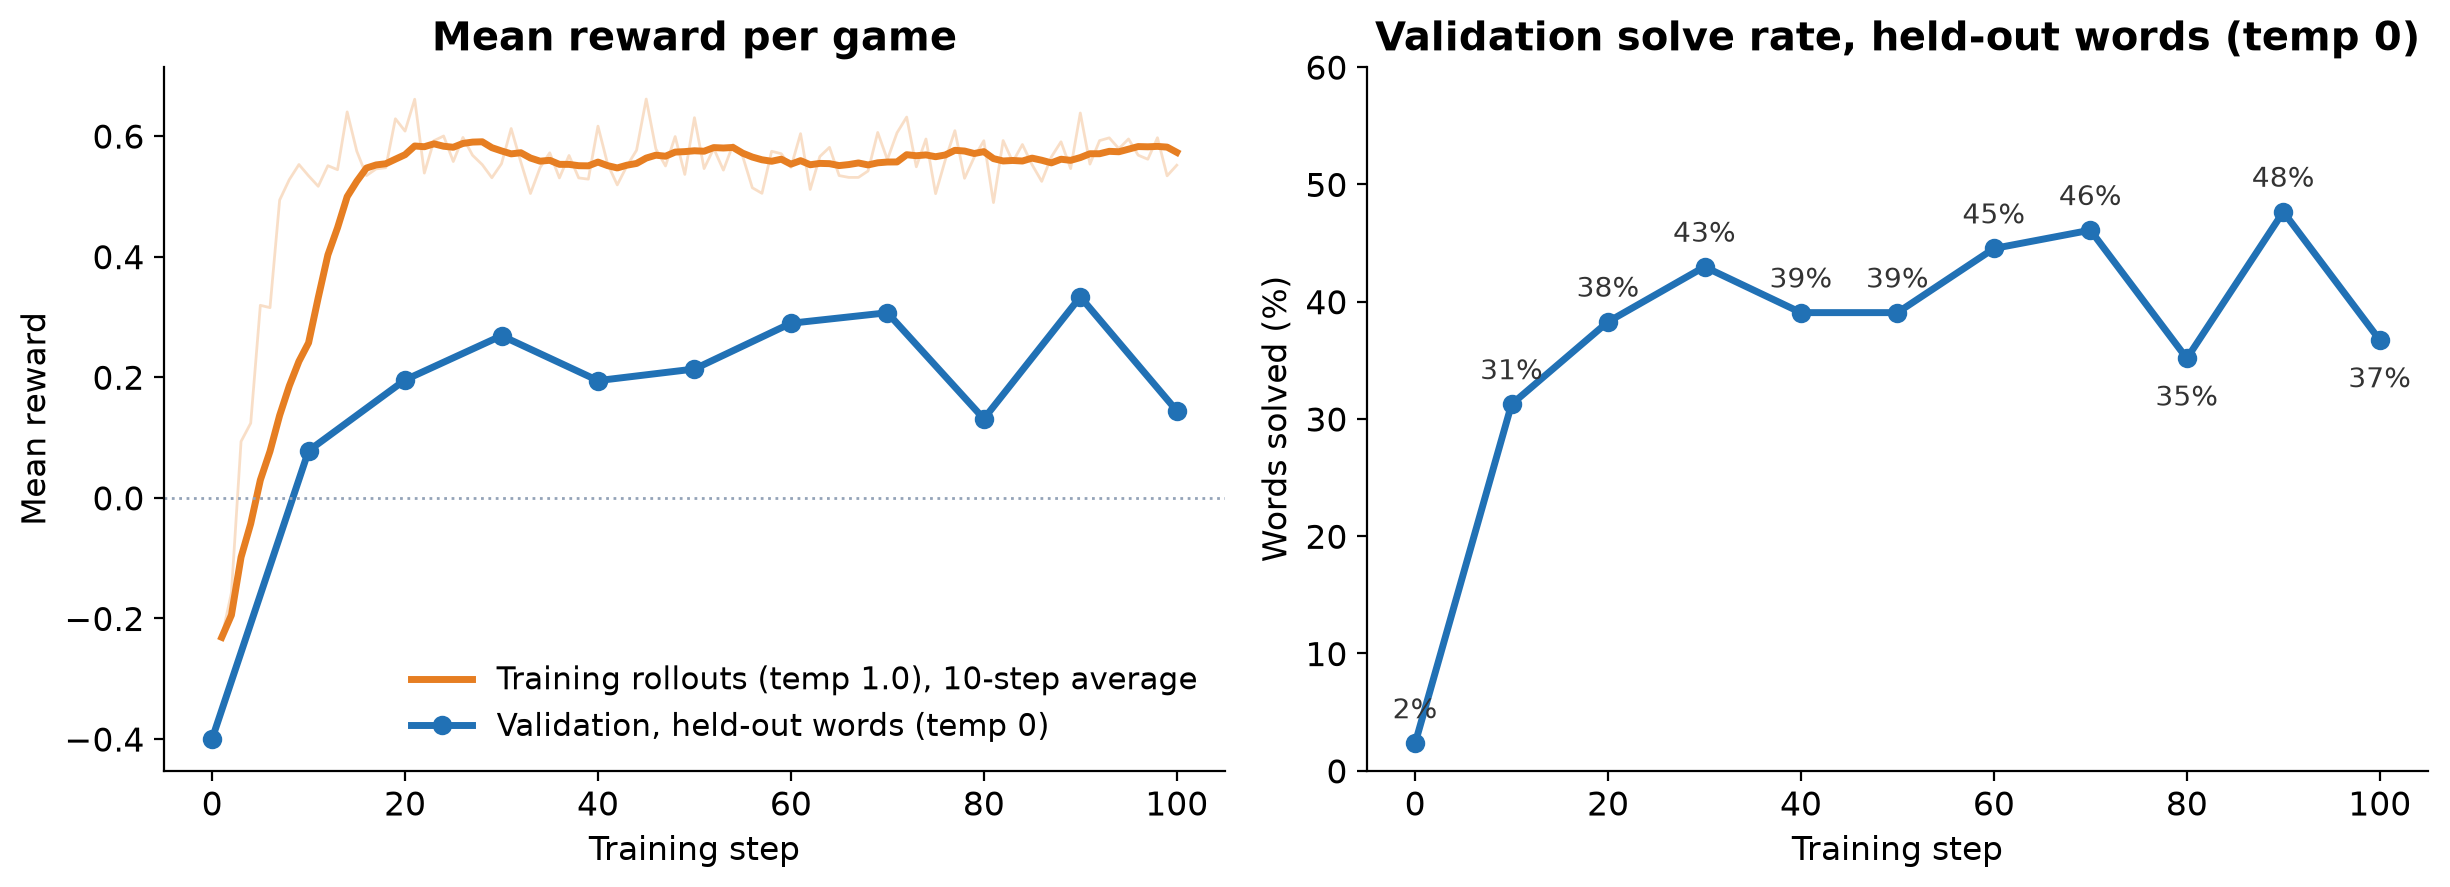
图 4:这次 100 步运行的训练曲线,左侧为每局平均 reward,右侧为验证解出率
训练 reward 在 15 步内攀升到约 +0.57 并保持在那里。验证 reward 一直较低,主要原因是 temperature 1.0 与 0 的差别,而不是过拟合(见第 7 步)。验证解出率在最初 10 步里从 2% 跳到 31%,之后在 35% 到 48% 之间波动。在只有 128 个单词的情况下,这些起伏主要是噪声。我们没有测试在 serving settings 下更多步数是否有帮助。
runtime 在 CloudWatch 中的 OpenTelemetry trace 记录了每一次模型轮次和工具调用。下面是训练后的模型在一次评估任务中打的一局游戏(medium effort,temperature 1.0),推理内容做了删节。秘密单词是 PASTE:
[model] Reasoning: [...] "CRANE" has 5 distinct letters: C,R,A,N,E. [...] We'll guess "CRANE". Tool call: guess_word(guess="CRANE") [tool] Guess 1/6: CRANE -> C=gray, R=gray, A=yellow, N=gray, E=green Current Knowledge:
- Correct Position (Green): _ _ _ _ E
- In Word, Wrong Position (Yellow): 'A' (at least 1)
- Not in Word (Gray): C, N, R
- Guesses Remaining: 5
[model] Reasoning: [...] "ALIVE": ends with E, includes A. Letters not C,N,R. Tool call: guess_word(guess="ALIVE") [tool] Guess 2/6: ALIVE -> A=yellow, L=gray, I=gray, V=gray, E=green [model] Reasoning: [...] So positions not 1 or 3 for A. Positions left: 2,4 for A. [...] We might guess "HASTE"? [...] Tool call: guess_word(guess="HASTE") [tool] Guess 3/6: HASTE -> H=gray, A=green, S=green, T=green, E=green [model] Reasoning: We have the word: _ASTE. [...] "PASTE" is a word. PASTE fits. Also "WASTE" also fits [...] Choose "PASTE" maybe. Tool call: guess_word(guess="PASTE") [tool] Guess 4/6: PASTE --- all green. Correct, you solved it!
一段来自 AgentCore runtime trace 的训练后模型 rollout。模型会把绿色字母保持在原位,从不重复使用灰色字母,并利用每个黄色字母排除位置,而训练数据里并没有教它这些。
第 7 步:在 serving settings 下评估训练后的模型
任务完成后,它在 SageMaker AI Studio 中的页面会显示状态以及存放已训练模型的 model package group。把 JobCategory 设为 AgentRFT 的 DescribeJob 会返回输出 model package 的 ARN 和可计费 token 计数。
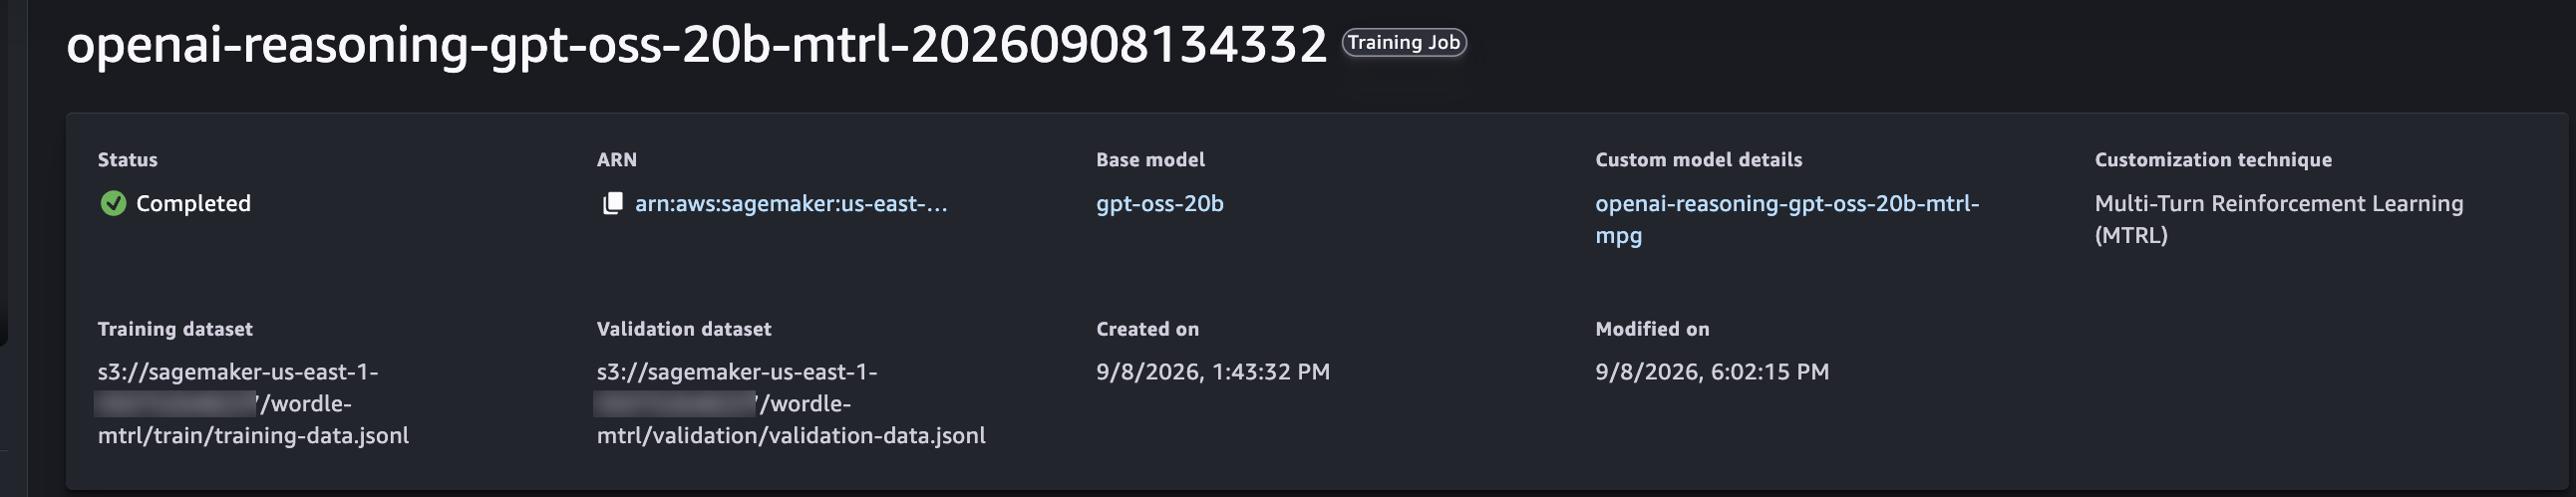
图 5:SageMaker AI Studio 中 Jobs、Training、Multi-turn RL 标签页上已完成的训练任务
评估任务(JobCategory 设为 AgentRFTEvaluation)会通过同一个 AgentCore runtime 和 reward,在基础模型或训练后的 package 上运行你的评估 prompt,并把 eval/reward/pass_at_1 记录到 MLflow。与训练时的验证不同,这里可以设置 temperature。仓库中的启动脚本会连续运行多次评估,因为默认配额一次只允许一个评估任务(你可以申请提高配额):
uv run python run_mtrl_eval.py --runs base:1.0 trained:1.0 \ --model-package-arn
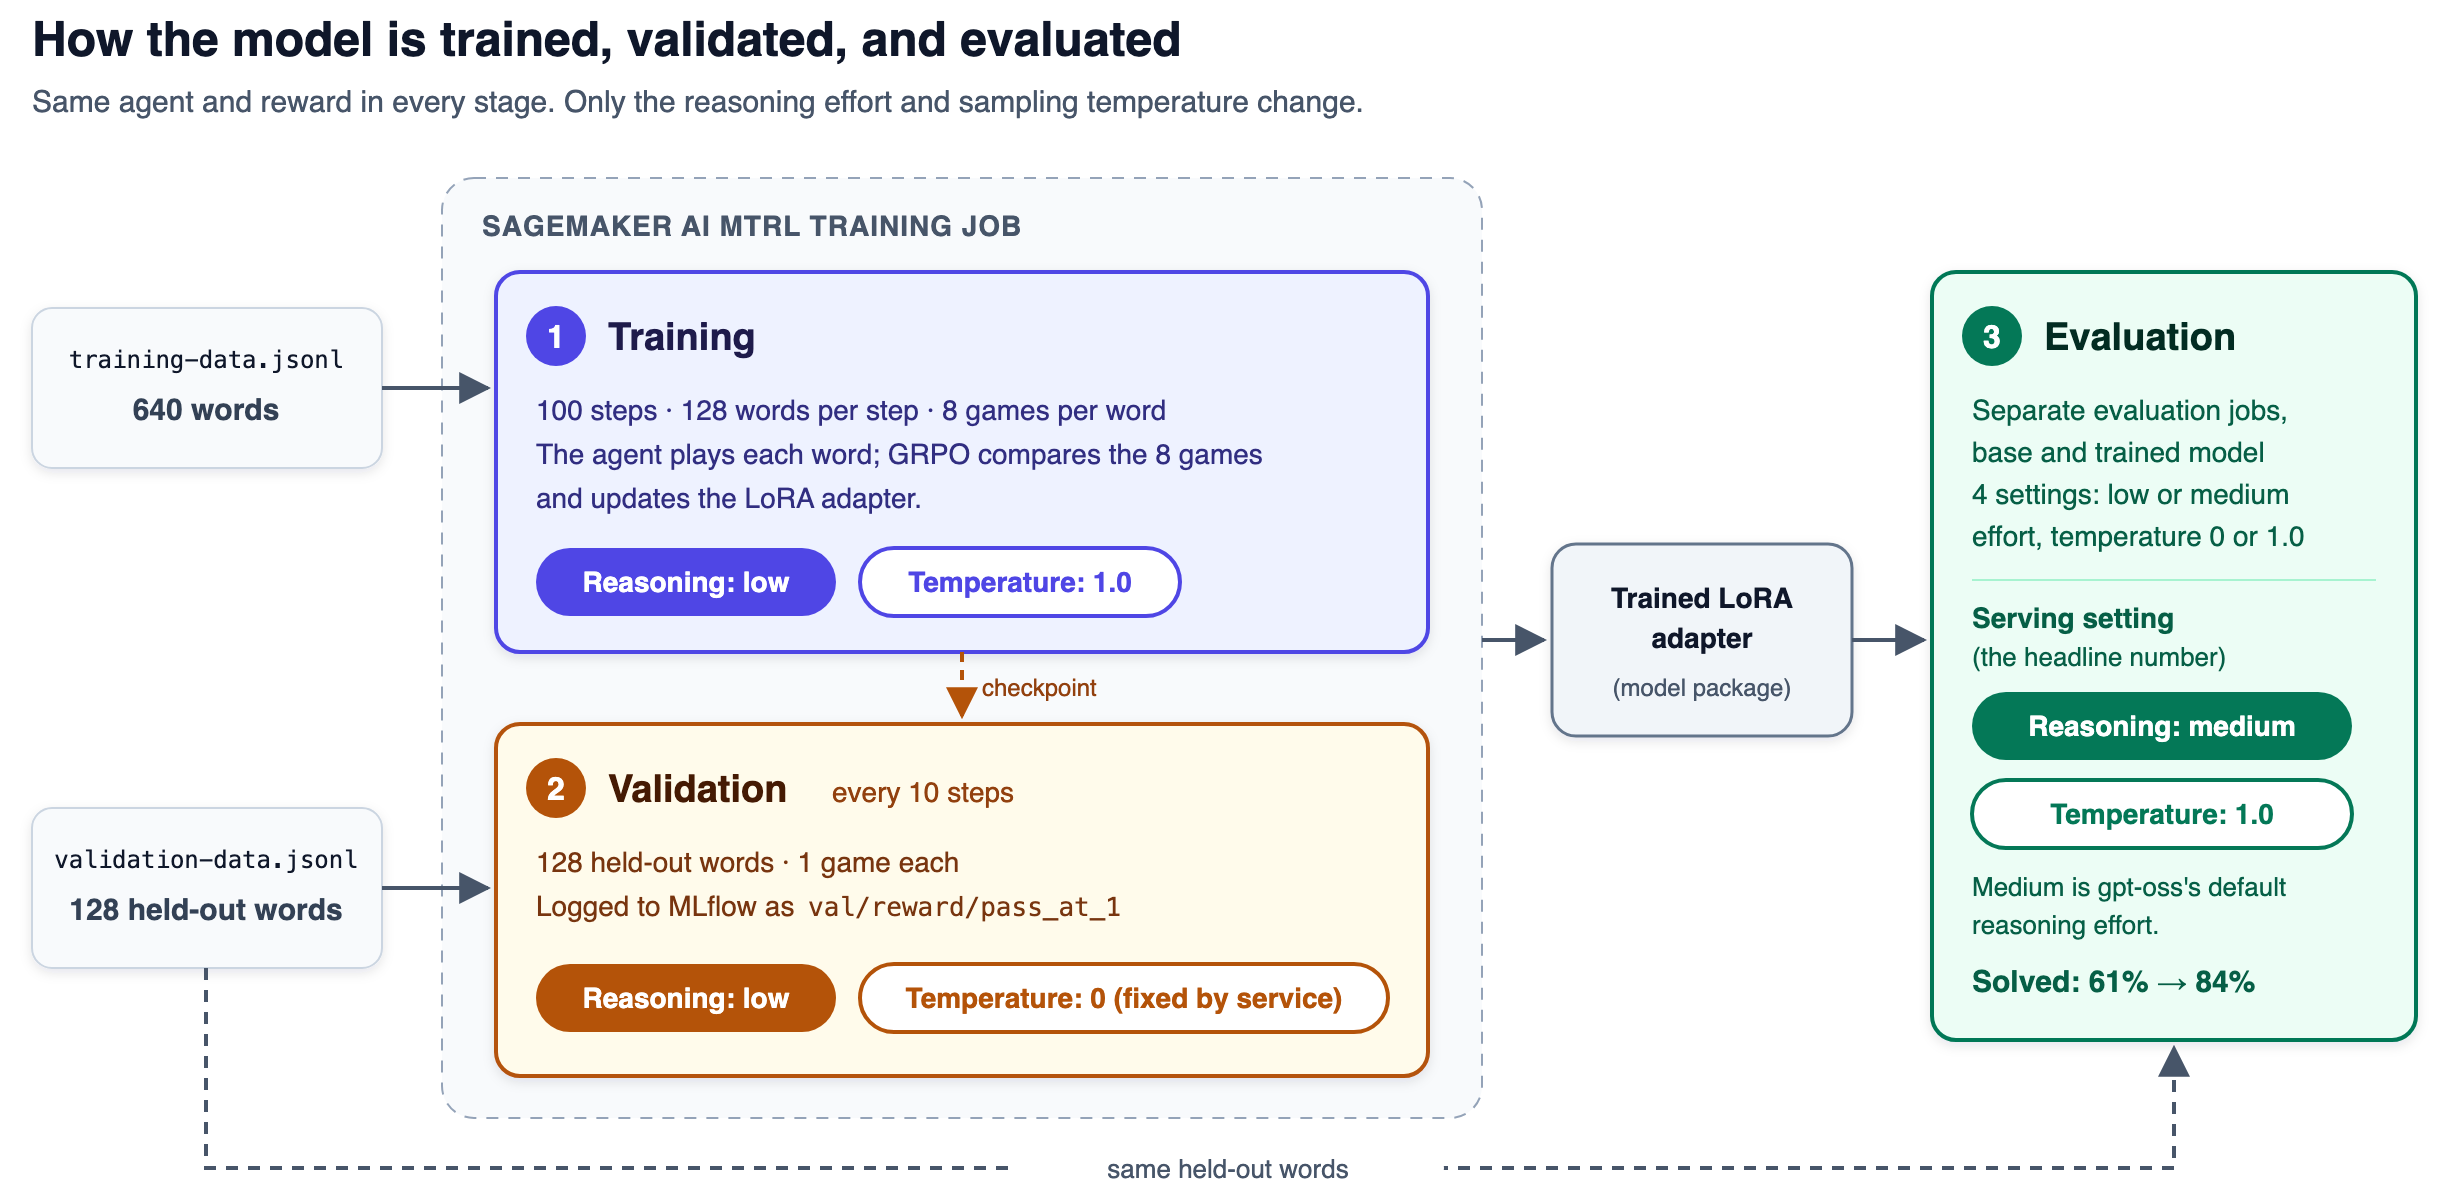
图 6:各阶段的 reasoning effort 和采样 temperature,其中训练任务把验证固定在 temperature 0 和已部署的 effort,而评估任务允许你自行选择
每次 128 个单词的评估耗时四到七分钟。reasoning effort 来自 agent 的环境变量,所以要修改它就得编辑 REASONING_EFFORT、重新部署,然后再评估。我们在 low 和 medium effort 下、temperature 0 和 1.0 下对两个模型都做了评估:
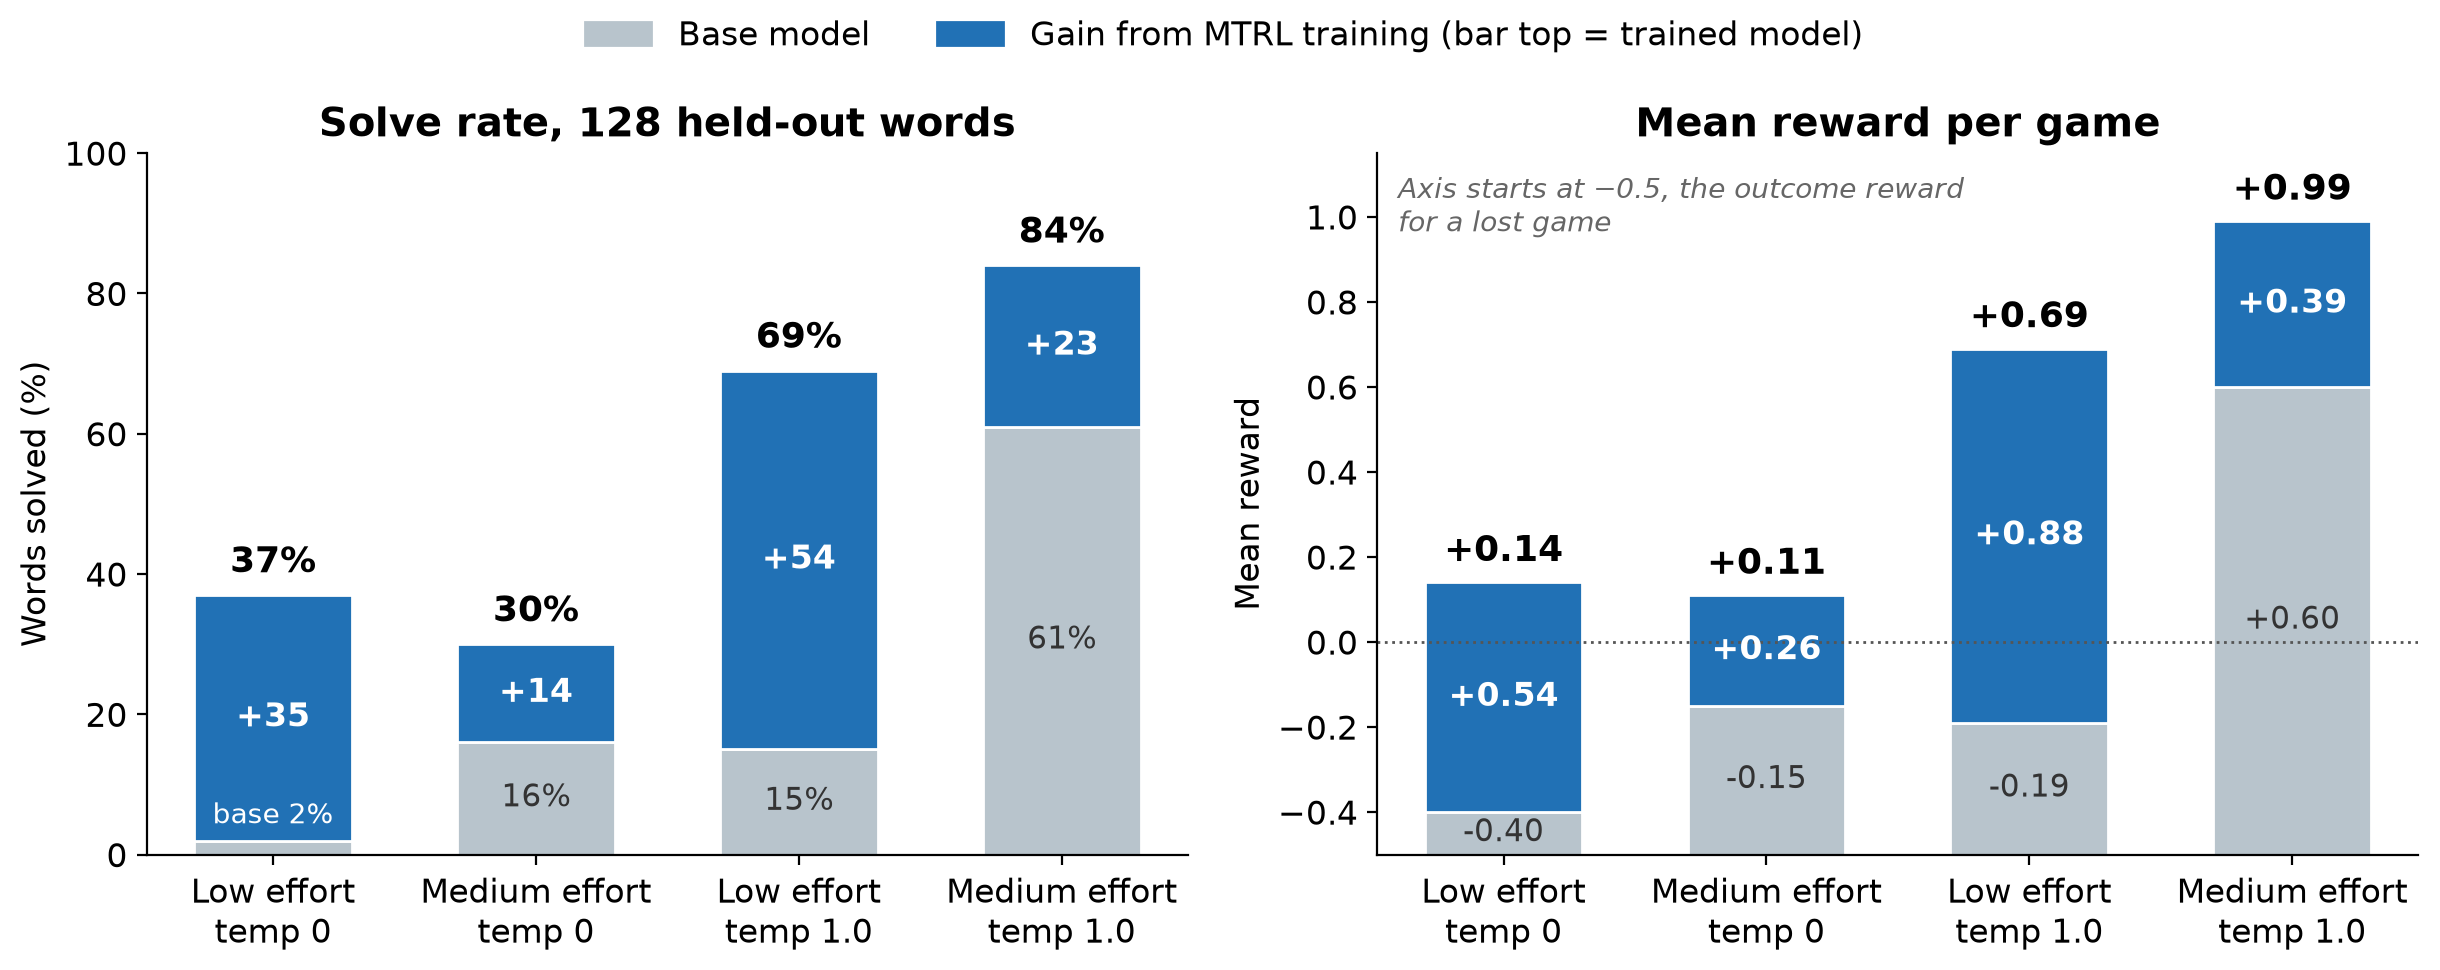
图 7:基础模型与训练模型在四种解码设置下的对比,左侧为解出率,右侧为每局平均 reward
每个柱子的灰色部分是基础模型,蓝色部分是训练带来的增益。low effort、temperature 0 这一对就是训练任务在第 0 步和第 100 步的验证结果。medium effort、temperature 1.0 下训练后模型的结果是两次运行的平均(80% 和 88%)。
在 temperature 0 下,无论哪种 effort,两个模型都常常没能解出就结束了游戏。开启采样后,medium effort 让训练后的模型提高 15 个百分点,让基础模型提高 46 个百分点。这个 adapter 在每种设置下都带来 14–54 个百分点的提升,说明训练学到的东西可以跨设置迁移。
训练任务自己在 MLflow 中的验证曲线讲的是另一个故事:它在第 90 步达到 48% 的峰值,最后停在 37%,这是按 temperature 0 打分的。超参数参考建议评估时使用 temperature 0,因为贪心解码能让曲线确定、便于跨运行比较。我们报告 temperature 1.0 的结果,因为那是我们服务模型的方式。在 medium effort、temperature 1.0 下,训练后的模型解出 84% 的留出单词,而基础模型是 61%。
提示: 在你要用于 serving 的设置下做评估。训练曲线说这个 adapter 最终停在 37%,而在 serving settings 下它能解出 84%。展示这一点所需的评估任务在 token 上花费约 1.20 美元,耗时约一小时。
第 8 步:清理
训练和评估任务完成后就停止计费,但 AgentCore runtime、它的 IAM 角色、MLflow app 以及 S3 对象会继续存在。在项目目录下执行:
1. Agent runtime and its execution role. remove all resets the project config;
the next deploy sees the empty state and tears down the deployed resources.
cd sample-multi-turn-rl-wordle/Wordle agentcore remove all agentcore deploy
2. MLflow app
aws sagemaker delete-mlflow-app --arn arn:aws:sagemaker:
3. Datasets, job output, and evaluation output
aws s3 rm s3://
由于 agentcore remove all 会重写 agentcore/ 下的文件,如果你之后还想重新部署,请运行 git checkout -- agentcore/。删除 AgentCore-Wordle-default CloudFormation stack 会移除同样的资源,但不动这些文件。训练任务角色和 model package 不计费。
深入探讨:设计 reward
我们的 reward 需要一次修订,而这个错误很常见。
第一版设计把 wordle-lora-rl 项目里逐次猜测的打分在整个对局上求和。那种打分在那个项目里可行,是因为每次猜测都是一个独立的训练样本。把它求和成每局一个 reward 之后,产生了两个倒挂,而我们只是靠读 trace 才发现:
输掉的对局给了正的 reward。 六轮的加分累计到约 +0.49。 第 1 次就解出反而比第 3 次解出得分更低。 第一次猜中就解出得 +0.99,第三次猜中解出得 +1.61,因为多出来的轮次收集了更多加分。
修正的办法是把一个占主导的结果项与一个小而有界的 shaping 项分开:
reward = outcome + w * clip(shaping, -1, 1), w = 0.04 if solved, else 0.15
结果项完全由对局如何结束决定:
结果取值 在第 n 次猜中解出1.05 + 0.5 * (6 – n) / 5,即第 1 次猜中为 1.55,到第 6 次猜中降为 1.05 猜完六次仍未解出-0.5 从未做出有效猜测-1.5
shaping 项就是那个逐次猜测的打分,在整个对局上求和:
对与已知的绿色、黄色或灰色字母相矛盾、重复猜测、以及使用词典之外单词的惩罚。 对强开局单词的熵奖励。 对尝试新字母以及缩小剩余可能性集合的加分。
该求和会被裁剪到 [-1, 1],并在解出时乘 0.04、失败时乘 0.15,这样它既能区分结果相同的对局,又永远不会把一局推进另一个档位。以典型的 shaping 取值为例:
场景Reward 第 1 次猜中解出+1.550 第 3 次猜中解出+1.375 第 6 次猜中解出+1.069 猜完六次后失败-0.427 从未做出有效猜测-1.500
现在更快的解出总是胜过更慢的解出,每次解出都胜过每次失败,而从不真正出手是最差的结果。我们最初的那次修正用了单一权重 0.15,结果一次拿满 shaping 的第 3 次解出(+1.45)反超了一次 shaping 最小的第 2 次解出(+1.25)。相邻猜测次数之间只差 0.1,所以把解出权重降到 0.04 就消除了重叠,而最差的解出(+1.01)仍能越过 1.0 的成功阈值。shaping 仍然重要,因为 GRPO 从同一组内的 reward 方差中学习,所以两局都输了但线索一致性不同的对局仍能教模型一些东西。正如 SageMaker AI 文档所建议的,从基于结果的 reward 开始,谨慎地加入 shaping,并在真实轨迹上检查 reward。
深入探讨:哪里出了错,按你会踩到的顺序
下面每一项都至少让一次训练运行失败。
并发下的 bearer token。 每次调用都用新的 botocore session 去铸造 token,在 32 个并发 rollout 时把凭证提供方拖垮了;而把 token 缓存一小时,又会在凭证轮换时返回 403 错误。解决办法是用一个会自我刷新的 session、短缓存,并在遇到 403 时重新签名。 一次始终到不了 policy model 的 rollout 会让整个任务失败。 当某次 rollout 中所有模型调用都身份验证失败时,服务会以“No sampling requests were received”结束任务。返回错误状态同样会导致失败,所以永远要返回一个 reward。模型被采样但始终没做出有效猜测的对局是可以的:它得 -1.5 分,而那次 100 步的运行在约 105,000 次 rollout 中有 51 次这样的对局。 工具调用退化成纯文本。 学习率过高时,模型把工具调用写成文本,每次 rollout 都拿到同样的地板 reward,梯度随之消失。现在 agent 会从原始文本中恢复猜测,并施加一个小的格式惩罚。 平台期。训练 reward 在约第 15 步之后停止上升,验证在约第 30 步之后停止改善,不过在 temperature 0 下验证会低估模型(第 7 步)。 我们接下来会尝试用带先验猜测的课程(curriculum)来给对局做种子,或者为每个单词使用比默认 group_size 8 更多的 rollout。
结论
SageMaker AI 上的 MTRL 用整个 episode 的结果来训练模型。这适合 agentic 任务——在那类任务中正确轨迹是未知的,只有结果可以被打分。我们用的是单一的 episode 级 reward。当中间步骤也能被打分时,MTRL 还通过 UpdateReward API 接受每轮一个 reward。在本文中,一个开放权重的 20B 模型在 serving settings 下达到了 84% 的解出率,高于 61%,训练 token 花费约 339 美元,AgentCore runtime 用量约 79 美元。训练曲线报告的 37% 只是训练任务给验证打分方式的产物,所以要按你实际 serving 的设置来做评估。
同一套流水线适用于公开模型从未训练过的内部流程、工具和工作流。
要开始使用,请克隆示例仓库,按前面的步骤操作,并在投入 GPU 时间之前先跑通第 3 步的 smoke test。底层 API 见 SageMaker AI MTRL 文档。
关于作者